Recherche
Les paramètres de ressources de 66 tâches de Terminal-Bench
Langue: Français
Les 66 tâches de Terminal-Bench v4.1.0 déclarent des paramètres de ressources différents. Le relevé de leurs fichiers de configuration montre que 31 tâches spécifient plus de 4 096 MB de mémoire et 22 plus de deux CPU. Nous avons constitué un profil de comparaison à partir des valeurs explicites les plus fréquentes pour les CPU, la mémoire, le stockage et les GPU. Ce profil est inférieur à au moins une valeur déclarée pour 38 tâches. Ces différences indiquent quels paramètres conserver ou documenter lors de la préparation d’environnements isolés pour une évaluation. Elles ne prédisent ni la consommation de ressources ni les échecs des tâches.
Si vous exécutez le même benchmark dans un nouvel environnement, quelles conditions retrouverez-vous ? Cela dépend de la version de la tâche, de celle de l’exécuteur, des options qui remplacent les valeurs déclarées et des règles du moteur d’exécution.
La version couvre plusieurs niveaux de ressources
Nous avons examiné toutes les tâches du manifeste officiel de Terminal-Bench v4.1.0, publié le 3 novembre 2026. Le relevé porte sur les 66 tâches de cette version, chacune associée à un fichier task.toml à une révision précise du dépôt. Le dépôt contient aussi d’anciennes tâches et des fichiers auxiliaires de test qui ne font pas partie du relevé. Version et manifeste officiels
Les déclarations de l’environnement principal vont de 2 à 16 CPU et de 4 096 à 32 768 MB de mémoire. La valeur de CPU la plus fréquente est deux, avec 44 tâches. La valeur de mémoire la plus fréquente est 4 096 MB, avec 35 tâches. Les autres tâches se répartissent entre des valeurs supérieures.
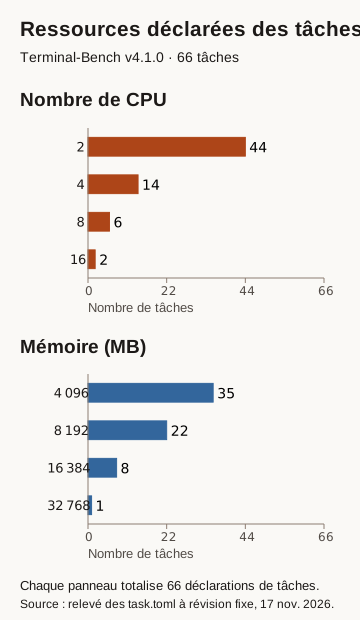
Chaque partie de la figure couvre les mêmes 66 environnements de tâche. Les valeurs proviennent des fichiers de configuration de la version. Le relevé complet contient, pour chaque tâche, une URL fixe et le hachage du fichier source.
Ces écarts comptent lorsqu’une équipe uniformise son infrastructure. Un environnement uniforme peut simplifier la planification, mais il change certaines conditions déclarées si l’exécuteur n’applique pas les valeurs propres à chaque tâche. Une dotation supérieure ne garantit pas non plus le maintien d’un plafond inférieur qui a été déclaré. La comparaison dépend des limites qu’appliquent l’exécuteur et le moteur d’exécution.
Un profil constitué de valeurs fréquentes change de nombreuses déclarations
Pour concrétiser la comparaison, nous avons retenu la valeur explicite la plus fréquente de chacun des quatre champs.
| Champ | Valeur du profil de comparaison |
|---|---|
| CPU | 2 |
| Mémoire | 4 096 MB |
| Stockage | 10 240 MB |
| GPU | 0 |
Nous avons établi ce profil pour l’analyse. Il ne correspond à aucun réglage par défaut de Harbor, à aucune recommandation d’un fournisseur ni à un déploiement observé. Les valeurs sont courantes prises séparément. Nous n’avons pas présumé que leur combinaison était la configuration complète la plus fréquente.
Pour chaque tâche, nous avons cherché au moins une valeur déclarée explicitement qui dépasse la valeur correspondante du profil. C’est le cas de 38 tâches sur 66. Le dépassement concerne 22 tâches pour les CPU, 31 pour la mémoire, 17 pour le stockage et trois pour les GPU. Ces groupes se recoupent. Les additionner compterait certaines tâches plusieurs fois. Les résultats de la comparaison donnent les identifiants exacts dans l’ensemble des tâches concernées et pour chaque champ.
Dans les 28 autres tâches, les valeurs enregistrées ne dépassent aucun des quatre seuils du profil. Cela ne suffit pas à établir leur compatibilité. Huit tâches omettent le nombre de GPU, et le relevé conserve cette omission sans la transformer en un zéro déclaré. Les fichiers, conteneurs auxiliaires, images et services peuvent aussi imposer des exigences qui ne figurent pas dans ces quatre champs.
Pour les exécutions sans GPU, les responsables du projet fournissent un jeu distinct de 63 tâches pour CPU uniquement dans Terminal-Bench 4.1.0. Exécutez-le avec harbor run -d terminal-bench/terminal-bench-cpu-only@4.1.0 et distinguez ses résultats des scores de la version complète de 66 tâches. L’inclusion dans ce jeu n’établit pas qu’une tâche respecte un plafond donné de CPU, de mémoire ou de stockage.
Avant l’exécution, consultez la liste des exceptions pour repérer les paramètres que modifierait un environnement standardisé.
De la déclaration au moteur d’exécution
Le fichier de tâche ne décrit qu’une partie de l’évaluation. Pour comprendre comment ses déclarations sont utilisées, nous avons examiné Harbor à une révision fixe dont les métadonnées du paquet indiquent la version 0.26.0.
Dans ce code, des options propres à chaque essai peuvent remplacer les valeurs de ressources d’une tâche. Les règles de CPU et de mémoire déterminent aussi si certaines valeurs sont appliquées ou ignorées. L’analyseur accepte les valeurs absentes de CPU, de mémoire et de stockage. L’environnement de base interprète un nombre de GPU omis comme un zéro effectif. Le relevé conserve les omissions d’origine pour distinguer le paramètre écrit dans la tâche de son interprétation par l’exécuteur. Logique des environnements dans la révision fixe de Harbor
Le moteur d’exécution intervient également. L’adaptateur Docker examiné traduit ses règles automatiques de CPU et de mémoire en limites. Il ignore explicitement le choix du type de GPU, et le code qui génère les ressources Compose ne fixe aucun plafond de stockage. Trois tâches de la version indiquent explicitement un H100. Ce seul champ n’établit pas que Docker en attribue un. De même, une valeur storage_mb ne suffit pas à prouver une limite de disque dans Docker. La configuration Compose peut ajouter des contraintes, et d’autres moteurs peuvent appliquer des règles différentes. Adaptateur Docker · Génération des ressources Compose
Pour rendre une évaluation reproductible, conservez la déclaration et notez ce que le moteur choisi en a fait. Le réglage demandé et l’allocation obtenue renseignent sur deux aspects de l’exécution.
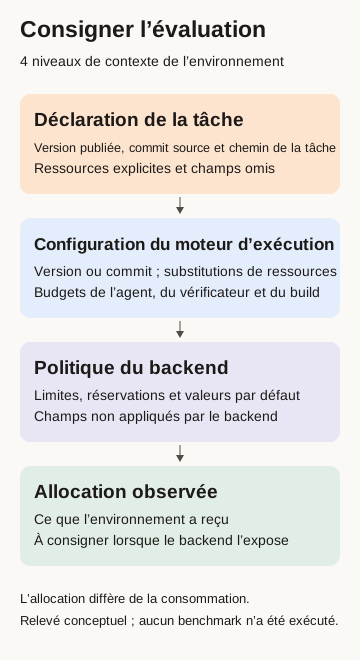
Consignez les valeurs demandées et les allocations observées dans des champs distincts.
Consigner séparément les délais de l’agent et les paramètres du vérificateur
Les 66 fichiers de tâche fixent explicitement le délai de l’agent à 28 800 secondes, soit huit heures. Il s’agit d’un maximum configuré. Les délais déclarés du vérificateur vont de 60 à 18 000 secondes, et ceux de la phase de préparation de l’environnement vont de 300 à 18 000 secondes. Gardez ces phases distinctes dans toute estimation de la durée d’une tâche.
L’exécuteur examiné peut remplacer les délais et appliquer des maximums et des multiplicateurs. L’ordre des opérations compte. La fonction examinée applique le maximum avant le multiplicateur. Notre analyse ne déduit pas la durée totale d’une exécution en additionnant les plafonds des phases. Calcul des délais à la révision examinée · Calcul du budget par phase
Nous avons calculé les délais de vérification pour les 66 tâches de Terminal-Bench v4.1.0 selon les règles de la version de Harbor que nous avons examinée. Nous avons testé séparément un maximum de 600 secondes et un délai de remplacement de 600 secondes, avec un multiplicateur de 1 dans les deux cas. Le plus grand délai calculé était de 600 secondes dans les deux cas. Le maximum a conservé les 28 délais plus courts. Le délai de remplacement a porté ces 28 délais à 600 secondes. Pour garder les délais les plus courts dans cette configuration, utilisez le maximum et notez le réglage utilisé. Comment Harbor choisit le délai initial · Comment Harbor applique le maximum et le multiplicateur
La limite de temps du job peut interrompre un agent qui tourne en local avant que son propre délai soit écoulé. Par exemple, si l’agent dispose de huit heures pour une tâche, il ne peut pas les utiliser en totalité dans un job hébergé par GitHub limité à six heures. La préparation dans ce même job prend aussi une partie du temps disponible. Consignez séparément le délai du job et celui de l’agent.
Chaque tâche sélectionne explicitement une vérification séparée. Six fournissent un bloc d’environnement pour le vérificateur. La fonction examinée dans Harbor sélectionne un bloc explicite dans son ensemble sans le fusionner champ par champ avec l’environnement de la tâche. En l’absence d’un tel bloc, elle copie l’environnement de la tâche. Les options propres à l’essai peuvent encore modifier la configuration effective du vérificateur. Sélection de l’environnement du vérificateur
Consignez les réglages de l’agent et du vérificateur séparément, même lorsqu’ils coïncident. La vérification séparée ne détermine à elle seule ni l’allocation effective ni l’utilisation simultanée de ressources par les deux environnements.
Entre Terminal-Bench 4.0 et 4.1, nous avons comparé les déclarations de CPU, de mémoire, de stockage, de GPU, de délais et de mode de vérification pour les 66 tâches dont le nom et le chemin coïncident. La comparaison a repéré deux tâches dont ces champs ont changé. Le délai de vérification est passé de 1 800 à 3 900 secondes pour distributed-dedup. Les valeurs explicites du vérificateur de payments-pipeline-fix sont passées de 6 CPU et 12 288 MB à 8 CPU et 16 384 MB. Ces chiffres décrivent les paramètres déclarés. Selon les notes de la version 4.1, les 66 tâches ont été modifiées. Cette vérification ciblée ne permet pas d’établir l’équivalence de leurs instructions, images ou vérificateurs.
Téléchargez compare-versions.py et census.json dans le même dossier. Avec Python 3.11 ou une version ultérieure et un accès à Internet, exécutez python3 compare-versions.py > comparison.json depuis ce dossier. Le script récupère la version fixe du registre 4.0 et les métadonnées des tâches sans les exécuter. Le rapport local conserve l’attribution et la demande du projet de garder ces données hors des corpus d’entraînement.
Les informations à conserver quand une configuration d’évaluation change
Le relevé permet de constituer un dossier de configuration concis.
- Fixez le jeu de tâches. Conservez ensemble le manifeste de la version, la révision du code source et les chemins des tâches. Le total de fichiers du dépôt peut inclure des éléments hors du benchmark.
- Conservez les déclarations d’origine. Notez les valeurs explicites et les omissions, y compris les paramètres propres au vérificateur et les délais de chaque phase.
- Consignez l’exécuteur et ses options. Gardez la version ou la révision exacte et les options qui remplacent ou multiplient les paramètres de la tâche.
- Vérifiez les règles du moteur. Repérez les champs interprétés comme des limites, des réservations, des valeurs par défaut ou des demandes non prises en charge.
- Notez l’allocation obtenue si elle est observable. Consignez-la séparément de la configuration demandée et de la consommation mesurée pendant l’exécution.
Si vous modifiez volontairement une limite ou une allocation, documentez le changement avec le résultat. Un lecteur pourra alors comprendre les conditions de l’évaluation et tenir compte des différences entre environnements.
La comparaison des configurations et le code de l’analyse permettent d’examiner les exceptions. sapien1 applique ce type d’examen des tâches et des environnements pour définir un projet d’évaluation d’agents.
Pour comparer d’autres plafonds, téléchargez le filtre de ressources et le relevé dans le même dossier. Par exemple, python3 filter-census.py --cpus 4 --memory-mb 8192 --status within répertorie les déclarations qui respectent ces limites dans l’environnement de la tâche comme dans celui du vérificateur. Le rapport conserve les valeurs absentes et ne détermine pas à lui seul si une tâche pourra s’exécuter. Le projet Terminal-Bench demande de garder les données du benchmark hors des corpus d’entraînement.
Comparer les tâches sélectionnées pour chaque plafond
Dans cet exemple, chaque plafond de ressources sélectionne 44 des 66 tâches de Terminal-Bench v4.1.0. Les listes ont 36 tâches en commun et 8 propres à chacune. Pour chaque plafond, le filtre compare les valeurs déclarées de processeurs, de mémoire et de stockage séparément dans l’environnement de la tâche et dans celui du vérificateur.
| Processeurs | Mémoire (MB) | Stockage (MB) | Tâches qui respectent les trois plafonds |
|---|---|---|---|
| 4 | 8 192 | 10 240 | 44 |
| 2 | 16 384 | 20 480 | 44 |
Exécutez les deux commandes depuis le dossier qui contient le filtre et le recensement. Dans chaque rapport, les champs task de records indiquent les identifiants sélectionnés.
python3 filter-census.py --cpus 4 --memory-mb 8192 \
  --storage-mb 10240 --phases both --status within > ceiling-4cpu.json

python3 filter-census.py --cpus 2 --memory-mb 16384 \
  --storage-mb 20480 --phases both --status within > ceiling-2cpu.json
Lorsque vous communiquez un score, conservez les identifiants exacts des tâches avec la version du benchmark et les paramètres de ressources. Si vous comparez deux exécutions sur leurs tâches communes, calculez les deux scores sur cette même liste.
Méthode et périmètre
Le 17 novembre 2026, nous avons achevé le relevé des déclarations de configuration d’une seule version. Il décrit ces déclarations sans mesurer les performances. La source du jeu de données Terminal-Bench est la révision 4070d6c. La source Harbor examinée est la révision ec6aeab, identifiée comme la version 0.26.0 dans les métadonnées du projet. La méthode donne les hachages complets, les liens vers les sources, les règles d’extraction et les commandes de reproduction.
Le collecteur lit le manifeste officiel et 66 fichiers TOML, soit 85 966 octets de données source. Il conserve les champs de version séparément et recherche les anciens alias de ressources, les étapes et les blocs d’environnement supplémentaires. Il n’a trouvé ni étape ni ancien alias de ressources dans cette version. Les téléchargements publics contiennent des paramètres sélectionnés et des hachages de fichiers source. Les instructions, les solutions et les environnements complets des tâches restent hors des téléchargements.
Nous avons vérifié indépendamment le contenu du manifeste, les calculs et des exemples de fichiers source comprenant un cas atypique, un champ GPU omis et un bloc de vérification explicite. Nous n’avons exécuté ni modèle, ni conteneur, ni tâche du benchmark.