Výzkum
Nastavení prostředků v 66 úlohách Terminal-Bench
Jazyk: Čeština
Terminal-Bench v4.1.0 uvádí pro svých 66 úloh různá nastavení prostředků. Srovnání konfiguračních souborů ukázalo, že 31 úloh uvádí více než 4 096 MB paměti a 22 více než dva procesory. Z nejčastějších explicitních hodnot počtu procesorů, paměti, úložiště a GPU jsme sestavili srovnávací konfiguraci. U 38 úloh je alespoň jedna deklarovaná hodnota vyšší než její protějšek v této konfiguraci. Rozdíly pomáhají určit, která nastavení zachovat nebo zaznamenat při přípravě izolovaných prostředí pro vyhodnocení. Nepředpovídají spotřebu prostředků ani selhání úlohy.
Které podmínky budou platit při spuštění stejného benchmarku v novém prostředí? Záleží na verzi úlohy, verzi spouštěcího programu, volbách přepisujících nastavení a pravidlech prováděcího prostředí.
Vydání zahrnuje úlohy s různými deklaracemi prostředků
Prošli jsme všechny úlohy z oficiálního manifestu Terminal-Bench v4.1.0, který vyšel 3. listopadu 2026. Přehled zahrnuje všech 66 úloh vydání, každou se souborem task.toml v pevně určené revizi zdroje. Repozitář obsahuje i starší úlohy a pomocné soubory pro testování, které do přehledu nepatří. Oficiální vydání a manifest
Deklarované hodnoty hlavního prostředí se pohybují od 2 do 16 procesorů a od 4 096 do 32 768 MB paměti. Dva procesory jsou nejčastější hodnota, uvedená ve 44 úlohách. U paměti je nejčastější hodnota 4 096 MB, uvedená ve 35 úlohách. Ostatní úlohy mají vyšší hodnoty.
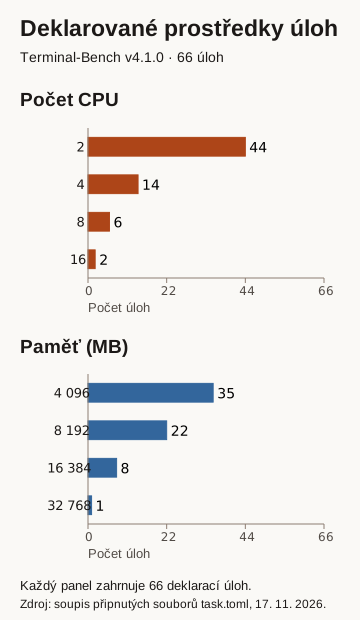
Obě části obrázku pokrývají stejných 66 prostředí úloh. Hodnoty pocházejí z konfiguračních souborů vydání. Úplné údaje uvádějí u každé úlohy adresu pevné revize a kontrolní otisk zdrojového souboru.
To je důležité při sjednocování infrastruktury. Jednotné prostředí může usnadnit plánování, ale mění některé deklarované podmínky, pokud spouštěcí program nepoužije nastavení konkrétní úlohy. Více dostupného hardwaru také automaticky nezachovává nižší deklarovaný limit. Srovnání závisí na tom, jaké limity spouštěcí program a prováděcí prostředí skutečně uplatňují.
Konfigurace z běžných hodnot mění řadu deklarací
Srovnávací konfiguraci jsme sestavili z nejčastější výslovně uvedené hodnoty v každém ze čtyř polí.
| Pole | Hodnota ve srovnávací konfiguraci |
|---|---|
| Procesory | 2 |
| Paměť | 4 096 MB |
| Úložiště | 10 240 MB |
| GPU | 0 |
Konfiguraci jsme sestavili pro tuto analýzu. Nejde o výchozí nastavení Harboru, doporučení dodavatele ani pozorované nasazení. Jednotlivé hodnoty jsou časté. Celá kombinace se může vyskytovat s jinou četností.
U každé úlohy jsme ověřili, zda alespoň jedna výslovně uvedená hodnota překračuje odpovídající srovnávací hodnotu. Stalo se tak u 38 z 66 úloh. Počet podle polí je 22 u procesorů, 31 u paměti, 17 u úložiště a tři u počtu GPU. Skupiny se překrývají, takže prostý součet by některé úlohy započítal opakovaně. Výsledky srovnání obsahují přesné identifikátory úloh ze sjednocení skupin i pro každé pole.
U zbývajících 28 úloh žádná zaznamenaná hodnota nepřekračuje uvedené čtyři srovnávací hodnoty. To samo o sobě nepotvrzuje jejich slučitelnost s konfigurací. Osm úloh počet GPU neuvádí a přehled zachovává neuvedené pole místo deklarované nuly. Soubory, pomocné kontejnery, obrazy a služby mohou klást nároky i mimo tato čtyři pole.
Pro spouštění bez GPU správci zpřístupnili samostatný soubor 63 úloh pouze pro CPU v Terminal-Bench 4.1.0. Spusťte ho příkazem harbor run -d terminal-bench/terminal-bench-cpu-only@4.1.0 a výsledky označte odděleně od skóre plného vydání se 66 úlohami. Zařazení úlohy do této sady neukazuje, zda splní konkrétní limit procesorů, paměti nebo úložiště.
Pomocí seznamu výjimek si před spuštěním ověřte, která nastavení by jednotné prostředí změnilo.
Deklaraci vykládá spouštěcí program i prováděcí prostředí
Soubor úlohy popisuje část nastavení vyhodnocení. Abychom zjistili, jak se deklarace používají, prošli jsme pevně určenou revizi Harboru, kde metadata balíčku uvádějí verzi 0.26.0.
Volby konkrétního pokusu mohou v prohlédnutém kódu přepsat hodnoty prostředků úlohy. Pravidla pro procesory a paměť mohou také rozhodnout, zda se hodnoty použijí, nebo přeskočí. Analyzátor ponechává vynechané hodnoty procesorů, paměti a úložiště nenastavené. Základní prostředí vykládá chybějící počet GPU jako efektivní nulu. Přehled zachovává původní vynechání, aby šlo odlišit nastavení v souboru úlohy od jeho výkladu spouštěcím programem. Logika prostředí v prohlédnuté revizi Harboru
Výsledek ovlivňuje také prováděcí prostředí. Prohlédnutý adaptér Dockeru převádí automatická pravidla pro procesory a paměť na limity. Výslovně ignoruje výběr typu GPU a kód zapisující prostředky Compose nenastavuje limit úložiště. Tři úlohy ve vydání výslovně uvádějí H100. Samotné pole nepotvrzuje, že Docker jednu přidělí. Ani hodnota storage_mb sama o sobě neprokazuje limit disku v Dockeru. Nastavení Compose může přidat omezení a jiná prováděcí prostředí mohou hodnoty zpracovávat jinak. Adaptér Dockeru · Zápis prostředků Compose
Aby bylo možné vyhodnocení zopakovat, zachovejte deklaraci a zaznamenejte, jak ji zvolené prostředí uplatnilo. Požadované nastavení a skutečně přidělené prostředky odpovídají na různé otázky.
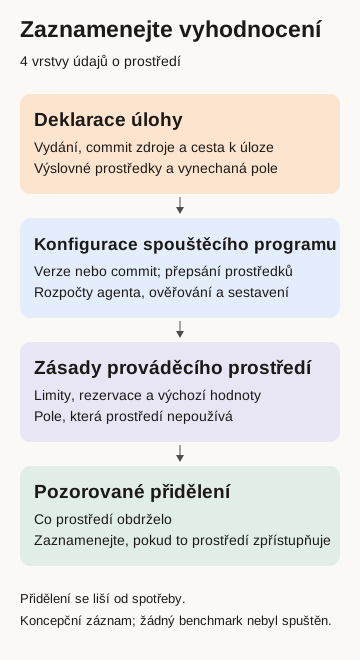
Zaznamenejte požadovaná nastavení a pozorované přidělení do samostatných polí.
Zaznamenávejte zvlášť časové limity agenta a nastavení ověřování
Všech 66 souborů úloh výslovně nastavuje časový limit agenta na 28 800 sekund, tedy osm hodin. Jde o nastavené maximum. Deklarované limity pro ověřování sahají od 60 do 18 000 sekund a pro sestavení prostředí od 300 do 18 000 sekund. Při odhadu trvání úlohy tyto fáze rozlišujte.
Prohlédnutý spouštěcí program může časové limity přepsat a použít maxima a násobitele. Prohlédnutá funkce uplatní maximum před násobitelem. Analýza nesčítá horní hranice jednotlivých fází k předpovědi celkového času. Určení časových limitů v prohlédnuté revizi · Výpočet časového rozpočtu fází
Podle pravidel pro časové limity ve verzi Harboru, kterou jsme prověřili, jsme vypočítali limity ověřování pro všech 66 úloh Terminal-Bench v4.1.0. Samostatně jsme vyzkoušeli maximum 600 sekund a přepsání limitu na 600 sekund. V obou případech byl násobitel 1. Nejvyšší vypočtený limit byl v obou případech 600 sekund. Maximum zachovalo 28 kratších limitů. Přepsání všech těchto 28 limitů zvýšilo na 600 sekund. Chcete-li v tomto nastavení kratší limity úloh zachovat, použijte maximum a zaznamenejte použité nastavení. Jak Harbor vybírá výchozí časový limit · Jak Harbor uplatňuje maximum a násobitel
Časový limit nadřazeného běhu může zastavit lokálně běžícího agenta dřív, než vyprší jeho vlastní limit. Například agent, který má na úlohu vyhrazených osm hodin, nemůže celý tento čas využít v rámci šestihodinové úlohy na hostovaném runneru GitHubu. Příprava v rámci téže úlohy také ukrajuje z dostupného času. Časový limit hostované úlohy a časový limit agenta zaznamenávejte zvlášť.
Každá úloha výslovně volí oddělené ověřování. Šest úloh obsahuje blok pro ověřovací prostředí. Prohlédnutá funkce Harboru vybere výslovně zadaný blok jako celek a neslučuje jeho pole s prostředím úlohy. Pokud samostatný blok chybí, zkopíruje prostředí úlohy. Volby konkrétního pokusu mohou výsledné nastavení ověřování dále změnit. Výběr ověřovacího prostředí
Nastavení agenta a ověřování zaznamenávejte zvlášť, i když se shodují. Samostatné ověřování samo o sobě neříká, jak se prostředky skutečně přidělily, ani zda obě prostředí spotřebovávají prostředky současně.
Porovnali jsme vybrané deklarace procesorů, paměti, úložiště, GPU, časových limitů a režimu ověřování mezi Terminal-Bench 4.0 a 4.1 pro 66 úloh se shodnými názvy a cestami. Srovnání ukázalo u těchto polí změny ve dvou úlohách. U distributed-dedup se limit ověřovatele prodloužil z 1 800 na 3 900 sekund. U payments-pipeline-fix se explicitní nastavení ověřovacího prostředí změnilo ze 6 procesorů a 12 288 MB na 8 procesorů a 16 384 MB. Jde o deklarované hodnoty. Podle poznámek k vydání 4.1 se změnilo všech 66 úloh. Toto dílčí srovnání neurčuje, zda jsou pokyny, obrazy nebo ověřovatelé rovnocenní.
Stáhněte compare-versions.py a census.json do stejné složky. S Pythonem 3.11 nebo novějším a připojením k internetu z ní spusťte python3 compare-versions.py > comparison.json. Skript načítá registr verze 4.0 z pevně určené revize a metadata úloh, aniž by je spouštěl. Místní výstup zachovává uvedení zdroje i jeho žádost nezařazovat data benchmarku do trénovacích korpusů.
Co uchovat při změně nastavení vyhodnocení
Přehled slouží jako podklad pro stručný záznam konfigurace.
- Zafixujte sadu úloh. Uchovejte spolu manifest vydání, revizi zdroje a cesty k úlohám. Celkový počet souborů v repozitáři může zahrnovat materiály mimo vydání.
- Zachovejte původní deklarace. Zaznamenejte výslovné hodnoty i vynechaná pole, včetně samostatného nastavení ověřování a časových limitů jednotlivých fází.
- Zaznamenejte spouštěcí program a jeho volby. Uložte přesnou verzi nebo revizi a volby, které hodnoty úloh přepisují nebo násobí.
- Prověřte pravidla prováděcího prostředí. Zjistěte, která pole se promítají do limitů, rezervací, výchozích hodnot nebo nepodporovaných požadavků.
- Zaznamenejte skutečný příděl, pokud ho lze zjistit. Veďte jej odděleně od požadované konfigurace a spotřeby naměřené během běhu.
Záměrnou změnu limitu nebo přidělení zaznamenejte u výsledku. Pozdější čtenář tak může pochopit podmínky vyhodnocení a zohlednit rozdíly mezi prostředími.
Srovnání konfigurací a kód analýzy umožňují zkontrolovat výjimky. sapien1 tímto způsobem prověřuje úlohy a prostředí při určování rozsahu projektů pro vyhodnocení agentů.
Pro porovnání jiných limitů stáhněte filtr prostředků a data přehledu do téže složky. Například python3 filter-census.py --cpus 4 --memory-mb 8192 --status within vypíše úlohy, jejichž deklarace pro úlohu i ověřování se do těchto limitů vejdou. Výstup zachovává vynechané hodnoty a sám neprokazuje, že úloha poběží. Terminal-Bench žádá, aby data benchmarku zůstala mimo trénovací korpusy.
Porovnejte úlohy vybrané při jednotlivých limitech
Obě příkladové sady limitů prostředků vybírají 44 z 66 úloh v Terminal-Bench v4.1.0. Seznamy sdílejí 36 úloh a každý obsahuje 8 úloh, které v druhém nejsou. Pro každou sadu limitů filtr kontroluje deklarovaný počet CPU, velikost paměti a úložiště zvlášť v prostředí úlohy a zvlášť v ověřovacím prostředí.
| Počet CPU | Paměť (MB) | Úložiště (MB) | Úlohy splňující všechny tři limity |
|---|---|---|---|
| 4 | 8 192 | 10 240 | 44 |
| 2 | 16 384 | 20 480 | 44 |
Spusťte oba příkazy ze složky s filtrem a soupisem. V každém výstupu uvádějí pole task v records identifikátory vybraných úloh.
python3 filter-census.py --cpus 4 --memory-mb 8192 \
  --storage-mb 10240 --phases both --status within > ceiling-4cpu.json

python3 filter-census.py --cpus 2 --memory-mb 16384 \
  --storage-mb 20480 --phases both --status within > ceiling-2cpu.json
Při vykazování skóre uložte přesné identifikátory úloh spolu s verzí benchmarku a nastavením prostředků. Pokud porovnáváte dva běhy na společných úlohách, vypočítejte obě skóre ze stejného seznamu.
Metoda a rozsah
Dne 17. listopadu 2026 jsme dokončili úplný přehled konfiguračních deklarací v jednom vydání. Přehled mapuje tato nastavení a neměří výkon. Zdrojem dat Terminal-Bench je revize 4070d6c. Prohlédnutá revize Harboru je ec6aeab, označená v metadatech projektu jako verze 0.26.0. Metodika obsahuje celé kontrolní otisky, odkazy na zdroje, pravidla pro výběr údajů a příkazy pro opakování analýzy.
Sběrný skript čte oficiální manifest a 66 souborů TOML, celkem 85 966 bajtů ve zdroji. Pole verzí uchovává samostatně a kontroluje starší aliasy prostředků, kroky a další bloky prostředí. V tomto vydání nenašel žádné kroky ani starší aliasy prostředků. Veřejné soubory ke stažení obsahují vybrané konfigurační údaje a otisky zdrojů. Nepatří do nich pokyny k úlohám, řešení ani úplná prostředí.
Nezávisle jsme ověřili členství v manifestu, výpočty a ukázky ze zdrojů s odlehlou hodnotou, vynechaným polem GPU a výslovně zadaným ověřovacím blokem. Nespouštěli jsme žádné modely, kontejnery ani úlohy benchmarku.