Výzkum
Výběr podle referenčních souborů mění složení veřejných úloh GDPval
Jazyk: Čeština
Skóre benchmarku se snáze interpretuje, když víte, které úlohy do něj mohly vstoupit. Ve veřejné zlaté tabulce úloh GDPval připadá na každé ze 44 povolání na začátku pět úloh. Porovnání, které vyžaduje uvedený referenční soubor od experta, však nemůže použít každý řádek tabulky stejným způsobem: 35 z 220 řádků má prázdný seznam deliverable_files.
Tento celkový počet již uvádí implementace GDPval v gbench. Zjistili jsme, jak jsou prázdné seznamy rozloženy mezi odvětví a povolání ve stejném snímku GDPval s pevně určenou revizí. Všech 44 povolání má stále alespoň jeden řádek s uvedeným souborem. Zbývající úlohy však nejsou rozloženy tak rovnoměrně jako ve výchozí tabulce.
U kterých úloh je uveden soubor s řešením od odborníka?
Tyto počty vyjadřují pouze to, zda tabulka uvádí alespoň jednu cestu k výstupu experta. Uvedená cesta nedokazuje, že je soubor dostupný nebo že jej lze vykreslit. Prázdný seznam neříká, zda referenční výstup existuje někde mimo tuto tabulku.
| Odvětví | Řádky ve veřejné zlaté tabulce | S uvedeným výstupem | S prázdným seznamem |
|---|---|---|---|
| Finance a pojišťovnictví | 25 | 17 | 8 |
| Veřejná správa | 25 | 22 | 3 |
| Zdravotní a sociální péče | 25 | 22 | 3 |
| Informační činnosti | 25 | 14 | 11 |
| Zpracovatelský průmysl | 25 | 25 | 0 |
| Odborné, vědecké a technické činnosti | 25 | 24 | 1 |
| Činnosti v oblasti nemovitostí a pronájem | 25 | 20 | 5 |
| Maloobchod | 20 | 16 | 4 |
| Velkoobchod | 25 | 25 | 0 |
| Celkem | 220 | 185 | 35 |
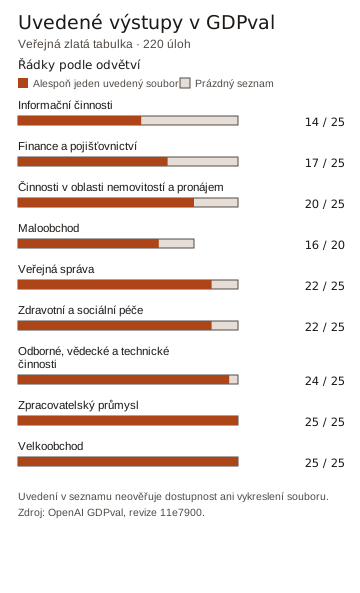
Sloupce ukazují uvedení v seznamu, nikoli ověřenou dostupnost či vykreslitelnost souboru.
Tabulka obsahuje 44 skupin podle povolání a odvětví, každou s pěti úlohami. V tomto výběru si 22 z nich ponechává všech pět řádků a 22 si ponechává dva až čtyři. Každé povolání je stále zastoupeno, ale samotné zastoupení už neznamená, že mají všechna stejný počet úloh.
Rozdíl mezi odvětvími pomáhá při interpretaci souhrnného výsledku. Na informační činnosti i zpracovatelský průmysl připadá po 25 z původních 220 řádků, tedy 11,4 %. V hypotetickém souhrnu s rovnou vahou úloh, který by zahrnoval právě 185 řádků s neprázdným seznamem, by na informační činnosti připadalo 14/185, tedy 7,6 %, a na zpracovatelský průmysl 25/185, tedy 13,5 %. Jde o podíly úloh, nikoli o skóre modelů nebo odhady hodnoty jednotlivých povolání.
Dokáže hodnotitel přečíst referenční soubory?
Výpočet zahrnující 185 řádků nepředstavuje konečný jmenovatel pro výpočet skóre v gbench. Dokumentace popisuje další čtyři úlohy, jejichž uvedené výstupy nelze převést na text, takže v daném snímku zbývá 181 úloh s referenčním výstupem převoditelným na text. Tyto soubory jsme samostatně nepřeváděli ani jsme nespustili gbench.
I bez znalosti odvětví, do nichž tyto čtyři úlohy patří, počty užitečně vymezují dokumentovaný soubor s referenčními výstupy převoditelnými na text. Pokud jde o čtyři různé řádky ze 185 řádků s neprázdným seznamem, zůstává alespoň 21 řádků zpracovatelského průmyslu a nejvýše 14 řádků informačních činností. Při stejné váze úloh činí tyto hranice 21/181 (11,6 %) a 14/181 (7,7 %). Při skutečném běhu se jmenovatel pro výpočet skóre může lišit, protože záleží také na selháních generování, selháních hodnotitele a počtu pokusů na úlohu. Tyto počty nepopisují původní výsledky OpenAI hodnocené lidmi.
Jiné metody hodnocení mají odlišné požadavky. V dokumentovaném režimu hodnocení podle rubriky v NeMo Gym při commitu 5d6429f hodnotitel využívající LLM posuzuje kandidátní výstup podle hodnoticí rubriky úlohy. Přípravný kód nekopíruje seznam deliverable_files s výstupy expertů, zatímco ověřovač rubriky vrací missing_rubric, pokud jsou obě pole rubriky prázdná. Všechny uvedené vstupní soubory úlohy je nutné připravit a stále je zapotřebí kandidátní výstup i hodnotitel; volání přípravy nepřiřazuje datasetu pevnou revizi. NeMo Gym jsme nespustili ani jsme neměřili jeho pokrytí. Skóre podle rubriky a podíl výher nebo remíz v gbench jsou odlišné ukazatele.
Co hodnotitel vidí
Dostupnost referenčního výstupu je jen jednou částí porovnání. Dokumentace gbench již uvádí, že 32 z 220 rubrik překračuje výchozí limit 8 000 znaků. Formátovací funkce zachovává celá kritéria v původním pořadí, dokud by další kritérium limit nepřekročilo, a poté přidá značku zkrácení; pokud limit překračuje už první kritérium, zobrazí jen jeho část. Počet znaků není počet tokenů.
Na tabulku úloh jsme použili formátovací funkci z pevně určené revize. Mezi 185 řádky s uvedeným výstupem experta by se při výchozím limitu zkrátilo 26 rubrik a v těchto řádcích by celkem chybělo 247 celých kritérií. Uvedený výstup nemusí být převoditelný na text a neúspěšná nebo prázdná generování mohou zabránit volání hodnotitele, takže nejde o počty hodnocených porovnání. Pro ilustraci: změna samotného limitu formátovací funkce na 12 000 nebo 16 000 znaků by zkrátila dvě, respektive žádnou z těchto 185 rubrik. Tato nastavení jsme neověřovali pomocí vyhodnocovacího nástroje ani hodnotitele. Počty vynechaných kritérií neurčují jejich důležitost ani to, zda by se verdikt změnil; vyšší limit může ponechat méně místa pro zbytek pevně daného kontextového okna. Prohlédněte si údaje o zkrácení zaznamenané při skutečném běhu spolu s počty referenčních výstupů a hodnocení.
Kontrola rubrik reprodukuje tyto počty pomocí DuckDB 1.4.4. Dočasně stáhne úplnou tabulku úloh z pevně určené revize a zpracuje text rubrik v paměti; její výstup uchovává souhrnné počty, nikoli ID úloh nebo text rubrik. Po běžném dokončení dočasnou tabulku odstraní. Spouští pouze prověřenou formátovací funkci z gbench s ověřeným hashem, a to v omezeném jmenném prostoru, který není bezpečnostním sandboxem. Archiv obsahuje licenci a oznámení původního projektu. Po nastavení DuckDB uvedeném níže vytvořte prostředí pomocí Pythonu 3.11, stáhněte archiv a spusťte jej v macOS nebo Linuxu:
unzip rubric-screen.zip -d rubric-screen
.gdpval-venv/bin/python rubric-screen/rubric-screen.py > rubric-observations.json
Zaznamenejte cestu od úloh ke skóre
Při nastavení nebo porovnávání vyhodnocení zaznamenejte revizi datasetu, požadovaný typ referenčního výstupu a každé pravidlo způsobilosti. Uveďte počty podle skupin ve výchozí tabulce, po kontrolách referenčních výstupů a po hodnocení. Samostatně evidujte chybějící uvedený referenční výstup, nečitelný referenční výstup, neúspěšné generování a nepoužitelný verdikt hodnotitele. Jediný souhrnný údaj může jinak zakrýt, které úlohy přestaly do výsledku přispívat.
Uveďte také, jakou váhu mají zbývající úlohy a pokusy. Stejná váha každé úlohy, každého povolání a každého pokusu odpovídá při rozdílných počtech na jiné otázky. Žádný z těchto způsobů sám o sobě nenahradí chybějící podklady; vhodný souhrn závisí na tom, co má vyhodnocení měřit.
Pro vlastní soubor úloh ukazuje průvodce vyhodnocováním agentů, jak definovat pozorovatelné kontroly a interpretovat opakované pokusy.
Zaznamenejte přesnou verzi každého vstupního souboru
Pevně určená tabulka úloh nemusí pevně určovat každý soubor, který vyhodnocovací nástroj stáhne. Ve starší veřejné tabulce GDPval v revizi 4bf6426 uvádí vstupní soubory 122 z 220 řádků úloh. Všech 262 uvedených adres URL vstupů odkazuje na průběžně aktualizovanou větev main repozitáře. Metadata poskytovatele uvádějí, že 62 z těchto cest mělo v revizi 11e7900 jinou velikost a jiné ID blobu; těchto 62 cest se vyskytuje ve 20 řádcích starší tabulky. Jde o vstupy úloh, odlišné od referenčních výstupů expertů v deliverable_files započítaných výše.
To nedokazuje, že konkrétní vyhodnocení použilo změněný vstup, že je některý soubor poškozený nebo že se změnilo skóre. Ukazuje to však, proč pozdější použití průběžně aktualizovaných adres URL z uložené tabulky může vybrat jinou verzi vstupu. Obsah vstupních souborů jsme neanalyzovali.
V commitu 5c092d5 projektu Inspect Evals používá načítací funkce GDPval tabulku úloh pevně určenou revizí a3848a2. Tato tabulka je po jednotlivých bajtech totožná se starší tabulkou uvedenou výše a shodují se i metadata vstupních souborů od poskytovatele. Načítací funkce převádí spárované adresy URL z tabulky na mapování souborů ve vzorcích; dokumentace Inspect uvádí, že tato mapování mohou používat adresy URL. Touto cestou se tedy mohou spolu s pevně určenou tabulkou přenášet průběžně aktualizované adresy URL. Stahování ani ukládání souborů do mezipaměti v Inspect jsme netestovali a nezjišťovali jsme, co použil kterýkoli konkrétní běh.
Vyhodnocovací nástroj může místo toho vyhledávat cesty relativní k datasetu ve stejné neměnné revizi jako tabulku. Zde zkoumaná implementace gbench při načítání příloh výslovně předává svou pevně určenou revizi. Zaznamenejte revizi a tam, kde je to praktické, ověřte skutečně použité soubory. Dokumentace Hugging Face ke stahování vysvětluje, jak převést průběžně aktualizovanou revizi na commit pro konzistentní stahování.
Skript pro analýzu adres URL vstupů reprodukuje počty pomocí DuckDB 1.4.4. Starší tabulku úloh dočasně stáhne, po běžném dokončení ji odstraní a ve výstupu neuchovává text úloh, jednotlivá ID, cesty ke vstupům ani jejich obsah. Volitelný parametr kontroluje hlavičky odpovědi pro jednu cestu a aktuální revizi main; jeho výsledek se může se změnami main měnit. Při této kontrole skript odesílá pouze požadavky HEAD, a to i při přesměrování, a nedostupné výsledky zůstávají nezjištěné. Kontroly využívající standardní knihovnu Pythonu porovnávají tabulku a metadata z revize pevně určené v Inspect a zkoumají zdrojový kód načítací funkce z pevně určené revize, aniž by jej spouštěly. Kontrola hashe tabulky načte celou tabulku do paměti, ale obsah úloh neanalyzuje ani neuchovává. Skripty nepožadují těla vstupních souborů.
Po nastavení DuckDB uvedeném níže spusťte kontroly v macOS nebo Linuxu příkazem:
.gdpval-venv/bin/python input-url-revisions.py > input-url-observations.json
.gdpval-venv/bin/python inspect-dataset-check.py
.gdpval-venv/bin/python inspect-source-check.py
Jak jsme počítali
Při zjišťování dostupnosti referenčních výstupů jsme prověřili tabulku Parquet train v revizi GDPval 11e7900cdcac61bc4daf59e65feb238acda98fbf, ověřili 220 jedinečných ID úloh a seskupovali pouze podle odvětví, povolání a délky jednotlivých seznamů deliverable_files. Analytický skript kontroluje hash zdroje a reprodukuje počty pomocí DuckDB 1.4.4. Úplnou tabulku dočasně stáhne a po běžném dokončení ji odstraní; jeho výstup neuchovává zadání, rubriky, jednotlivá ID úloh, cesty k výstupům ani samotné výstupy. Nebyl spuštěn žádný model, benchmark ani nástroj pro vykreslování referenčních výstupů.
Chcete-li postup zopakovat lokálně v macOS nebo Linuxu s Pythonem 3.9 či novějším, ověřte, že python3 vybírá tuto verzi:
python3 -m venv .gdpval-venv
.gdpval-venv/bin/python -m pip install duckdb==1.4.4
.gdpval-venv/bin/python analyze.py > observations.json
sapien1 tyto skripty zpřístupňuje ke stažení a místnímu spuštění; žádná další licence k jejich úpravám či dalšímu šíření není uvedena. Na zdrojový dataset se vztahují samostatné podmínky.
OpenAI označuje zlatou podmnožinu 220 úloh jako open source. Karta datasetu z pevně určené revize obsahuje varování benchmarku před kontaminací a neobsahuje pole s licencí; ověřte si podmínky platné pro vaše vlastní použití a nevyvozujte je z označení na kartě ani z tohoto počtu. Označení odvětví a povolání i benchmark zůstávají přiřazeny svému zdroji.