Ricerca
Un filtro sui file di riferimento cambia la composizione delle attività pubbliche di GDPval
Lingua: Italiano
Un punteggio di benchmark è più facile da interpretare quando sai quali attività possono concorrere a determinarlo. Nella tabella pubblica delle attività gold di GDPval, ciascuna delle 44 professioni parte con cinque attività. Ma un confronto che richiede un file di riferimento di un esperto presente nell’elenco non può usare allo stesso modo tutte le righe della tabella: 35 righe su 220 hanno una lista deliverable_files vuota.
Questo totale è già documentato nell’implementazione di GDPval in gbench. Abbiamo contato come si distribuiscono le liste vuote tra settori e professioni nella stessa snapshot fissata di GDPval. Tutte le 44 professioni hanno ancora almeno una riga con un file elencato. La composizione delle righe rimanenti, però, non è distribuita in modo uniforme come nella tabella iniziale.
Per quali attività è indicato un file di riferimento preparato da un esperto?
Questi conteggi indicano solo se la tabella elenca almeno un percorso verso un elaborato di un esperto. Un percorso elencato non dimostra che il file sia accessibile o renderizzabile. Una lista vuota non stabilisce se esista un riferimento altrove, fuori da questa tabella.
| Settore | Righe nella tabella gold pubblica | Con un elaborato elencato | Con una lista vuota |
|---|---|---|---|
| Finanza e assicurazioni | 25 | 17 | 8 |
| Pubblica amministrazione | 25 | 22 | 3 |
| Sanità e assistenza sociale | 25 | 22 | 3 |
| Informazione | 25 | 14 | 11 |
| Industria manifatturiera | 25 | 25 | 0 |
| Servizi professionali, scientifici e tecnici | 25 | 24 | 1 |
| Attività immobiliari e noleggio | 25 | 20 | 5 |
| Commercio al dettaglio | 20 | 16 | 4 |
| Commercio all’ingrosso | 25 | 25 | 0 |
| Totale | 220 | 185 | 35 |
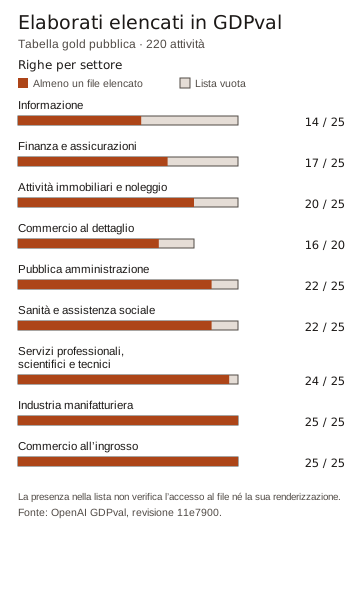
Le barre mostrano la presenza nella lista, non l’accesso verificato ai file né la loro renderizzabilità.
La tabella contiene 44 gruppi professione-settore di cinque attività ciascuno. Di questi, 22 conservano tutte e cinque le righe dopo questo filtro e 22 ne conservano da due a quattro. Ogni professione è ancora presente, ma la sola presenza non significa più che ciascuna abbia lo stesso numero di attività.
Il confronto tra settori è utile per leggere un dato aggregato. Informazione e industria manifatturiera rappresentano ciascuno 25 delle 220 righe iniziali, pari all’11,4%. In una sintesi ipotetica che attribuisca lo stesso peso a ciascuna delle 185 righe con almeno un file elencato, informazione rappresenterebbe 14/185, pari al 7,6%, e industria manifatturiera 25/185, pari al 13,5%. Sono quote di attività, non punteggi dei modelli né stime del valore delle diverse professioni.
Il sistema di valutazione riesce a leggere i file di riferimento?
Il calcolo su 185 righe non è il denominatore finale usato da gbench per il punteggio. La sua documentazione descrive altre quattro attività i cui elaborati elencati non sono renderizzabili in testo, lasciando 181 attività con un riferimento renderizzabile in quella snapshot. Non abbiamo renderizzato autonomamente quei file né eseguito gbench.
Anche senza sapere a quali settori appartengano queste quattro attività, i conteggi definiscono limiti utili per l’insieme documentato con riferimenti renderizzabili. Se si tratta di quattro righe distinte tra le 185 con almeno un file elencato, rimangono almeno 21 righe dell’industria manifatturiera e al massimo 14 di informazione. Con pesi uguali per attività, questi limiti sono rispettivamente 21/181 (11,6%) e 14/181 (7,7%). Un’esecuzione effettiva può avere un denominatore diverso per il punteggio, perché contano anche gli errori di generazione, gli errori del giudice e il numero di tentativi per attività. Questi conteggi non descrivono i risultati originali di OpenAI valutati da persone.
Altri metodi di valutazione hanno requisiti diversi. Nella modalità rubric documentata di NeMo Gym al commit 5d6429f, un giudice LLM valuta un elaborato candidato rispetto alla rubric dell’attività. Il suo codice di preparazione non copia la lista deliverable_files degli output degli esperti, mentre il suo verificatore della rubric segnala missing_rubric se entrambi i campi della rubric sono vuoti. Tutti i file di input elencati per l’attività devono essere predisposti e servono comunque un output candidato e un giudice; la chiamata di preparazione non fissa una revisione del dataset. Non abbiamo eseguito NeMo Gym né misurato la sua copertura. Il suo punteggio basato sulla rubric e il tasso di vittorie o pareggi di gbench sono misure diverse.
Cosa può vedere il giudice
La disponibilità del riferimento è solo una parte del confronto. La documentazione di gbench segnala già che 32 rubric su 220 superano il limite predefinito di 8.000 caratteri. Il suo formatter mantiene i criteri interi nell’ordine originale finché l’aggiunta del successivo non supererebbe il limite, poi aggiunge un indicatore di troncamento; se il primo criterio da solo supera il limite, ne mostra solo una parte. Il numero di caratteri non corrisponde al numero di token.
Abbiamo applicato quel formatter fissato alla tabella delle attività. Tra le 185 righe con un elaborato di un esperto elencato, 26 rubric verrebbero troncate con il limite predefinito, escludendo complessivamente 247 criteri interi. Un elaborato elencato non è necessariamente renderizzabile e generazioni fallite o vuote possono impedire una chiamata al giudice, quindi questi non sono conteggi di confronti valutati. A titolo illustrativo, modificando solo il limite del formatter a 12.000 o 16.000 caratteri verrebbero troncate rispettivamente due o nessuna di quelle 185 rubric. Non abbiamo eseguito un valutatore o un giudice con queste impostazioni. Il numero di criteri omessi non ne stabilisce l’importanza né indica se un giudizio cambierebbe; un limite più alto può lasciare meno spazio al resto di una finestra di contesto di dimensioni fisse. Esamina le informazioni sul troncamento registrate dall’esecuzione effettiva insieme ai conteggi dei riferimenti e dei punteggi.
Lo script di analisi delle rubric riproduce questi conteggi con DuckDB 1.4.4. Scarica temporaneamente la tabella completa delle attività fissata a quella revisione ed elabora il testo delle rubric in memoria; il suo output conserva conteggi aggregati, non ID delle attività o testo delle rubric. Dopo un’esecuzione normale rimuove la tabella temporanea. Esegue solo il formatter di gbench ispezionato e verificato tramite hash, in un namespace ristretto che non è una sandbox di sicurezza. L’archivio include la licenza e l’avviso del progetto originale. Dopo la configurazione di DuckDB descritta sotto, usa Python 3.11 per creare l’ambiente, scaricare l’archivio ed eseguirlo su macOS o Linux:
unzip rubric-screen.zip -d rubric-screen
.gdpval-venv/bin/python rubric-screen/rubric-screen.py > rubric-observations.json
Registra il percorso dalle attività ai punteggi
Quando imposti o confronti una valutazione, registra la revisione del dataset, il tipo di riferimento richiesto e ogni regola di ammissibilità. Riporta i conteggi per gruppo nella tabella iniziale, dopo i controlli sui riferimenti e dopo l’assegnazione dei punteggi. Distingui le ragioni: riferimento non elencato, riferimento illeggibile, generazione fallita e giudizio inutilizzabile. Altrimenti, un unico dato aggregato può nascondere quali attività hanno smesso di contribuire al risultato.
Indica anche come vengono ponderati le attività e i tentativi rimanenti. Un peso uguale per attività, per professione o per tentativo risponde a domande diverse quando i conteggi differiscono. Nessuno di questi criteri colma da solo le prove mancanti; la sintesi appropriata dipende da ciò che la valutazione intende misurare.
Per un insieme di attività che stai progettando, la guida alla valutazione degli agenti mostra come definire controlli osservabili e interpretare prove ripetute.
Annota la versione esatta di ogni file di input
Una tabella delle attività fissata a una revisione non fissa necessariamente ogni file scaricato da un valutatore. In una precedente tabella pubblica di GDPval alla revisione 4bf6426, 122 righe su 220 elencano file di input. Tutti i 262 URL di input elencati puntano al branch mobile main del repository. I metadati del provider indicano che 62 di quegli stessi percorsi avevano dimensioni e ID dei blob diversi alla revisione 11e7900; quei 62 percorsi compaiono in 20 righe della tabella precedente. Sono input delle attività, distinti dagli output di riferimento degli esperti in deliverable_files conteggiati sopra.
Questo non dimostra che una particolare valutazione abbia usato un input modificato, che un file sia danneggiato o che un punteggio sia cambiato. Mostra però perché seguire in un secondo momento gli URL mobili di una tabella salvata può portare a selezionare una versione diversa di un input. Non abbiamo analizzato il contenuto dei file di input.
Al commit 5c092d5 di Inspect Evals, il loader di GDPval fissa la tabella delle attività alla revisione a3848a2. Quella tabella è identica byte per byte alla tabella precedente e anche i metadati dei file di input del provider corrispondono. Il loader associa le coppie di URL della tabella a mappature dei file dei campioni; la documentazione di Inspect indica che queste mappature possono usare URL. Questo percorso nel codice sorgente può quindi trasportare URL mobili insieme a una tabella fissata. Non abbiamo verificato i download dei file o la cache di Inspect, né stabilito cosa abbia usato una specifica esecuzione.
Un valutatore può invece risolvere i percorsi relativi al dataset usando la stessa revisione immutabile della tabella. L’implementazione di gbench esaminata qui specifica esplicitamente la revisione fissata quando recupera gli allegati. Registra la revisione e, quando possibile, verifica i file effettivamente usati. La documentazione di Hugging Face sui download spiega come risolvere una revisione mobile in un commit per ottenere download coerenti.
Lo script di analisi degli URL di input riproduce i conteggi usando DuckDB 1.4.4. Scarica temporaneamente la tabella delle attività precedente, la rimuove dopo un’esecuzione normale e non conserva nel suo output testo delle attività, ID individuali, percorsi di input o contenuti degli input. Un flag facoltativo controlla le intestazioni della risposta per un percorso e la revisione corrente di main; il risultato può cambiare con l’avanzare di main. Per questo controllo, lo script invia solo richieste HEAD, anche attraverso i reindirizzamenti, e lascia inosservati i risultati non disponibili. I controlli della libreria standard di Python confrontano la tabella e i metadati fissati da Inspect ed esaminano il codice sorgente del loader fissato senza eseguirlo. Il controllo dell’hash della tabella legge l’intera tabella in memoria, ma non analizza né conserva il contenuto delle attività. Gli script non richiedono i corpi dei file di input.
Dopo la configurazione di DuckDB descritta sotto, esegui i controlli su macOS o Linux con:
.gdpval-venv/bin/python input-url-revisions.py > input-url-observations.json
.gdpval-venv/bin/python inspect-dataset-check.py
.gdpval-venv/bin/python inspect-source-check.py
Come abbiamo contato
Per il censimento della disponibilità dei riferimenti, abbiamo esaminato la tabella Parquet train alla revisione GDPval 11e7900cdcac61bc4daf59e65feb238acda98fbf, verificato 220 ID di attività distinti e raggruppato solo settore, professione e lunghezza di ogni lista deliverable_files. Lo script di analisi verifica l’hash della fonte e riproduce i conteggi usando DuckDB 1.4.4. Scarica temporaneamente l’intera tabella e la rimuove dopo un’esecuzione normale; il suo output non conserva prompt, rubric, ID delle singole attività, percorsi degli elaborati o elaborati. Non abbiamo eseguito modelli, benchmark o renderer dei riferimenti.
Per riprodurre i risultati in locale con Python 3.9 o versioni successive su macOS o Linux, assicurati che python3 selezioni quella versione:
python3 -m venv .gdpval-venv
.gdpval-venv/bin/python -m pip install duckdb==1.4.4
.gdpval-venv/bin/python analyze.py > observations.json
sapien1 mette questi script a disposizione per il download e l’esecuzione in locale; non è indicata alcuna licenza aggiuntiva per modificarli o ridistribuirli. I termini del dataset originale sono separati.
OpenAI descrive il sottoinsieme gold di 220 attività come open source. La scheda del dataset fissata a quella revisione contiene un benchmark canary e non riporta un campo relativo alla licenza; verifica i termini applicabili al tuo utilizzo senza dedurli da un’etichetta della scheda o da questo conteggio. Le denominazioni dei settori e delle professioni e il benchmark restano attribuiti alla loro fonte.