Forskning
Et utvalg basert på referansefiler endrer oppgavesammensetningen i GDPvals offentlige datasett
Språk: Norsk bokmål
En referansetestscore er lettere å tolke når du vet hvilke oppgaver som kunne inngå i den. I GDPvals offentlige gullstandardtabell har hver av de 44 yrkesgruppene i utgangspunktet fem oppgaver. Men en sammenligning som krever en oppført referansefil fra en ekspert, kan ikke bruke alle radene i tabellen på samme måte: 35 av 220 rader har en tom deliverable_files-liste.
Dette antallet er allerede dokumentert i gbenchs GDPval-implementering. Vi telte hvordan de tomme listene fordeler seg på sektorer og yrkesgrupper i det samme fastlåste øyeblikksbildet av GDPval. Alle de 44 yrkesgruppene har fortsatt minst én rad med en oppført fil. Men sammensetningen av de gjenværende radene er ikke like jevn som i den opprinnelige tabellen.
Hvilke oppgaver har en oppført referansefil fra en ekspert?
Disse tallene viser bare om tabellen oppgir minst én filbane til en ekspertleveranse. En oppført filbane er ikke bevis for at filen er tilgjengelig eller kan gjengis. En tom liste viser ikke om det finnes en referanse et sted utenfor denne tabellen.
| Sektor | Rader i offentlig gullstandardtabell | Med oppført leveranse | Med tom liste |
|---|---|---|---|
| Finansiering og forsikring | 25 | 17 | 8 |
| Offentlig forvaltning | 25 | 22 | 3 |
| Helse- og sosialtjenester | 25 | 22 | 3 |
| Informasjon | 25 | 14 | 11 |
| Industri | 25 | 25 | 0 |
| Faglig, vitenskapelig og teknisk tjenesteyting | 25 | 24 | 1 |
| Eiendom, utleie og leasing | 25 | 20 | 5 |
| Detaljhandel | 20 | 16 | 4 |
| Engroshandel | 25 | 25 | 0 |
| Totalt | 220 | 185 | 35 |
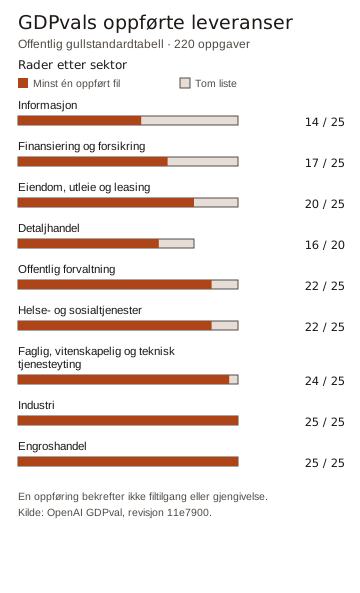
Søylene viser oppføringer i listen, ikke bekreftet filtilgang eller gjengivelse.
Tabellen inneholder 44 yrkes- og sektorgrupper med fem oppgaver hver. Av disse beholder 22 alle fem radene etter dette utvalget, og 22 beholder mellom to og fire. Alle yrkesgruppene er fortsatt representert, men det betyr ikke lenger at hver av dem har like mange oppgaver.
Forskjellen mellom sektorene er nyttig å kjenne til når du leser et samlet resultat. Informasjon og industri står hver for 25 av de opprinnelige 220 radene, eller 11,4 %. I en hypotetisk oppsummering med lik vekt per oppgave, basert på nøyaktig de 185 radene med oppføringer i listen, ville informasjon stå for 14/185, eller 7,6 %, og industri for 25/185, eller 13,5 %. Dette er andeler av oppgaver, ikke modellscorer eller anslag på verdien av ulike yrker.
Kan bedømmeren lese referansefilene?
Beregningen med 185 rader er ikke gbenchs endelige nevner for poengberegning. Dokumentasjonen beskriver fire oppgaver til der de oppførte leveransene ikke kan gjengis som tekst. Det gir 181 oppgaver med referanser som kan gjengis i dette øyeblikksbildet. Vi gjenga ikke disse filene selv og kjørte ikke gbench.
Selv uten å vite hvilke sektorer de fire oppgavene tilhører, setter tallene nyttige grenser for det dokumenterte utvalget med referanser som kan gjengis. Hvis dette er fire ulike rader blant de 185 med oppføringer i listen, gjenstår minst 21 industrirader og høyst 14 informasjonsrader. Med lik vekt per oppgave er grensene henholdsvis 21/181 (11,6 %) og 14/181 (7,7 %). En faktisk kjøring kan ha en annen nevner for poengberegning fordi genereringsfeil, dommerfeil og antall forsøk per oppgave også spiller inn. Disse tallene beskriver ikke OpenAIs opprinnelige resultater vurdert av mennesker.
Andre vurderingsmetoder har andre krav. I NeMo Gyms dokumenterte vurderingsmodus ved commit 5d6429f vurderer en språkmodell som dommer en foreslått leveranse opp mot oppgavens vurderingskriterier. Koden for klargjøring kopierer ikke ekspertresultatenes deliverable_files-liste, mens verifikatoren for vurderingskriterier rapporterer missing_rubric hvis begge feltene med vurderingskriterier er tomme. Alle oppførte inndatafiler til oppgaven må gjøres tilgjengelige, og det trengs fortsatt et kandidatresultat og en dommer. Kallet for klargjøring låser ikke datasettrevisjonen. Vi kjørte ikke NeMo Gym eller målte dekningen. Poengsummen basert på vurderingskriterier og gbenchs andel seire eller uavgjorte er ulike mål.
Hva dommeren kan se
Tilgang til referanser er bare én del av sammenligningen. gbench-dokumentasjonen oppgir allerede at 32 av de 220 settene med vurderingskriterier overskrider standardgrensen på 8 000 tegn. Formateringsfunksjonen beholder hele kriterier i opprinnelig rekkefølge til det neste ville overskride grensen, og legger deretter til en markør for avkorting. Hvis det første kriteriet alene overskrider grensen, vises bare en del av det. Antall tegn er ikke det samme som antall token.
Vi brukte denne fastlåste formateringsfunksjonen på oppgavetabellen. Blant de 185 radene med en oppført ekspertleveranse ville 26 sett med vurderingskriterier bli avkortet ved standardgrensen, slik at 247 hele kriterier til sammen ble utelatt fra disse radene. En oppført leveranse kan ikke nødvendigvis gjengis, og mislykkede eller tomme genereringer kan hindre et kall til dommeren. Tallene viser derfor ikke antall vurderte sammenligninger. Som illustrasjon ville en endring av bare formateringsfunksjonens grense til 12 000 eller 16 000 tegn føre til avkorting av henholdsvis to eller ingen av disse 185 settene med vurderingskriterier. Vi testet ikke disse innstillingene i en evaluator eller mot en dommer. Antallet utelatte kriterier viser ikke hvor viktige de er, eller om en avgjørelse ville blitt endret. En høyere grense kan gi mindre plass til resten av et kontekstvindu med fast størrelse. Se på informasjonen om avkorting som ble registrert i den faktiske kjøringen, sammen med antall referanser og antall poengsatte oppgaver.
Skriptet for utvalg etter vurderingskriterier gjenskaper disse tallene med DuckDB 1.4.4. Det laster midlertidig ned hele den fastlåste oppgavetabellen og behandler teksten med vurderingskriterier i minnet. Resultatet inneholder aggregerte tall, ikke oppgave-ID-er eller tekst med vurderingskriterier. Skriptet fjerner den midlertidige tabellen etter en normal kjøring. Det kjører bare den gjennomgåtte og hash-verifiserte formateringsfunksjonen fra gbench i et begrenset navnerom, som ikke er en sikkerhetssandkasse. Arkivet inneholder den opprinnelige lisensen og tilhørende merknad. Etter oppsettet av DuckDB nedenfor kan du bruke Python 3.11 til å opprette miljøet, laste ned arkivet og kjøre på macOS eller Linux:
unzip rubric-screen.zip -d rubric-screen
.gdpval-venv/bin/python rubric-screen/rubric-screen.py > rubric-observations.json
Dokumenter veien fra oppgaver til poengsummer
Når du setter opp eller sammenligner en evaluering, bør du registrere datasettrevisjonen, hvilken type referanse som kreves, og hver regel for hvilke oppgaver som kan inngå. Rapporter antall per gruppe i utgangstabellen, etter referansesjekker og etter poengberegning. Skill mellom årsakene: manglende oppført referanse, uleselig referanse, mislykket generering og en dommeravgjørelse som ikke kan brukes. Ett samlet resultat kan ellers skjule hvilke oppgaver som sluttet å bidra.
Oppgi også hvordan de gjenværende oppgavene og forsøkene vektes. Lik vekt per oppgave, lik vekt per yrkesgruppe og lik vekt per forsøk svarer på ulike spørsmål når antallene varierer. Ingen av dem erstatter manglende dokumentasjon i seg selv. Hvilken oppsummering som passer, avhenger av hva evalueringen skal måle.
For et oppgavesett du utformer selv, viser veiledningen for agentevaluering hvordan du definerer observerbare kontroller og tolker gjentatte forsøk.
Noter den nøyaktige versjonen av hver inndatafil
En fastlåst oppgavetabell låser ikke nødvendigvis alle filene en evaluator laster ned. I en tidligere offentlig GDPval-tabell ved revisjon 4bf6426 oppgir 122 av 220 oppgaverader inndatafiler. Alle de 262 oppførte inndata-URL-ene peker til repositoriets løpende main-gren. Leverandørens metadata viser at 62 av de samme filbanene hadde andre størrelser og blob-ID-er ved revisjon 11e7900. Disse 62 filbanene forekommer i 20 av radene i den tidligere tabellen. Dette er oppgaveinndata, og de er atskilt fra ekspertenes referanseresultater i deliverable_files som ble telt ovenfor.
Dette viser ikke at en bestemt evaluering brukte endrede inndata, at en fil er korrupt, eller at en poengsum ble endret. Det viser hvorfor bruk av en lagret tabells løpende URL-er på et senere tidspunkt kan velge en annen versjon av en inndatafil. Vi analyserte ikke innholdet i inndatafilene.
Ved Inspect Evals-commit 5c092d5 låser GDPval-innlasteren oppgavetabellen til revisjon a3848a2. Denne tabellen er identisk byte for byte med den tidligere tabellen ovenfor, og leverandørens metadata for inndatafilene samsvarer også. Innlasteren kobler sammen parede URL-er i tabellen med filtilordninger for hvert eksempel. Inspect-dokumentasjonen sier at disse tilordningene kan bruke URL-er. Denne kildebanen kan dermed inneholde løpende URL-er sammen med en fastlåst tabell. Vi testet ikke hvordan Inspect laster ned eller mellomlagrer filer, og fastslo heller ikke hva noen kjøring brukte.
En evaluator kan i stedet slå opp datasettrelative filbaner ved samme uforanderlige revisjon som tabellen. gbench-implementeringen som er undersøkt her, oppgir eksplisitt sin fastlåste revisjon når den henter vedlegg. Registrer revisjonen og verifiser der det er praktisk mulig, filene som faktisk ble brukt. Hugging Faces dokumentasjon for nedlasting forklarer hvordan du slår opp hvilken commit en løpende revisjon peker til, for å sikre konsekvente nedlastinger.
Analyseskriptet for inndata-URL-er gjenskaper tallene med DuckDB 1.4.4. Det laster midlertidig ned den tidligere oppgavetabellen, fjerner den etter en normal kjøring og beholder ingen oppgavetekst, individuelle ID-er, filbaner for inndata eller innhold fra inndata i resultatet. Et valgfritt flagg sjekker svarhodene for én filbane og gjeldende main-revisjon. Resultatet kan endre seg når main oppdateres. For denne sjekken sender skriptet bare HEAD-forespørsler, også ved omdirigeringer, og registrerer ikke utilgjengelige resultater. Sjekkene med Pythons standardbibliotek sammenligner tabellen og metadataene som Inspect har låst til, og undersøker den fastlåste kildekoden til innlasteren uten å kjøre den. Sjekken av tabellens hash leser hele tabellen inn i minnet, men tolker eller beholder ikke oppgaveinnholdet. Skriptene ber ikke om selve innholdet i inndatafilene.
Etter oppsettet av DuckDB nedenfor kan du kjøre sjekkene på macOS eller Linux med:
.gdpval-venv/bin/python input-url-revisions.py > input-url-observations.json
.gdpval-venv/bin/python inspect-dataset-check.py
.gdpval-venv/bin/python inspect-source-check.py
Slik telte vi
For kartleggingen av referansetilgang undersøkte vi train-Parquet-tabellen ved GDPval-revisjon 11e7900cdcac61bc4daf59e65feb238acda98fbf, bekreftet 220 unike oppgave-ID-er og grupperte bare etter sektor, yrkesgruppe og lengden på hver deliverable_files-liste. Analyseskriptet kontrollerer kildens hash og gjenskaper tallene med DuckDB 1.4.4. Det laster midlertidig ned hele tabellen og fjerner den etter en normal kjøring. Resultatet inneholder ingen prompt, vurderingskriterier, individuelle oppgave-ID-er, filbaner til leveranser eller leveranser. Ingen modell, referansetest eller referansegjengiver ble kjørt.
For å gjenskape resultatene lokalt med Python 3.9 eller nyere på macOS eller Linux må du kontrollere at python3 velger denne versjonen:
python3 -m venv .gdpval-venv
.gdpval-venv/bin/python -m pip install duckdb==1.4.4
.gdpval-venv/bin/python analyze.py > observations.json
sapien1 gjør disse skriptene tilgjengelige for nedlasting og lokal kjøring. Det er ikke oppgitt noen ytterligere lisens til å endre eller videredistribuere dem. Kildedatasettet har egne vilkår.
OpenAI beskriver gullstandardutvalget med 220 oppgaver som utgitt med åpen kildekode. Det fastlåste datasettkortet inneholder en canary-markør for referansetesten, men ikke noe lisensfelt. Sjekk vilkårene som gjelder for din egen bruk, fremfor å trekke slutninger fra en merkelapp på kortet eller fra dette antallet. Sektor- og yrkesbetegnelsene og referansetesten er fortsatt kreditert kilden.