Badania
Weryfikacja plików referencyjnych zmienia strukturę zadań w publicznym zbiorze GDPval
Język: Polski
Wynik benchmarku łatwiej zinterpretować, gdy wiadomo, jakie zadania mogą się na niego składać. W publicznej tabeli zadań gold GDPval każdy z 44 zawodów ma początkowo po pięć zadań. Jednak porównanie wymagające wymienionego pliku referencyjnego eksperta nie może wykorzystać wszystkich wierszy tej tabeli w ten sam sposób: 35 z 220 wierszy ma pustą listę deliverable_files.
Ta łączna liczba jest już udokumentowana w implementacji GDPval w gbench. Policzyliśmy, jak puste listy rozkładają się między sektorami i zawodami w tym samym przypiętym stanie zbioru GDPval. Wszystkie 44 zawody nadal mają co najmniej jeden wiersz z wymienionym plikiem. Pozostałe zadania nie są jednak rozłożone tak równomiernie jak w tabeli wyjściowej.
Przy których zadaniach wymieniono plik referencyjny od eksperta?
Te liczby wskazują jedynie, czy tabela wymienia co najmniej jedną ścieżkę do rezultatu pracy eksperta. Obecność ścieżki nie dowodzi, że plik jest dostępny ani że można go wyrenderować. Pusta lista nie rozstrzyga, czy referencja istnieje gdzieś poza tą tabelą.
| Sektor | Wiersze w publicznej tabeli gold | Z wymienionym rezultatem | Z pustą listą |
|---|---|---|---|
| Finanse i ubezpieczenia | 25 | 17 | 8 |
| Administracja publiczna | 25 | 22 | 3 |
| Opieka zdrowotna i pomoc społeczna | 25 | 22 | 3 |
| Informacja | 25 | 14 | 11 |
| Przetwórstwo przemysłowe | 25 | 25 | 0 |
| Usługi profesjonalne, naukowe i techniczne | 25 | 24 | 1 |
| Nieruchomości oraz wynajem i dzierżawa | 25 | 20 | 5 |
| Handel detaliczny | 20 | 16 | 4 |
| Handel hurtowy | 25 | 25 | 0 |
| Razem | 220 | 185 | 35 |
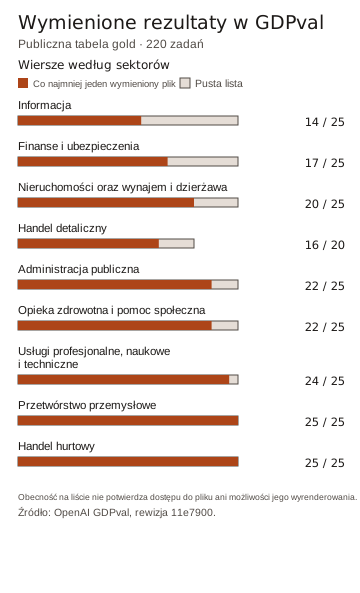
Słupki pokazują obecność na liście, a nie zweryfikowany dostęp do pliku ani możliwość jego wyrenderowania.
Tabela zawiera 44 grupy zawodów i sektorów, każda po pięć zadań. Po tym etapie weryfikacji 22 grupy zachowują wszystkie pięć wierszy, a 22 zachowują od dwóch do czterech. Każdy zawód jest nadal reprezentowany, ale sama obecność nie oznacza już, że każdy ma taką samą liczbę zadań.
Różnice między sektorami pomagają odczytać wynik zbiorczy. Informacja i przetwórstwo przemysłowe odpowiadają początkowo za 25 z 220 wierszy, czyli po 11,4%. W hipotetycznym podsumowaniu obejmującym dokładnie 185 wierszy z plikiem na liście, przy równej wadze każdego zadania, udział informacji wyniósłby 14/185, czyli 7,6%, a przetwórstwa przemysłowego 25/185, czyli 13,5%. To udziały zadań, a nie wyniki modeli ani szacunki wartości poszczególnych zawodów.
Czy system oceniający może odczytać pliki referencyjne?
Liczba 185 wierszy nie jest ostatecznym mianownikiem stosowanym przez gbench do obliczania wyników. Dokumentacja opisuje kolejne cztery zadania, których wymienionych rezultatów nie można wyrenderować do tekstu, co pozostawia 181 zadań z referencją możliwą do wyrenderowania w tym stanie zbioru. Nie renderowaliśmy tych plików niezależnie ani nie uruchamialiśmy gbench.
Nawet bez wiedzy o tym, do których sektorów należą te cztery zadania, liczby pozwalają wyznaczyć użyteczne granice dla udokumentowanego zbioru z referencjami możliwymi do wyrenderowania. Jeśli są to cztery różne wiersze spośród 185 z plikiem na liście, pozostaje co najmniej 21 wierszy przetwórstwa przemysłowego i co najwyżej 14 wierszy informacji. Przy równej wadze zadań granice te wynoszą odpowiednio 21/181 (11,6%) i 14/181 (7,7%). W rzeczywistym uruchomieniu mianownik wyniku może być inny, ponieważ znaczenie mają również niepowodzenia generowania, błędy oceniającego i liczba prób na zadanie. Te liczby nie opisują pierwotnych wyników OpenAI ocenianych przez ludzi.
Inne metody oceniania mają inne wymagania. W udokumentowanym trybie rubryki NeMo Gym dla commitu 5d6429f model LLM pełniący rolę oceniającego porównuje rezultat kandydata z rubryką zadania. Kod przygotowujący nie kopiuje listy deliverable_files z wynikami eksperta, natomiast weryfikator rubryki zgłasza missing_rubric, jeśli oba pola rubryki są puste. Wszystkie wymienione pliki wejściowe zadania trzeba przygotować, a wynik kandydata i oceniający nadal są wymagane; wywołanie przygotowujące nie przypina rewizji zbioru danych. Nie uruchamialiśmy NeMo Gym ani nie mierzyliśmy jego pokrycia. Wynik rubryki i odsetek zwycięstw lub remisów w gbench to różne miary.
Co widzi oceniający
Dostępność referencji to tylko jeden z elementów porównania. Dokumentacja gbench podaje już, że 32 z 220 rubryk przekraczają domyślny limit 8000 znaków. Formater zachowuje całe kryteria w pierwotnej kolejności, dopóki następne nie przekroczyłoby limitu, a następnie dodaje znacznik obcięcia; jeśli samo pierwsze kryterium przekracza limit, pokazuje tylko jego część. Liczba znaków nie jest liczbą tokenów.
Zastosowaliśmy ten przypięty formater do tabeli zadań. Spośród 185 wierszy z wymienionym rezultatem pracy eksperta 26 rubryk zostałoby obciętych przy domyślnym limicie, z pominięciem łącznie 247 całych kryteriów w tych wierszach. Wymieniony rezultat nie musi nadawać się do wyrenderowania, a nieudane lub puste wyniki generowania mogą uniemożliwić wywołanie oceniającego, więc nie są to liczby ocenionych porównań. Dla ilustracji: zmiana samego limitu formatera do 12 000 lub 16 000 znaków spowodowałaby obcięcie odpowiednio dwóch lub żadnej z tych 185 rubryk. Nie sprawdzaliśmy tych ustawień w systemie ewaluacyjnym ani u oceniającego. Liczba pominiętych kryteriów nie określa ich znaczenia ani tego, czy werdykt by się zmienił; większy limit może zostawić mniej miejsca na resztę treści w oknie kontekstowym o stałej wielkości. Sprawdź informacje o obcięciu zapisane podczas rzeczywistego uruchomienia wraz z liczbami dotyczącymi referencji i ocen.
Skrypt weryfikacji rubryk odtwarza te liczby za pomocą DuckDB 1.4.4. Tymczasowo pobiera kompletną przypiętą tabelę zadań i przetwarza tekst rubryk w pamięci; jego wynik zawiera zagregowane liczby, bez identyfikatorów zadań i tekstu rubryk. Po normalnym zakończeniu usuwa tymczasową tabelę. Wykonuje tylko sprawdzony i zweryfikowany za pomocą sumy kontrolnej formater z gbench w ograniczonej przestrzeni nazw, która nie jest piaskownicą bezpieczeństwa. Archiwum zawiera licencję i informacje od pierwotnego dostawcy. Po skonfigurowaniu DuckDB zgodnie z instrukcją poniżej użyj Python 3.11, aby utworzyć środowisko, pobrać archiwum i uruchomić skrypt w systemie macOS lub Linux:
unzip rubric-screen.zip -d rubric-screen
.gdpval-venv/bin/python rubric-screen/rubric-screen.py > rubric-observations.json
Zapisz drogę od zadań do wyników
Podczas konfigurowania lub porównywania ewaluacji zapisz rewizję zbioru danych, wymagany typ referencji i każdą regułę kwalifikacji. Podaj liczby według grup w tabeli wyjściowej, po sprawdzeniu referencji i po ocenie. Rozróżnij brak wymienionej referencji, nieczytelną referencję, nieudane generowanie i niezdatny do użycia werdykt oceniającego. W przeciwnym razie pojedynczy wynik zbiorczy może ukryć, które zadania przestały się na niego składać.
Podaj też, jak ważone są pozostałe zadania i próby. Równa waga każdego zadania, każdego zawodu i każdej próby odpowiada na inne pytania, gdy liczby się różnią. Żaden z tych sposobów sam w sobie nie uzupełnia brakujących danych; właściwe podsumowanie zależy od tego, co ewaluacja ma mierzyć.
Jeśli samodzielnie projektujesz zbiór zadań, przewodnik po ewaluacji agentów pokazuje, jak definiować obserwowalne kryteria sprawdzania i interpretować powtarzane próby.
Zapisz dokładną wersję każdego pliku wejściowego
Przypięcie tabeli zadań nie musi oznaczać przypięcia każdego pliku pobieranego przez system ewaluacyjny. We wcześniejszej publicznej tabeli GDPval w rewizji 4bf6426 122 z 220 wierszy zadań wymienia pliki wejściowe. Wszystkie 262 wymienione adresy URL plików wejściowych wskazują na zmieniającą się gałąź main repozytorium. Metadane dostawcy wskazują, że do czasu rewizji 11e7900 62 z tych samych ścieżek miały inne rozmiary i identyfikatory blobów; te 62 ścieżki występują w 20 wierszach wcześniejszej tabeli. Są to pliki wejściowe zadań, odrębne od policzonych wyżej referencyjnych wyników ekspertów w deliverable_files.
Nie dowodzi to, że w konkretnej ewaluacji użyto zmienionego pliku wejściowego, że plik jest uszkodzony ani że wynik się zmienił. Pokazuje natomiast, dlaczego późniejsze skorzystanie ze zmieniających się adresów URL zapisanej tabeli może prowadzić do wybrania innej wersji pliku wejściowego. Nie analizowaliśmy zawartości plików wejściowych.
W commicie Inspect Evals 5c092d5 moduł ładujący GDPval przypina tabelę zadań do rewizji a3848a2. Ta tabela jest identyczna bajt po bajcie z wcześniejszą tabelą opisaną wyżej, a metadane plików wejściowych dostawcy również są zgodne. Moduł ładujący przekształca sparowane adresy URL z tabeli w mapowania plików dla próbek; dokumentacja Inspect podaje, że te mapowania mogą korzystać z adresów URL. Ta ścieżka źródłowa może zatem przekazywać zmieniające się adresy URL wraz ze stałą tabelą. Nie testowaliśmy pobierania ani buforowania plików przez Inspect i nie ustalaliśmy, czego użyto w którymkolwiek uruchomieniu.
System ewaluacyjny może zamiast tego rozwiązywać ścieżki względne zbioru danych według tej samej niezmiennej rewizji co tabela. Sprawdzona tutaj implementacja gbench jawnie podaje przypiętą rewizję podczas pobierania załączników. Zapisz rewizję i, gdy to możliwe, zweryfikuj faktycznie użyte pliki. Dokumentacja pobierania Hugging Face wyjaśnia, jak ustalić commit odpowiadający zmieniającej się rewizji, aby pobierane dane były spójne.
Skrypt analizy adresów URL plików wejściowych odtwarza te liczby za pomocą DuckDB 1.4.4. Tymczasowo pobiera wcześniejszą tabelę zadań, usuwa ją po normalnym zakończeniu, a w wynikach nie zapisuje tekstu zadań, pojedynczych identyfikatorów, ścieżek ani zawartości plików wejściowych. Opcjonalna flaga sprawdza nagłówki odpowiedzi dla jednej ścieżki oraz bieżącą rewizję main; wynik może się zmienić wraz ze zmianami w main. Na potrzeby tego sprawdzenia skrypt wysyła wyłącznie żądania HEAD, również przez przekierowania, i nie ustala wyników, które są niedostępne. Kontrole korzystające z biblioteki standardowej Pythona porównują tabelę i metadane przypięte w Inspect oraz sprawdzają przypięty kod źródłowy modułu ładującego bez jego uruchamiania. Kontrola sumy tabeli wczytuje całą tabelę do pamięci, ale nie analizuje ani nie zapisuje treści zadań. Skrypty nie żądają treści plików wejściowych.
Po skonfigurowaniu DuckDB zgodnie z instrukcją poniżej uruchom kontrole w systemie macOS lub Linux za pomocą:
.gdpval-venv/bin/python input-url-revisions.py > input-url-observations.json
.gdpval-venv/bin/python inspect-dataset-check.py
.gdpval-venv/bin/python inspect-source-check.py
Jak liczyliśmy
Na potrzeby analizy dostępności referencji sprawdziliśmy tabelę Parquet train w rewizji GDPval 11e7900cdcac61bc4daf59e65feb238acda98fbf, potwierdziliśmy 220 unikalnych identyfikatorów zadań i pogrupowaliśmy wyłącznie sektor, zawód oraz długość każdej listy deliverable_files. Skrypt analizy sprawdza sumę kontrolną źródła i odtwarza liczby za pomocą DuckDB 1.4.4. Tymczasowo pobiera pełną tabelę i usuwa ją po normalnym zakończeniu; jego wynik nie zawiera promptów, rubryk, pojedynczych identyfikatorów zadań, ścieżek do rezultatów ani samych rezultatów. Nie uruchamialiśmy żadnego modelu, benchmarku ani narzędzia do renderowania referencji.
Aby odtworzyć wyniki lokalnie w systemie macOS lub Linux za pomocą Python 3.9 lub nowszego, upewnij się, że python3 wskazuje tę wersję:
python3 -m venv .gdpval-venv
.gdpval-venv/bin/python -m pip install duckdb==1.4.4
.gdpval-venv/bin/python analyze.py > observations.json
sapien1 udostępnia te skrypty do pobrania i uruchomienia lokalnie; nie wskazano dodatkowej licencji na ich modyfikowanie ani dalsze rozpowszechnianie. Warunki korzystania ze źródłowego zbioru danych są odrębne.
OpenAI opisuje podzbiór gold obejmujący 220 zadań jako udostępniony na zasadach open source. Przypięta karta zbioru danych zawiera znacznik benchmarku i nie zawiera pola licencji; sprawdź warunki mające zastosowanie do planowanego użycia, zamiast wywnioskowywać je z etykiety karty lub tej liczby. Źródło nazw sektorów i zawodów oraz benchmarku pozostaje wskazane.