Badania
Zbiór ewaluacyjny epizodów LeRobot może korzystać ze statystyk normalizacji o szerszym zakresie
Język: Polski
Zespół może wydzielić epizody robota do ewaluacji, a jednocześnie używać statystyk przetwarzania wstępnego obejmujących dane spoza epizodów treningowych. Prześledziliśmy jedną ścieżkę treningową LeRobot i sprawdziliśmy publiczną migawkę metadanych. W hipotetycznym podziale na 40 epizodów treningowych i 10 ewaluacyjnych zapisane zakresy stanu i akcji wykraczają poza zakresy epizodów treningowych, każdy w trzech z sześciu wymiarów. To porównanie zapisanych metadanych, a nie wynik zaobserwowanego treningu ani oceny wydajności modelu. Pokazuje, dlaczego przegląd zbioru ewaluacyjnego powinien obejmować zarówno listę epizodów, jak i statystyki przekazywane do procesora.
Podział i statystyki to odrębne decyzje
W commicie LeRobot 7910c20 skonfigurowany parametr eval_split grupuje wybrane epizody według pierwszego zadania na ich liście i przypisuje do ewaluacji ostatnie ceil(group size × eval_split) epizodów z każdej grupy. Domyślna konfiguracja nie przewiduje podziału ewaluacyjnego; w poniższym przykładzie celowo go ustawiono. Kod tworzy osobne obiekty zbioru treningowego i ewaluacyjnego, korzystając z list epizodów, tego samego katalogu głównego zbioru danych i tej samej rewizji.
Moduł wczytujący metadane zbioru danych osobno wczytuje meta/stats.json. W przeanalizowanej ścieżce treningowej nowa polityka Diffusion, której trening nie jest wznawiany i dla której nie podano ścieżki do wstępnie wytrenowanego procesora, otrzymuje podczas tworzenia procesorów statystyki z metadanych zbioru danych. Domyślna konfiguracja Diffusion używa normalizacji min–max dla stanu i akcji. Analiza kodu dotyczy tej konkretnej konfiguracji i wersji; inne polityki, nadpisania ustawień, procesory wstępnie wytrenowane lub odtworzone przy wznowieniu, formaty i wersje mogą działać inaczej.
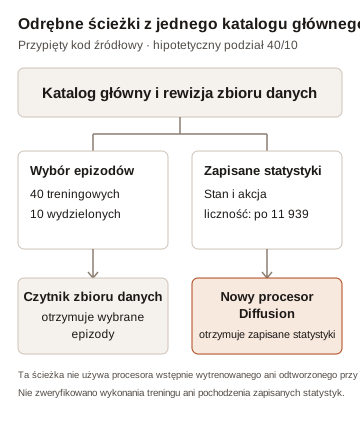
Nie uruchomiliśmy modułu wczytującego zbiór danych ani polityki. Schemat opisuje przeanalizowaną ścieżkę w kodzie przy podanych warunkach, a nie zapis rzeczywistego uruchomienia.
Przykład metadanych
Publiczna migawka lerobot/svla_so101_pickplace w rewizji f641879 opisuje 50 epizodów i 11 939 klatek. Wszystkie 50 rekordów epizodów ma ten sam klucz grupowania według pierwszego zadania. Jeśli żadne epizody nie zostaną wstępnie wybrane ani wykluczone, a eval_split=0.2, przeanalizowana reguła przypisze 40 epizodów do treningu i 10 do ewaluacji. Ich podsumowania deklarują odpowiednio 9180 i 2759 klatek.
Zapisane statystyki observation.state i action podają liczność po 11 939. Ich tablice min/max są zgodne z agregatem podsumowań wszystkich 50 epizodów w granicach tolerancji bezwzględnej i względnej 1e-6. W bezpośrednim porównaniu z wartościami skrajnymi zagregowanymi dla hipotetycznych 40 epizodów treningowych zapisane zakresy wykraczają poza zakresy treningowe w trzech z sześciu wymiarów każdej cechy. Liczba ta pozostaje taka sama, gdy wymagana jest różnica wykraczająca poza tolerancje względną i bezwzględną 1e-6 funkcji math.isclose.
| Cecha | Wymiary, w których zapisany zakres wykracza poza zakres epizodów treningowych | Najwęższy zakres epizodów treningowych jako część zapisanego zakresu |
|---|---|---|
observation.state | 3 z 6 | 84,3% |
action | 3 z 6 | 84,2% |
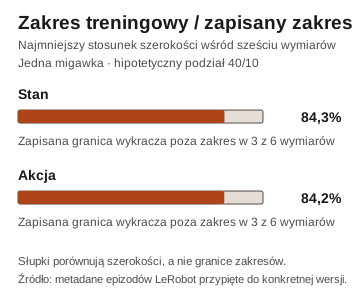
Każda wartość procentowa to najmniejszy stosunek szerokości zakresów wśród sześciu wymiarów danej cechy; dwa wiersze nie muszą dotyczyć tego samego wymiaru. Słupki porównują szerokości, a nie miejsca, w których zakresy się zaczynają lub kończą. Obliczenie dla 40 epizodów obejmuje wszystkie zadeklarowane dla nich klatki. Rzeczywisty mechanizm próbkowania może pomijać końcowe klatki, próbkować okna lub stosować inne reguły wyboru, więc nie jest to pomiar pozycji używanych przez rzeczywisty optymalizator.
Podsumowania wydzielonych epizodów również rozszerzają agregat wszystkich epizodów poza agregat 40 epizodów treningowych w trzech wymiarach każdej cechy. Zapisane statystyki są zgodne z agregatem wszystkich epizodów w granicach podanej tolerancji, ale nie ustaliliśmy niezależnie, jak powstał zapisany plik, ani nie zweryfikowaliśmy źródłowych plików klatek. Jeśli te zapisane zakresy zostaną przekazane do opisanego wyżej nowego procesora min–max, szersze granice mogą zmienić jego skalę. Przykład nie pokazuje, co wczytało jakiekolwiek wcześniejsze zadanie, czy zbiór danych jest odpowiedni dla danej polityki ani czy wynik punktowy uległ zmianie.
Sprawdź zakres ponownego obliczenia
Znane zalecenie mówi, aby dopasowywać przetwarzanie wstępne zależne od danych na zbiorze treningowym i konsekwentnie stosować uzyskaną transformację do danych ewaluacyjnych. Omówienie wycieku danych w dokumentacji scikit-learn wyjaśnia tę ogólną zasadę. We wcześniejszym zgłoszeniu w LeRobot również wyrażono obawy dotyczące statystyk globalnych i walidacji; nasze sprawdzenie nie potwierdza opisanego w zgłoszeniu zachowania robota ani nie diagnozuje jego przyczyny. Inna karta zbioru danych SO-101 już rozróżnia statystyki wyłącznie treningowe od metadanych całego zbioru na potrzeby kontrolowanej ewaluacji. Nie sprawdziliśmy liczności ani plików tego zbioru.
Przeanalizuj ścieżkę ponownego obliczania równie uważnie jak podział. W przypiętej wersji funkcja pomocnicza recompute_stats domyślnie korzysta ze ścieżki dla danych liczbowych, która skanuje pliki Parquet w katalogu głównym zbioru danych i przechodzi po indeksach zawartych w nich epizodów bez bezpośredniego filtrowania przez dataset.episodes. Jeśli te pliki nadal zawierają obie części podziału, samo przekazanie obiektu z wybranymi epizodami nie potwierdza, że statystyki liczbowe obejmują wyłącznie dane treningowe. Funkcja zapisuje statystyki w tym katalogu głównym i zachowuje istniejące statystyki cech, których nie przelicza; domyślnie pomija cechy obrazu i wideo. Nie uruchomiliśmy tej funkcji ani nie zmodyfikowaliśmy zbioru danych. Jej ciąg dokumentacyjny już informuje, że przechodzi ona przez wszystkie epizody, a przewodnik po narzędziach do zbiorów danych opisuje operację ponownego obliczania.
Zanim uznasz wynik dla wydzielonego zbioru za niezależny, zapisz identyfikatory wybranych epizodów, rewizję zbioru danych, pochodzenie i zakres cech każdej statystyki oraz faktycznie używaną konfigurację procesora. Sprawdź, czy proponowane obliczenie wyłącznie dla danych treningowych odczytuje zamierzone wiersze, i zastosuj do ewaluacji odpowiednią transformację wyznaczoną na podstawie danych treningowych. Osobno sprawdź cechy obrazu, wideo i akcji względnych, które mogą podążać innymi ścieżkami. Procesor wstępnie wytrenowany lub odtworzony przy wznowieniu może mieć własne zapisane statystyki, dlatego sprawdź rzeczywisty punkt kontrolny i nadpisania ustawień, zamiast zakładać zachowanie opisane w tym przykładzie.
Jak przeprowadziliśmy sprawdzenie
Przeczytaliśmy kod źródłowy przypięty do konkretnej wersji bez importowania ani uruchamiania LeRobot. Nasz skrypt analityczny weryfikuje hasze kodu źródłowego, tymczasowo pobiera niewielką tabelę metadanych i oblicza hipotetyczny podział oraz porównania min/max za pomocą DuckDB 1.4.4. Po prawidłowym wykonaniu usuwa tabelę tymczasową. Wyniki zagregowane nie zawierają etykiet zadań, identyfikatorów poszczególnych epizodów ani statystyk dla poszczególnych epizodów. Pakiet do sprawdzania kodu źródłowego zawiera skrypt weryfikujący wybrane struktury kodu źródłowego przypiętego do konkretnej wersji bez uruchamiania tego kodu, a także jego licencję i informacje o autorstwie. Generator ilustracji odtwarza dwa schematy na podstawie agregatu. Nie użyliśmy nagrań, surowych klatek ani modelu, nie uruchomiliśmy też treningu ani zadania benchmarkowego.
Aby odtworzyć wyniki w systemie macOS lub Linux z Pythonem 3.11 i DuckDB 1.4.4:
python3.11 -m venv .lerobot-stats-venv
.lerobot-stats-venv/bin/python -m pip install duckdb==1.4.4
.lerobot-stats-venv/bin/python analyze.py > observations-reproduced.json
unzip source-check.zip -d lerobot-source-check
.lerobot-stats-venv/bin/python lerobot-source-check/source-check.py
Karta zbioru danych przypięta do konkretnej wersji oznacza go licencją Apache-2.0; to oznaczenie nie rozstrzyga praw do każdego zasobu źródłowego. Narzędzie do sprawdzania kodu źródłowego odwołuje się do krótkich wyrażeń z LeRobot; przypięta licencja i informacje o prawach autorskich są dołączone do pakietu narzędzia. sapien1 udostępnia własne oryginalne skrypty do pobrania i lokalnego uruchomienia; nie określono dodatkowej licencji na ich modyfikację ani redystrybucję. Warunki korzystania ze źródłowego zbioru danych i kodu źródłowego LeRobot są odrębne.