Riset
Holdout episode LeRobot dapat memakai statistik normalisasi dengan cakupan lebih luas
Bahasa: Bahasa Indonesia
Tim dapat memisahkan episode robot untuk evaluasi dan tetap menggunakan statistik prapemrosesan yang cakupannya melampaui episode pelatihan. Kami menelusuri satu jalur pelatihan LeRobot dan memeriksa satu snapshot metadata publik. Dalam pembagian hipotetis 40 episode pelatihan dan 10 episode evaluasi, rentang state dan action yang disimpan masing-masing melampaui rentang episode pelatihan pada tiga dari enam dimensi. Ini adalah perbandingan metadata yang disimpan, bukan hasil pelatihan yang diamati atau hasil kinerja model. Contoh ini menunjukkan mengapa tinjauan holdout perlu mencakup statistik yang diberikan kepada prosesor serta daftar episode.
Pembagian episode dan statistik adalah keputusan terpisah
Pada commit LeRobot 7910c20, eval_split yang dikonfigurasi mengelompokkan episode yang dipilih berdasarkan tugas pertama yang tercantum, lalu menetapkan ceil(group size × eval_split) episode terakhir dari setiap kelompok untuk evaluasi. Konfigurasi bawaan tidak memiliki pembagian evaluasi; contoh di bawah sengaja menetapkannya. Kode membuat objek dataset pelatihan dan evaluasi yang terpisah menggunakan daftar episode, root dataset yang sama, dan revisi yang sama.
Pemuat metadata dataset memuat meta/stats.json secara terpisah. Dalam jalur pelatihan yang diperiksa, kebijakan Diffusion baru yang tidak melanjutkan sesi sebelumnya dan tanpa jalur prosesor pralatih menerima statistik metadata dataset saat prosesornya dibuat. Konfigurasi Diffusion bawaan menggunakan normalisasi min-max untuk state dan action. Penelusuran sumber ini khusus untuk konfigurasi dan versi tersebut; kebijakan, override, prosesor pralatih atau yang melanjutkan sesi, format, dan versi lain dapat berbeda.
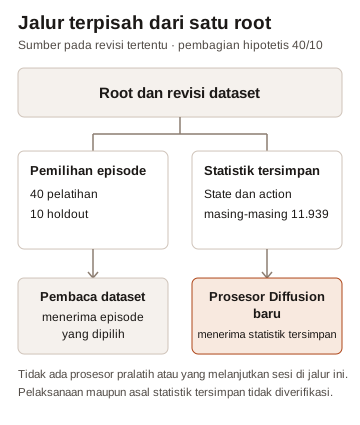
Kami tidak menjalankan pemuat dataset atau kebijakan. Diagram ini menjelaskan jalur sumber yang diperiksa dalam kondisi yang disebutkan, bukan catatan pelaksanaan yang sebenarnya.
Satu contoh metadata
Snapshot publik lerobot/svla_so101_pickplace pada revisi f641879 menjelaskan 50 episode dan 11.939 frame. Seluruh 50 catatan episode memiliki kunci pengelompokan tugas pertama yang sama. Jika tidak ada episode yang dipilih sebelumnya atau dikecualikan dan eval_split=0.2, aturan yang diperiksa akan menetapkan 40 episode untuk pelatihan dan 10 untuk evaluasi. Ringkasan episode masing-masing mencatat 9.180 dan 2.759 frame.
Statistik observation.state dan action yang disimpan masing-masing melaporkan hitungan 11.939. Array min/max keduanya cocok dengan agregat dari seluruh 50 ringkasan episode dalam toleransi absolut dan relatif 1e-6. Dibandingkan langsung dengan nilai ekstrem yang diagregasi dari 40 episode pelatihan hipotetis, rentang yang disimpan lebih luas pada tiga dari enam dimensi untuk setiap fitur. Jumlah ini tetap sama ketika perbedaan harus melampaui batas math.isclose dengan toleransi relatif dan absolut 1e-6.
| Fitur | Dimensi dengan rentang tersimpan yang melampaui rentang episode pelatihan | Rentang episode pelatihan tersempit sebagai bagian dari rentang tersimpan |
|---|---|---|
observation.state | 3 dari 6 | 84,3% |
action | 3 dari 6 | 84,2% |
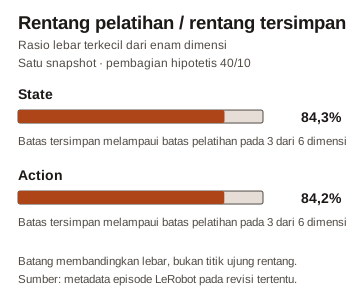
Setiap persentase adalah rasio lebar rentang terkecil dari enam dimensi fitur tersebut; kedua baris tidak harus menggambarkan dimensi yang sama. Batang membandingkan lebar, bukan titik awal atau akhir rentang. Perhitungan 40 episode mencakup semua frame yang tercatat untuk episode tersebut. Sampler yang sebenarnya dapat membuang frame di bagian akhir, mengambil sampel window, atau menggunakan aturan pemilihan lain, sehingga ini bukan pengukuran posisi yang digunakan oleh optimizer sesungguhnya.
Ringkasan episode holdout juga memperluas agregat seluruh episode melampaui agregat 40 episode pelatihan pada tiga dimensi untuk setiap fitur. Statistik yang disimpan cocok dengan agregat seluruh episode dalam toleransi yang disebutkan, tetapi kami tidak memastikan secara independen bagaimana file tersimpan itu dibuat atau memverifikasi file frame yang mendasarinya. Jika rentang tersimpan tersebut diberikan kepada prosesor min-max baru yang dijelaskan di atas, batas yang lebih luas dapat mengubah skalanya. Contoh ini tidak menunjukkan apa yang dimuat oleh job sebelumnya, apakah suatu dataset cocok untuk sebuah kebijakan, atau apakah suatu skor berubah.
Periksa cakupan perhitungan ulang
Panduan yang umum adalah menyesuaikan prapemrosesan yang bergantung pada data dengan set pelatihan, lalu menerapkan transformasi hasilnya secara konsisten pada data evaluasi. Pembahasan scikit-learn tentang kebocoran data menjelaskan prinsip umumnya. Issue LeRobot sebelumnya juga mengangkat kekhawatiran tentang statistik global dan validasi; pemeriksaan kami tidak memverifikasi perilaku robot yang dilaporkan dalam issue tersebut atau mendiagnosis penyebabnya. Kartu dataset SO-101 lain sudah membedakan statistik khusus pelatihan dari metadata seluruh dataset untuk evaluasi terkontrol. Kami tidak memeriksa hitungan atau file dataset tersebut.
Periksa jalur perhitungan ulang secermat pembagian episode. Pada versi yang ditetapkan, fungsi bantu recompute_stats secara bawaan menggunakan jalur data numerik yang memindai file Parquet di bawah root dataset dan mengiterasi indeks episodenya tanpa filter dataset.episodes secara langsung. Jika file tersebut masih memuat kedua partisi, memberikan objek dengan episode terpilih saja tidak membuktikan bahwa statistik numeriknya khusus untuk pelatihan. Helper ini menulis statistik ke root tersebut dan mempertahankan statistik yang ada untuk fitur yang tidak dihitung ulang; secara bawaan, fitur gambar/video dilewati. Kami tidak menjalankan helper atau mengubah dataset. Docstring-nya sudah menyebutkan bahwa helper ini mengiterasi semua episode, dan panduan dataset-tools menjelaskan operasi perhitungan ulang tersebut.
Sebelum menganggap hasil holdout independen, catat ID episode yang dipilih, revisi dataset, asal dan cakupan fitur setiap statistik, serta konfigurasi prosesor yang benar-benar digunakan. Pastikan perhitungan yang diusulkan untuk khusus pelatihan membaca baris yang dimaksud, lalu gunakan kembali transformasi yang sesuai dan diturunkan dari data pelatihan untuk evaluasi. Periksa secara terpisah fitur gambar, video, dan relative-action, yang mungkin mengikuti jalur berbeda. Prosesor pralatih atau yang melanjutkan sesi mungkin memiliki statistik tersimpan sendiri, jadi periksa checkpoint dan override yang sebenarnya digunakan alih-alih mengasumsikan perilakunya sama dengan contoh ini.
Cara kami memeriksa
Kami membaca sumber pada revisi yang ditetapkan tanpa mengimpor atau menjalankan LeRobot. Skrip analisis kami memverifikasi hash sumber, mengunduh sementara tabel metadata yang berukuran kecil, lalu menghitung pembagian hipotetis dan perbandingan min/max dengan DuckDB 1.4.4. Skrip ini menghapus tabel sementara setelah berjalan normal. Hasil agregat tidak menyimpan label tugas, ID episode individual, atau statistik per episode. Bundel pemeriksa sumber berisi skrip yang memverifikasi struktur sumber terpilih pada revisi yang ditetapkan tanpa menjalankan kode upstream, beserta lisensi dan atribusi upstream. Pembuat gambar mereproduksi kedua diagram dari data agregat. Tidak ada rekaman, frame mentah, model, job pelatihan, atau job benchmark yang digunakan.
Untuk mereproduksi di macOS atau Linux dengan Python 3.11 dan DuckDB 1.4.4:
python3.11 -m venv .lerobot-stats-venv
.lerobot-stats-venv/bin/python -m pip install duckdb==1.4.4
.lerobot-stats-venv/bin/python analyze.py > observations-reproduced.json
unzip source-check.zip -d lerobot-source-check
.lerobot-stats-venv/bin/python lerobot-source-check/source-check.py
Kartu dataset pada revisi yang ditetapkan memberi label Apache-2.0; label tersebut tidak memastikan hak atas setiap aset yang mendasarinya. Pemeriksa sumber merujuk pada ekspresi singkat dari LeRobot; lisensi pada revisi yang ditetapkan dan atribusi hak ciptanya disertakan dalam bundel pemeriksa. sapien1 menyediakan kontribusi skrip orisinalnya untuk diunduh dan dijalankan secara lokal; tidak disebutkan lisensi tambahan untuk mengubah atau mendistribusikan ulang kontribusi tersebut. Ketentuan dataset sumber dan kode upstream berlaku secara terpisah.