Pananaliksik
Maaaring gumamit ang isang LeRobot episode holdout ng mga istatistika ng normalization na mas malawak ang saklaw
Wika ng artikulo: Tagalog
Maaaring paghiwalayin ng isang team ang mga robot episode para sa evaluation at gumamit pa rin ng mga istatistika ng preprocessing na may saklaw na lampas sa mga training episode. Sinubaybayan namin ang isang paraan ng pagsasanay sa LeRobot at sinuri ang isang pampublikong snapshot ng metadata. Sa isang hypothetical na paghahati na may 40 training episode at 10 evaluation episode, ang bawat naka-save na range para sa state at action ay umaabot nang lampas sa mga range ng training episode sa tatlo sa anim na dimensyon. Paghahambing ito ng naka-save na metadata, hindi resulta ng isang naobserbahang training run o ng performance ng model. Ipinapakita nito kung bakit dapat isama sa pagsusuri ng holdout ang mga istatistikang ibinibigay sa processor pati ang listahan ng mga episode.
Magkahiwalay na desisyon ang paghahati at ang mga istatistika
Sa commit na 7910c20 ng LeRobot, pinapangkat ng isang naka-configure na eval_split ang mga napiling episode ayon sa una nilang nakalistang task at itinatalaga sa evaluation ang huling ceil(group size × eval_split) mula sa bawat pangkat. Walang evaluation split ang default na configuration; sadyang nagtakda nito ang halimbawa sa ibaba. Gumagawa ang code ng magkahiwalay na train at evaluation dataset object gamit ang mga listahan ng episode, parehong dataset root at parehong revision.
Hiwalay na nilo-load ng code na nagbabasa ng metadata ng dataset ang meta/stats.json. Sa bahagi ng code para sa pagsasanay na sinuri namin, natatanggap ng isang bagong Diffusion policy na hindi ni-resume at walang pretrained processor path ang mga istatistika ng dataset metadata kapag binubuo ang mga processor nito. Gumagamit ang default na configuration ng Diffusion ng min-max normalization para sa state at action. Partikular ang pagsubaybay sa source sa configuration at bersyong iyon; maaaring magkaiba ang ibang policy, override, pretrained o ni-resume na processor, format at bersyon.
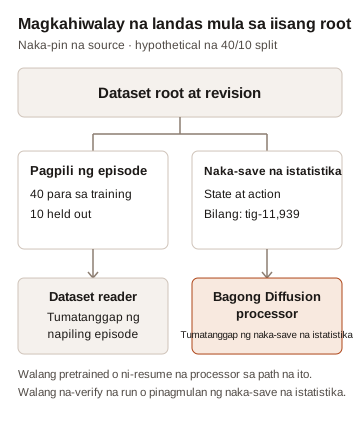
Hindi namin pinaandar ang dataset loader o isang policy. Inilalarawan ng diagram ang sinuring source path sa ilalim ng mga nakasaad na kundisyon, hindi ang tala ng isang aktuwal na run.
Isang halimbawa ng metadata
Inilalarawan ng pampublikong lerobot/svla_so101_pickplace snapshot sa revision na f641879 ang 50 episode at 11,939 frame. Pareho ang first-task grouping key ng lahat ng 50 episode record. Kung walang paunang pinili o ibinukod na episode at eval_split=0.2, itatalaga ng sinuring tuntunin ang 40 episode sa training at 10 sa evaluation. Ang mga episode summary ng mga ito ay nagtatala ng 9,180 at 2,759 frame, ayon sa pagkakasunod.
Ang mga naka-save na istatistika ng observation.state at action ay kapwa nag-uulat ng bilang na 11,939. Tugma ang mga min/max array ng mga ito sa pinagsamang halaga ng lahat ng 50 episode summary sa loob ng 1e-6 na absolute at relative tolerance. Kapag direktang inihambing sa mga pinagsamang pinakamababa at pinakamataas na halaga mula sa hypothetical na 40 training episode, mas malawak ang mga naka-save na range sa tatlo sa anim na dimensyon para sa bawat feature. Hindi nagbabago ang bilang kapag hinihinging lumampas ang pagkakaiba sa math.isclose na may 1e-6 na relative at absolute tolerance.
| Katangian | Mga dimensyon kung saan lumalampas ang naka-save na range sa range ng training episode | Pinakamakitid na range ng training episode bilang bahagi ng naka-save na range |
|---|---|---|
observation.state | 3 sa 6 | 84.3% |
action | 3 sa 6 | 84.2% |
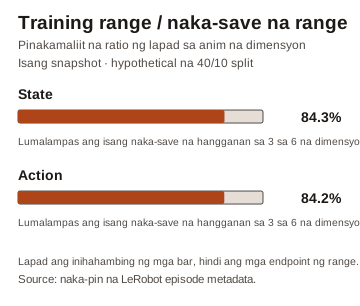
Ang bawat porsiyento ang pinakamaliit na ratio ng lapad ng range sa anim na dimensyon ng feature na iyon; hindi kailangang iisang dimensyon ang inilalarawan ng dalawang row. Lapad ang inihahambing ng mga bar, hindi kung saan nagsisimula o nagtatapos ang mga range. Kasama sa kalkulasyon para sa 40 episode ang lahat ng frame na nakatala para sa mga episode na iyon. Maaaring hindi isama ng isang aktuwal na sampler ang mga frame sa dulo, mag-sample ng mga window o gumamit ng ibang tuntunin sa pagpili, kaya hindi ito sukat ng mga posisyong ginamit ng isang tunay na optimizer.
Pinalalawak din ng mga summary ng held-out episode ang pinagsamang halaga ng lahat ng episode lampas sa pinagsamang halaga ng 40 training episode sa tatlong dimensyon para sa bawat feature. Tugma ang mga naka-save na istatistika sa pinagsamang halaga ng lahat ng episode sa loob ng nakasaad na tolerance, ngunit hindi namin hiwalay na tiniyak kung paano ginawa ang naka-save na file o na-verify ang mga pinagbatayang frame file. Kung ibibigay ang mga naka-save na range na iyon sa bagong min-max processor na inilarawan sa itaas, maaaring baguhin ng mas malawak na mga hangganan ang scale nito. Hindi ipinapakita ng halimbawa kung ano ang ni-load ng anumang nakaraang job, kung angkop ang isang dataset para sa isang policy o kung nagbago ang isang score.
Suriin ang saklaw ng muling pagkalkula
Ang karaniwang gabay ay i-fit ang preprocessing na nakadepende sa data gamit ang training set at ilapat nang pare-pareho ang resultang transformation sa evaluation data. Ipinapaliwanag ng pagtalakay ng Scikit-learn sa data leakage ang pangkalahatang prinsipyo. Naglahad din ang isang naunang ulat ng problema sa LeRobot ng mga alalahanin tungkol sa global statistics at validation; hindi bina-verify ng aming pagsusuri ang iniulat sa issue na kilos ng robot o tinutukoy ang sanhi nito. Ibinubukod na ng ibang paglalarawan ng dataset na SO-101 ang mga istatistika para lamang sa training mula sa metadata ng buong dataset para sa isang kontroladong evaluation. Hindi namin sinuri ang mga bilang o file ng dataset na iyon.
Suriin ang landas ng muling pagkalkula nang kasingsinsin ng paghahati. Sa naka-pin na bersyon, ang default ng function na recompute_stats ay isang numeric-data path na nag-i-scan ng mga Parquet file sa ilalim ng dataset root at paisa-isang pinoproseso ang mga episode index ng mga ito nang walang direktang dataset.episodes filter. Kung nasa mga file pa rin ang parehong partition, hindi sapat ang pagpasa lamang ng object na may mga napiling episode upang matiyak na para lamang sa training ang mga numeric na istatistika. Isinusulat ng function ang mga istatistika sa root na iyon at pinananatili ang mga umiiral na istatistika para sa mga feature na hindi nito muling kinakalkula; nilalaktawan ng default nito ang mga image/video feature. Hindi namin pinatakbo ang function o binago ang isang dataset. Nakasaad na sa docstring nito na pinoproseso nito ang lahat ng episode, at inilalarawan ng gabay sa mga tool para sa dataset ang operasyon ng muling pagkalkula.
Bago ituring na independent ang isang held-out na resulta, itala ang mga napiling episode ID, ang dataset revision, ang pinagmulan at saklaw ng feature ng bawat istatistika, at ang aktuwal na ginamit na processor configuration. Tiyaking binabasa ng iminungkahing kalkulasyon para lamang sa training ang mga nilalayong row, at muling gamitin para sa evaluation ang naaangkop na transformation na mula sa training. Hiwalay na suriin ang mga image, video at relative-action feature, na maaaring sumunod sa ibang mga path. Maaaring may sariling naka-save na istatistika ang isang pretrained o ni-resume na processor, kaya suriin ang aktuwal na checkpoint at mga override sa halip na ipagpalagay na pareho ang magiging asal nito sa halimbawang ito.
Paano namin sinuri
Binasa namin ang naka-pin na source nang hindi ini-import o pinapaandar ang LeRobot. Vine-verify ng aming script para sa pagsusuri ang mga source hash, pansamantalang dina-download ang maliit na metadata table, at kinakalkula ang hypothetical na paghahati at mga paghahambing ng min/max gamit ang DuckDB 1.4.4. Inaalis nito ang pansamantalang table pagkatapos ng isang normal na run. Walang pinananatiling task label, indibidwal na episode ID o istatistika ng bawat episode ang mga pinagsamang resulta. Naglalaman ang pakete ng mga file para suriin ang source code ng script na vine-verify ang mga piling naka-pin na istruktura ng source nang hindi pinapaandar ang upstream code, kasama ang upstream license at attribution. Muling ginagawa ng script na gumuguhit ng mga diagram ang dalawang diagram mula sa mga pinagsamang resulta. Walang ginamit na recording, raw frame, model, training job o benchmark job.
Para ulitin ito sa macOS o Linux gamit ang Python 3.11 at DuckDB 1.4.4:
python3.11 -m venv .lerobot-stats-venv
.lerobot-stats-venv/bin/python -m pip install duckdb==1.4.4
.lerobot-stats-venv/bin/python analyze.py > observations-reproduced.json
unzip source-check.zip -d lerobot-source-check
.lerobot-stats-venv/bin/python lerobot-source-check/source-check.py
Nilalagyan ito ng label na Apache-2.0 sa naka-pin na card ng dataset; hindi nilulutas ng label na iyon ang mga karapatan para sa bawat pinagbatayang asset. Tumutukoy ang source checker sa maiikling expression mula sa LeRobot; kasama sa checker bundle ang naka-pin na license at copyright attribution nito. Iniaalok ng sapien1 ang mga orihinal nitong kontribusyon sa script para i-download at patakbuhin nang lokal; walang nakasaad na karagdagang lisensya upang baguhin o muling ipamahagi ang mga kontribusyong iyon. Hiwalay ang mga tuntunin ng source dataset at upstream code.