Forskning
En LeRobot-uppdelning med undanhållna episoder kan använda bredare normaliseringsstatistik
Språk: Svenska
Ett team kan avsätta robotepisoder för utvärdering och ändå använda statistik för förbehandling som omfattar mer än träningsepisoderna. Vi spårade ett träningsflöde i LeRobot och granskade en offentlig ögonblicksbild av metadata. I en hypotetisk uppdelning med 40 träningsepisoder och 10 utvärderingsepisoder sträcker sig de sparade intervallen för både tillstånd och handling utanför träningsepisodernas intervall i tre av sex dimensioner. Det här är en jämförelse av sparade metadata, inte en observerad träningskörning eller ett resultat för modellens prestanda. Den visar varför en granskning av undanhållna data bör omfatta både episodlistan och den statistik som skickas till processorn.
Uppdelningen och statistiken är separata beslut
Vid LeRobot-commit 7910c20 grupperar ett konfigurerat eval_split valda episoder efter deras först angivna uppgift och tilldelar de sista ceil(group size × eval_split) i varje grupp till utvärdering. Standardkonfigurationen har ingen utvärderingsuppdelning; exemplet nedan anger en sådan avsiktligt. Koden skapar separata datasetobjekt för träning och utvärdering med hjälp av episodlistor, samma datasetrot och samma revision.
Inläsaren för datasetets metadata läser separat in meta/stats.json. I det granskade träningsflödet får en ny Diffusion-policy som inte återupptas och saknar sökväg till en förtränad processor datasetets metadatastatistik när dess processorer skapas. Standardkonfigurationen för Diffusion använder min-max-normalisering för tillstånd och handling. Källkodsspårningen gäller just den konfigurationen och versionen; andra policyer, åsidosättningar, förtränade eller återupptagna processorer, format och versioner kan skilja sig åt.
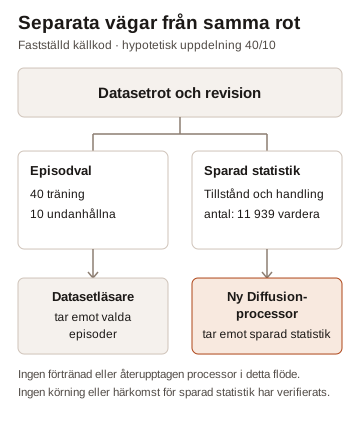
Vi körde varken datasetinläsaren eller någon policy. Diagrammet beskriver det granskade källkodsflödet under de angivna förutsättningarna, inte en faktisk körning.
Ett metadataexempel
Den offentliga ögonblicksbilden av lerobot/svla_so101_pickplace vid revision f641879 beskriver 50 episoder och 11 939 bildrutor. Alla 50 episodposter har samma grupperingsnyckel för den första uppgiften. Om inga episoder väljs eller utesluts i förväg och eval_split=0.2, skulle den granskade regeln tilldela 40 episoder till träning och 10 till utvärdering. Episodsammanfattningarna anger 9 180 respektive 2 759 bildrutor.
Den sparade statistiken för observation.state och action anger vardera ett antal på 11 939. Deras min/max-arrayer stämmer med aggregatet av alla 50 episodsammanfattningar inom en absolut och relativ tolerans på 1e-6. Jämfört direkt med extremvärdena som aggregerats från de hypotetiska 40 träningsepisoderna sträcker sig de sparade intervallen längre i tre av sex dimensioner för varje variabel. Antalet är oförändrat när en skillnad krävs utöver math.isclose med relativa och absoluta toleranser på 1e-6.
| Variabel | Dimensioner där det sparade intervallet sträcker sig utanför träningsepisodernas intervall | Smalaste intervallet för träningsepisoderna som andel av det sparade intervallet |
|---|---|---|
observation.state | 3 av 6 | 84,3 % |
action | 3 av 6 | 84,2 % |
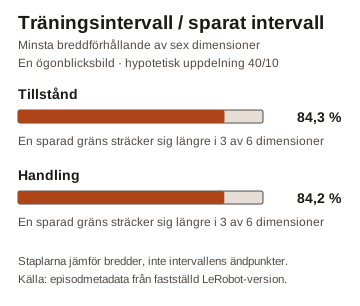
Varje procenttal är det minsta förhållandet mellan intervallbredderna för variabelns sex dimensioner; de två raderna behöver inte beskriva samma dimension. Staplarna jämför bredder, inte var intervallen börjar eller slutar. Beräkningen för 40 episoder omfattar alla bildrutor som anges för dessa episoder. En faktisk sampler kan utelämna bildrutor i slutet, välja fönster eller använda andra urvalsregler. Det är därför inte en mätning av de positioner som används av en verklig optimerare.
Sammanfattningarna för de undanhållna episoderna utvidgar också aggregatet för alla episoder utöver aggregatet för de 40 träningsepisoderna i tre dimensioner för varje variabel. Den sparade statistiken stämmer med aggregatet för alla episoder inom den angivna toleransen, men vi fastställde inte oberoende hur den sparade filen skapades och verifierade inte de underliggande bildrutefilerna. Om de sparade intervallen skickas till den nya min-max-processorn som beskrivs ovan kan de bredare gränserna ändra dess skala. Exemplet visar inte vad någon tidigare körning läste in, om ett dataset är lämpligt för en policy eller om ett resultatvärde ändrades.
Kontrollera omfattningen av en ny beräkning
Den välkända rekommendationen är att anpassa databeroende förbehandling till träningsmängden och tillämpa den resulterande transformationen konsekvent på utvärderingsdata. Scikit-learns diskussion om dataläckage förklarar den allmänna principen. Ett tidigare LeRobot-ärende tog också upp farhågor kring global statistik och validering; vår kontroll verifierar inte robotbeteendet som rapporteras i ärendet och fastställer inte heller dess orsak. Ett annat SO-101-datasetkort skiljer redan mellan statistik baserad enbart på träningsdata och metadata för hela datasetet vid en kontrollerad utvärdering. Vi kontrollerade inte det datasetets egna antal eller filer.
Granska flödet för ny beräkning lika noga som uppdelningen. I den fastställda versionen använder hjälpverktyget recompute_stats som standard ett flöde för numeriska data som söker igenom Parquet-filer under datasetroten och går igenom deras episodindex utan ett direkt dataset.episodes-filter. Om filerna fortfarande innehåller båda partitionerna räcker det inte att skicka in ett objekt med valda episoder för att fastställa att den numeriska statistiken enbart bygger på träningsdata. Hjälpverktyget skriver statistik till den roten och behåller befintlig statistik för variabler som det inte beräknar på nytt; som standard hoppar det över bild- och videovariabler. Vi körde inte hjälpverktyget och ändrade inte något dataset. Dess docstring anger redan att det går igenom alla episoder, och guiden för datasetverktyg beskriver den nya beräkningen.
Innan ett resultat från undanhållna data betraktas som oberoende bör du dokumentera valda episod-ID:n, datasetets revision, ursprung och variabelomfattning för varje statistikuppgift samt den processorkonfiguration som faktiskt användes. Kontrollera att en föreslagen beräkning som enbart använder träningsdata läser avsedda rader och återanvänd den lämpliga transformationen från träningsdata för utvärdering. Kontrollera bild-, video- och relativa handlingsvariabler separat, eftersom de kan följa andra flöden. En förtränad eller återupptagen processor kan ha egen sparad statistik, så granska den faktiska kontrollpunkten och eventuella åsidosättningar i stället för att anta att beteendet är detsamma som i exemplet.
Så kontrollerade vi
Vi läste källkoden från den fastställda versionen utan att importera eller köra LeRobot. Vårt analysskript verifierar källkodens hashvärden, laddar tillfälligt ner den lilla metadatatabellen och beräknar den hypotetiska uppdelningen och min/max-jämförelserna med DuckDB 1.4.4. Det tar bort den tillfälliga tabellen efter en normal körning. De aggregerade resultaten innehåller inga uppgiftsetiketter, enskilda episod-ID:n eller statistik per episod. Paketet för källkodskontroll innehåller ett skript som verifierar utvalda strukturer i den fastställda källkodsversionen utan att köra uppströmskod, tillsammans med uppströmslicensen och källangivelse. Figurgeneratorn återskapar de två diagrammen från aggregatet. Inga inspelningar, råa bildrutor, modeller, träningsjobb eller benchmarkjobb användes.
För att återskapa resultaten på macOS eller Linux med Python 3.11 och DuckDB 1.4.4:
python3.11 -m venv .lerobot-stats-venv
.lerobot-stats-venv/bin/python -m pip install duckdb==1.4.4
.lerobot-stats-venv/bin/python analyze.py > observations-reproduced.json
unzip source-check.zip -d lerobot-source-check
.lerobot-stats-venv/bin/python lerobot-source-check/source-check.py
Datasetets kort för den fastställda versionen anger Apache-2.0; den märkningen fastställer inte rättigheterna till varje underliggande tillgång. Källkodskontrollen hänvisar till korta uttryck från LeRobot; licensen för den fastställda versionen och upphovsrättsangivelsen ingår i kontrollpaketet. sapien1 erbjuder sina ursprungliga skriptbidrag för nedladdning och lokal körning; ingen ytterligare licens för att ändra eller distribuera dessa bidrag anges. Källdatasetets och uppströmskodens villkor gäller separat.