Investigación
Una partición de evaluación por episodios de LeRobot puede usar estadísticas de normalización de mayor alcance
Idioma: Español
Un equipo puede separar episodios de robot para evaluación y seguir usando estadísticas de preprocesamiento cuyo alcance vaya más allá de los episodios de entrenamiento. Seguimos una ruta de entrenamiento de LeRobot y comprobamos una instantánea pública de metadatos. En una división hipotética de 40 episodios de entrenamiento y 10 de evaluación, los rangos guardados de estado y acción se extienden más allá de los rangos de los episodios de entrenamiento en tres de seis dimensiones para cada característica. Esta es una comparación de metadatos guardados, no una ejecución de entrenamiento observada ni un resultado de rendimiento del modelo. Ilustra por qué una revisión de la partición de evaluación debe incluir tanto las estadísticas suministradas al procesador como la lista de episodios.
La división y las estadísticas son decisiones independientes
En el commit 7910c20 de LeRobot, un eval_split configurado agrupa los episodios seleccionados por su primera tarea indicada y asigna a evaluación los últimos ceil(group size × eval_split) de cada grupo. La configuración predeterminada no tiene una partición de evaluación; el ejemplo siguiente establece una deliberadamente. El código construye objetos de conjunto de datos separados para entrenamiento y evaluación usando listas de episodios, la misma raíz del conjunto de datos y la misma revisión.
El cargador de metadatos del conjunto de datos carga meta/stats.json por separado. En la ruta de entrenamiento inspeccionada, una política Diffusion nueva, no reanudada y sin una ruta de procesador preentrenado recibe las estadísticas de los metadatos del conjunto de datos al crear sus procesadores. La configuración predeterminada de Diffusion usa normalización mín.-máx. para el estado y la acción. El seguimiento del código fuente corresponde a esa configuración y versión; otras políticas, ajustes, procesadores preentrenados o reanudados, formatos y versiones pueden diferir.
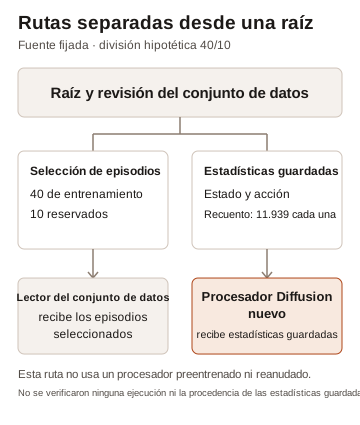
No ejecutamos el cargador del conjunto de datos ni una política. El diagrama describe la ruta del código fuente inspeccionada en las condiciones indicadas, no el registro de una ejecución real.
Un ejemplo de metadatos
La instantánea pública de lerobot/svla_so101_pickplace en la revisión f641879 describe 50 episodios y 11.939 fotogramas. Los registros de los 50 episodios comparten la misma clave de agrupación por primera tarea. Si no se preselecciona ni excluye ningún episodio y eval_split=0.2, la regla inspeccionada asignaría 40 episodios a entrenamiento y 10 a evaluación. Sus resúmenes de episodios declaran 9.180 y 2.759 fotogramas, respectivamente.
Las estadísticas guardadas de observation.state y action registran cada una un recuento de 11.939. Sus matrices de mínimos y máximos coinciden con el agregado de los resúmenes de los 50 episodios dentro de una tolerancia absoluta y relativa de 1e-6. En comparación directa con los valores extremos agregados de los 40 episodios de entrenamiento hipotéticos, los rangos guardados se extienden más en tres de seis dimensiones para cada característica. El número de dimensiones no cambia si se exige una diferencia que supere el criterio de math.isclose con tolerancias relativa y absoluta de 1e-6.
| Característica | Dimensiones en las que el rango guardado supera al de los episodios de entrenamiento | Rango más estrecho de los episodios de entrenamiento como proporción del rango guardado |
|---|---|---|
observation.state | 3 de 6 | 84,3 % |
action | 3 de 6 | 84,2 % |
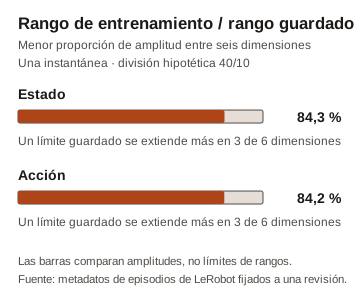
Cada porcentaje es la menor proporción entre amplitudes de rango de las seis dimensiones de esa característica; las dos filas no tienen por qué describir la misma dimensión. Las barras comparan amplitudes, no dónde empiezan o terminan los rangos. El cálculo de los 40 episodios incluye todos los fotogramas declarados para esos episodios. Un muestreador real puede descartar fotogramas finales, muestrear ventanas o usar otras reglas de selección, por lo que este cálculo no mide las posiciones utilizadas por un optimizador real.
Los resúmenes de los episodios reservados también amplían el agregado de todos los episodios más allá del agregado de los 40 episodios de entrenamiento en tres dimensiones para cada característica. Las estadísticas guardadas coinciden con el agregado de todos los episodios dentro de la tolerancia indicada, pero no establecimos de forma independiente cómo se produjo el archivo guardado ni verificamos los archivos de fotogramas subyacentes. Si esos rangos guardados se suministran al procesador mín.-máx. nuevo descrito anteriormente, los límites más amplios pueden cambiar su escala. El ejemplo no muestra qué cargó ningún trabajo anterior, si un conjunto de datos es adecuado para una política ni si cambió alguna puntuación.
Comprueba el alcance de un recálculo
La recomendación habitual es ajustar el preprocesamiento que depende de los datos al conjunto de entrenamiento y aplicar la transformación resultante de forma coherente a los datos de evaluación. La explicación de Scikit-learn sobre la fuga de datos describe el principio general. Un issue anterior de LeRobot también planteó inquietudes sobre las estadísticas globales y la validación; nuestra comprobación no verifica el comportamiento del robot descrito en ese issue ni diagnostica su causa. Otra tarjeta de conjunto de datos SO-101 ya distingue las estadísticas exclusivas de entrenamiento de los metadatos del conjunto de datos completo para una evaluación controlada. No comprobamos los recuentos ni los archivos de ese conjunto de datos.
Inspecciona la ruta de recálculo con tanto cuidado como la división. En la versión fijada, la función auxiliar recompute_stats usa por defecto una ruta de datos numéricos que examina los archivos Parquet bajo la raíz del conjunto de datos y recorre sus índices de episodios sin un filtro directo de dataset.episodes. Si esos archivos aún contienen ambas particiones, pasar únicamente un objeto con episodios seleccionados no demuestra que las estadísticas numéricas correspondan solo al entrenamiento. La función auxiliar escribe las estadísticas en esa raíz y conserva las estadísticas existentes de las características que no recalcula; por defecto omite las características de imagen y vídeo. No ejecutamos la función auxiliar ni modificamos ningún conjunto de datos. Su cadena de documentación ya indica que recorre todos los episodios, y la guía de herramientas de conjuntos de datos describe la operación de recálculo.
Antes de considerar independiente un resultado obtenido con datos reservados, registra los ID de los episodios seleccionados, la revisión del conjunto de datos, el origen y el alcance por característica de cada estadística, y la configuración del procesador realmente utilizada. Verifica que un cálculo propuesto solo para entrenamiento lea las filas previstas y reutiliza para la evaluación la transformación adecuada derivada del entrenamiento. Comprueba por separado las características de imagen, vídeo y acción relativa, que pueden seguir rutas distintas. Un procesador preentrenado o reanudado puede tener sus propias estadísticas guardadas, así que inspecciona el punto de control y los ajustes realmente usados en lugar de dar por supuesto el comportamiento de este ejemplo.
Cómo lo comprobamos
Leímos el código fuente fijado sin importar ni ejecutar LeRobot. Nuestro script de análisis verifica los hashes del código fuente, descarga temporalmente la pequeña tabla de metadatos y calcula la división hipotética y las comparaciones de mínimos y máximos con DuckDB 1.4.4. Elimina la tabla temporal tras una ejecución normal. Los resultados agregados no conservan etiquetas de tareas, ID de episodios individuales ni estadísticas por episodio. El paquete de comprobación del código fuente contiene un script que verifica determinadas estructuras del código fuente fijado sin ejecutar el código original, junto con la licencia y la atribución correspondientes. El generador de figuras reproduce los dos diagramas a partir del agregado. No se usaron grabaciones, fotogramas sin procesar, modelos ni trabajos de entrenamiento o evaluación comparativa.
Para reproducirlo en macOS o Linux con Python 3.11 y DuckDB 1.4.4:
python3.11 -m venv .lerobot-stats-venv
.lerobot-stats-venv/bin/python -m pip install duckdb==1.4.4
.lerobot-stats-venv/bin/python analyze.py > observations-reproduced.json
unzip source-check.zip -d lerobot-source-check
.lerobot-stats-venv/bin/python lerobot-source-check/source-check.py
La tarjeta fijada del conjunto de datos lo identifica como Apache-2.0; esa etiqueta no determina los derechos de todos los recursos subyacentes. El comprobador del código fuente hace referencia a expresiones breves de LeRobot; la licencia fijada y la atribución de derechos de autor están incluidas en el paquete del comprobador. sapien1 ofrece sus contribuciones originales al script para su descarga y ejecución local; no se declara ninguna licencia adicional para modificar o redistribuir esas contribuciones. Las condiciones del conjunto de datos de origen y del código original son independientes.