Forschung
Ein LeRobot-Episoden-Holdout kann umfassendere Normalisierungsstatistiken verwenden
Sprache: Deutsch
Ein Team kann Roboter-Episoden für die Evaluierung zurückhalten und dennoch Vorverarbeitungsstatistiken verwenden, die über die Trainingsepisoden hinausreichen. Wir haben einen Trainingspfad in LeRobot nachverfolgt und einen öffentlichen Metadaten-Snapshot geprüft. Bei einer hypothetischen Aufteilung in 40 Trainings- und 10 Evaluierungsepisoden reichen die gespeicherten Wertebereiche für Zustand und Aktion jeweils in drei von sechs Dimensionen über die Bereiche der Trainingsepisoden hinaus. Dies ist ein Vergleich gespeicherter Metadaten, kein beobachteter Trainingslauf und kein Ergebnis zur Modellleistung. Das Beispiel zeigt, warum bei der Prüfung eines Holdouts neben der Episodenliste auch die dem Prozessor übergebenen Statistiken berücksichtigt werden sollten.
Aufteilung und Statistiken sind getrennte Entscheidungen
Beim LeRobot-Commit 7910c20 gruppiert ein konfigurierter eval_split die ausgewählten Episoden nach ihrer jeweils zuerst aufgeführten Aufgabe und weist die letzten ceil(group size × eval_split) jeder Gruppe der Evaluierung zu. Die Standardkonfiguration sieht keine Evaluierungsaufteilung vor; das folgende Beispiel legt bewusst eine fest. Der Code erstellt anhand von Episodenlisten separate Datensatzobjekte für Training und Evaluierung, die dasselbe Datensatzverzeichnis und dieselbe Revision verwenden.
Der Metadatenlader des Datensatzes lädt meta/stats.json separat. Im untersuchten Trainingspfad erhält eine neue Diffusion-Policy, die nicht fortgesetzt wird und für die kein Pfad zu einem vortrainierten Prozessor angegeben ist, beim Erstellen ihrer Prozessoren die Statistiken aus den Datensatzmetadaten. Die Standardkonfiguration von Diffusion verwendet für Zustand und Aktion eine Min-Max-Normalisierung. Die Quellcodeanalyse bezieht sich auf diese Konfiguration und Version; andere Policies, Überschreibungen, vortrainierte oder fortgesetzte Prozessoren, Formate und Versionen können abweichen.
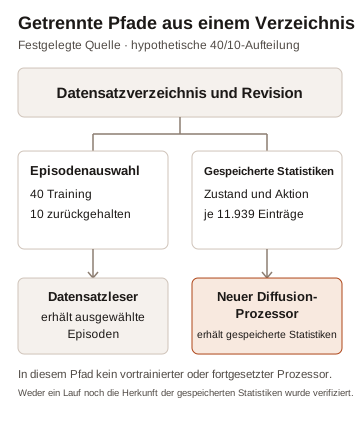
Wir haben weder den Datensatzlader noch eine Policy ausgeführt. Das Diagramm beschreibt den untersuchten Quellcodepfad unter den genannten Bedingungen und dokumentiert keinen tatsächlichen Lauf.
Ein Metadatenbeispiel
Der öffentliche lerobot/svla_so101_pickplace-Snapshot mit der Revision f641879 beschreibt 50 Episoden und 11.939 Frames. Alle 50 Episodendatensätze haben denselben Gruppierungsschlüssel für die erste Aufgabe. Wenn keine Episoden vorausgewählt oder ausgeschlossen werden und eval_split=0.2 gilt, würde die untersuchte Regel 40 Episoden dem Training und 10 der Evaluierung zuweisen. Die jeweiligen Episodenzusammenfassungen weisen 9.180 beziehungsweise 2.759 Frames aus.
Die gespeicherten Statistiken für observation.state und action weisen jeweils 11.939 Einträge aus. Ihre Min-/Max-Arrays stimmen innerhalb einer absoluten und relativen Toleranz von 1e-6 mit der Aggregation aller 50 Episodenzusammenfassungen überein. Im direkten Vergleich mit den aggregierten Extremwerten der hypothetischen 40 Trainingsepisoden reichen die gespeicherten Bereiche für jedes Merkmal in drei von sechs Dimensionen weiter. Die Anzahl bleibt gleich, wenn eine Differenz verlangt wird, die über die Prüfung mit math.isclose bei relativen und absoluten Toleranzen von 1e-6 hinausgeht.
| Merkmal | Dimensionen, in denen der gespeicherte Bereich über den Bereich der Trainingsepisoden hinausreicht | Schmalster Bereich der Trainingsepisoden im Verhältnis zum gespeicherten Bereich |
|---|---|---|
observation.state | 3 von 6 | 84,3 % |
action | 3 von 6 | 84,2 % |
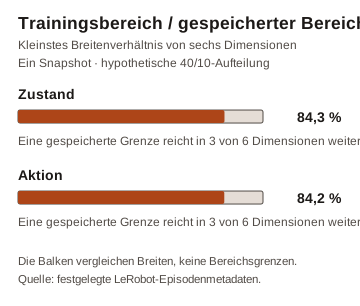
Jeder Prozentwert ist das kleinste Verhältnis der Bereichsbreiten unter den sechs Dimensionen des jeweiligen Merkmals; die beiden Zeilen müssen nicht dieselbe Dimension beschreiben. Die Balken vergleichen Breiten, nicht den Anfang oder das Ende der Bereiche. Die Berechnung für 40 Episoden umfasst alle für diese Episoden ausgewiesenen Frames. Ein tatsächlicher Sampler kann Frames am Ende weglassen, Fenster abtasten oder andere Auswahlregeln verwenden. Die Berechnung misst daher nicht die Positionen, die ein realer Optimierer verwendet.
Auch die Zusammenfassungen der zurückgehaltenen Episoden erweitern die Aggregation aller Episoden gegenüber der Aggregation der 40 Trainingsepisoden für jedes Merkmal in drei Dimensionen. Die gespeicherten Statistiken stimmen innerhalb der angegebenen Toleranz mit der Aggregation aller Episoden überein. Wir haben jedoch nicht unabhängig festgestellt, wie die gespeicherte Datei erzeugt wurde, oder die zugrunde liegenden Frame-Dateien überprüft. Werden diese gespeicherten Bereiche dem oben beschriebenen neuen Min-Max-Prozessor übergeben, können die weiter reichenden Grenzen dessen Skalierung ändern. Das Beispiel zeigt nicht, was ein früherer Job geladen hat, ob ein Datensatz für eine Policy geeignet ist oder ob sich ein Ergebniswert verändert hat.
Den Umfang einer Neuberechnung prüfen
Die gängige Empfehlung lautet, datenabhängige Vorverarbeitung anhand des Trainingsdatensatzes anzupassen und die resultierende Transformation einheitlich auf Evaluierungsdaten anzuwenden. Scikit-learns Erläuterung zu Data Leakage erklärt das allgemeine Prinzip. Auch in einem früheren LeRobot-Issue wurden Bedenken zu globalen Statistiken und Validierung geäußert; unsere Prüfung bestätigt weder das dort berichtete Roboterverhalten noch diagnostiziert sie dessen Ursache. Eine andere SO-101-Datensatzkarte unterscheidet für eine kontrollierte Evaluierung bereits zwischen Statistiken, die nur auf Trainingsdaten beruhen, und Metadaten des gesamten Datensatzes. Wir haben die Anzahlen und Dateien dieses Datensatzes nicht geprüft.
Prüfe den Pfad der Neuberechnung genauso sorgfältig wie die Aufteilung. In der festgelegten Version verwendet die Hilfsfunktion recompute_stats standardmäßig einen Pfad für numerische Daten, der Parquet-Dateien im Datensatzverzeichnis durchsucht und deren Episodenindizes ohne direkten dataset.episodes-Filter durchläuft. Wenn diese Dateien weiterhin beide Teilmengen enthalten, belegt die bloße Übergabe eines Objekts mit ausgewählten Episoden nicht, dass die numerischen Statistiken ausschließlich auf Trainingsdaten beruhen. Die Hilfsfunktion schreibt Statistiken in dieses Verzeichnis und behält vorhandene Statistiken für Merkmale bei, die sie nicht neu berechnet; standardmäßig überspringt sie Bild- und Videomerkmale. Wir haben die Hilfsfunktion nicht ausgeführt und keinen Datensatz verändert. Ihr Docstring besagt bereits, dass sie alle Episoden durchläuft, und der Leitfaden zu Datensatzwerkzeugen beschreibt die Neuberechnung.
Bevor du ein Ergebnis aus zurückgehaltenen Daten als unabhängig betrachtest, dokumentiere die ausgewählten Episoden-IDs, die Datensatzrevision, Herkunft und Merkmalsumfang jeder Statistik sowie die tatsächlich verwendete Prozessorkonfiguration. Prüfe, ob eine geplante Berechnung ausschließlich auf Trainingsdaten die vorgesehenen Zeilen liest, und verwende für die Evaluierung erneut die passende, aus Trainingsdaten abgeleitete Transformation. Prüfe Bild-, Video- und relative Aktionsmerkmale separat, da sie anderen Pfaden folgen können. Ein vortrainierter oder fortgesetzter Prozessor kann eigene gespeicherte Statistiken haben. Untersuche daher den tatsächlich verwendeten Checkpoint und die Überschreibungen, statt vom Verhalten dieses Beispiels auszugehen.
So haben wir geprüft
Wir haben den Quellcode der festgelegten Version gelesen, ohne LeRobot zu importieren oder auszuführen. Unser Analyseskript überprüft Quellcode-Hashes, lädt die kleine Metadatentabelle vorübergehend herunter und berechnet mit DuckDB 1.4.4 die hypothetische Aufteilung sowie die Min-/Max-Vergleiche. Nach einem normalen Lauf entfernt es die temporäre Tabelle. Die aggregierten Ergebnisse enthalten keine Aufgabenbezeichnungen, einzelnen Episoden-IDs oder Statistiken pro Episode. Das Quellcodeprüfer-Paket enthält ein Skript, das ausgewählte Strukturen des festgelegten Quellcodes überprüft, ohne Upstream-Code auszuführen, sowie die zugehörige Lizenz und Quellenangabe. Der Abbildungsgenerator erstellt die beiden Diagramme aus dem Aggregat erneut. Es wurden keine Aufzeichnungen, Roh-Frames, Modelle, Trainings- oder Benchmark-Jobs verwendet.
Zur Reproduktion unter macOS oder Linux mit Python 3.11 und DuckDB 1.4.4:
python3.11 -m venv .lerobot-stats-venv
.lerobot-stats-venv/bin/python -m pip install duckdb==1.4.4
.lerobot-stats-venv/bin/python analyze.py > observations-reproduced.json
unzip source-check.zip -d lerobot-source-check
.lerobot-stats-venv/bin/python lerobot-source-check/source-check.py
Die festgelegte Datensatzkarte kennzeichnet den Datensatz mit Apache-2.0; diese Kennzeichnung klärt nicht die Rechte an jedem zugrunde liegenden Asset. Der Quellcodeprüfer verweist auf kurze Ausdrücke aus LeRobot; die zugehörige festgelegte Lizenz und der Urheberrechtshinweis sind im Prüfer-Paket enthalten. sapien1 bietet seine eigenen Skriptbeiträge zum Herunterladen und zur lokalen Ausführung an; eine darüber hinausgehende Lizenz zur Änderung oder Weiterverbreitung dieser Beiträge wird nicht angegeben. Für den Quelldatensatz und den Upstream-Code gelten separate Bedingungen.