Výzkum
Oddělení epizod LeRobot pro vyhodnocení může využívat statistiky normalizace se širším rozsahem
Jazyk: Čeština
Tým může oddělit epizody robota pro vyhodnocení a přesto použít statistiky pro předzpracování, které zahrnují i jiná data než trénovací epizody. Prošli jsme jednu cestu trénování v LeRobot a ověřili veřejný snímek metadat. Při hypotetickém rozdělení na 40 trénovacích a 10 vyhodnocovacích epizod přesahují uložené rozsahy stavů i akcí rozsahy trénovacích epizod vždy ve třech ze šesti dimenzí. Jde o porovnání uložených metadat, nikoli o pozorovaný průběh trénování nebo výsledek měření výkonu modelu. Příklad ukazuje, proč by kontrola oddělené vyhodnocovací sady měla vedle seznamu epizod zahrnovat i statistiky předávané procesoru.
Rozdělení a statistiky jsou samostatná rozhodnutí
V commitu LeRobot 7910c20 nastavený parametr eval_split seskupí vybrané epizody podle jejich první uvedené úlohy a z každé skupiny přiřadí k vyhodnocení posledních ceil(group size × eval_split) epizod. Výchozí konfigurace rozdělení pro vyhodnocení neobsahuje; níže uvedený příklad ho záměrně nastavuje. Kód vytváří samostatné objekty trénovací a vyhodnocovací datové sady pomocí seznamů epizod, stejného kořenového adresáře datové sady a stejné revize.
Načítání metadat datové sady samostatně načítá meta/stats.json. Ve zkoumané cestě trénování získá nově vytvořená politika Diffusion, která nepokračuje v přerušeném trénování a nemá zadanou cestu k předtrénovanému procesoru, při sestavení procesorů statistiky z metadat datové sady. Výchozí konfigurace Diffusion používá pro stav a akci normalizaci min-max. Analýza zdrojového kódu se vztahuje k této konkrétní konfiguraci a verzi; jiné politiky, přepsaná nastavení, předtrénované nebo obnovené procesory, formáty a verze se mohou lišit.
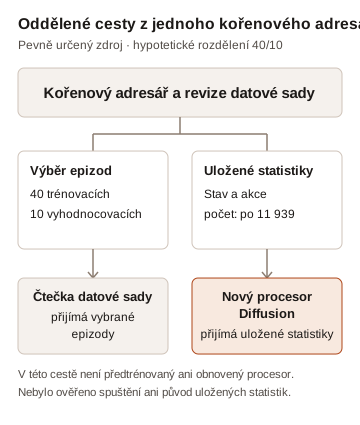
Načítání datové sady ani žádnou politiku jsme nespustili. Schéma popisuje zkoumanou cestu ve zdrojovém kódu za uvedených podmínek, nikoli záznam skutečného spuštění.
Příklad metadat
Veřejný snímek lerobot/svla_so101_pickplace v revizi f641879 popisuje 50 epizod a 11 939 snímků. Všech 50 záznamů epizod má stejný klíč pro seskupení podle první úlohy. Pokud nejsou žádné epizody předem vybrány ani vyloučeny a platí eval_split=0.2, zkoumané pravidlo by přiřadilo 40 epizod k trénování a 10 k vyhodnocení. Souhrny těchto epizod uvádějí 9 180, respektive 2 759 snímků.
Uložené statistiky observation.state a action vykazují každá počet 11 939. Jejich pole minim a maxim odpovídají agregátu souhrnů všech 50 epizod v rámci absolutní a relativní tolerance 1e-6. Při přímém porovnání s extrémními hodnotami agregovanými z hypotetických 40 trénovacích epizod přesahují uložené rozsahy u každého příznaku rozsahy trénovacích epizod ve třech ze šesti dimenzí. Počet se nemění ani při požadavku, aby rozdíl přesahoval toleranci funkce math.isclose s relativní a absolutní tolerancí 1e-6.
| Příznak | Dimenze, v nichž uložený rozsah přesahuje rozsah trénovacích epizod | Nejužší rozsah trénovacích epizod jako podíl uloženého rozsahu |
|---|---|---|
observation.state | 3 ze 6 | 84,3 % |
action | 3 ze 6 | 84,2 % |
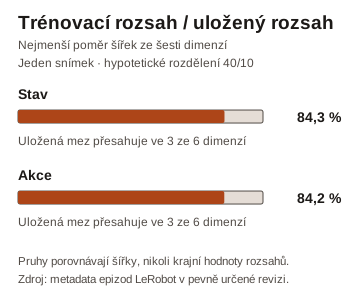
Každá procentní hodnota představuje nejmenší poměr šířek rozsahů ze šesti dimenzí daného příznaku; oba řádky nemusí popisovat stejnou dimenzi. Pruhy porovnávají šířky, nikoli začátky či konce rozsahů. Výpočet pro 40 epizod zahrnuje všechny snímky uvedené pro tyto epizody. Skutečný vzorkovací mechanismus může koncové snímky vynechávat, vybírat časová okna nebo používat jiná pravidla výběru, takže nejde o měření pozic použitých skutečným optimalizátorem.
Souhrny oddělených vyhodnocovacích epizod také rozšiřují agregát všech epizod oproti agregátu 40 trénovacích epizod ve třech dimenzích každého příznaku. Uložené statistiky odpovídají agregátu všech epizod v rámci uvedené tolerance, nezjistili jsme však nezávisle, jak byl uložený soubor vytvořen, ani jsme neověřili podkladové soubory se snímky. Pokud jsou tyto uložené rozsahy předány výše popsanému novému procesoru min-max, mohou širší meze změnit jeho měřítko. Příklad neukazuje, co načetla jakákoli dřívější úloha, zda je datová sada vhodná pro určitou politiku ani zda se změnilo skóre.
Ověřte rozsah přepočtu
Běžné doporučení je určit parametry předzpracování závislého na datech podle trénovací sady a výslednou transformaci konzistentně použít na vyhodnocovací data. Obecný princip vysvětluje pojednání knihovny scikit-learn o úniku dat. V dřívějším hlášení problému v LeRobot zazněly také obavy ohledně globálních statistik a validace; naše kontrola neověřuje popsané chování robota ani neurčuje jeho příčinu. Jiná karta datové sady SO-101 již pro kontrolované vyhodnocení rozlišuje statistiky pouze z trénovacích dat od metadat celé datové sady. Počty ani soubory této datové sady jsme neověřovali.
Cestu přepočtu prověřte stejně pečlivě jako rozdělení dat. V pevně určené verzi používá pomocná funkce recompute_stats ve výchozím nastavení cestu pro číselná data, která prochází soubory Parquet v kořenovém adresáři datové sady a iteruje přes jejich indexy epizod bez přímého filtru dataset.episodes. Pokud tyto soubory stále obsahují obě části, samotné předání objektu s vybranými epizodami nedokládá, že číselné statistiky pocházejí pouze z trénovacích dat. Funkce zapisuje statistiky do tohoto kořenového adresáře a zachovává stávající statistiky příznaků, které nepřepočítává; ve výchozím nastavení vynechává obrazové a video příznaky. Funkci jsme nespustili ani jsme neupravili datovou sadu. Její dokumentační řetězec již uvádí, že prochází všechny epizody, a operaci přepočtu popisuje průvodce nástroji pro datové sady.
Než začnete výsledek z oddělené vyhodnocovací sady považovat za nezávislý, zaznamenejte ID vybraných epizod, revizi datové sady, původ a rozsah příznaků každé statistiky a skutečně použitou konfiguraci procesoru. Ověřte, že navržený výpočet pouze z trénovacích dat čte zamýšlené řádky, a pro vyhodnocení znovu použijte příslušnou transformaci odvozenou z trénovacích dat. Samostatně zkontrolujte obrazové, video a relativní akční příznaky, které mohou sledovat odlišné cesty. Předtrénovaný nebo obnovený procesor může mít vlastní uložené statistiky, proto prověřte skutečný kontrolní bod a přepsaná nastavení a nepředpokládejte, že se chová jako v tomto příkladu.
Jak jsme postupovali při ověření
Přečetli jsme zdrojový kód v pevně určené revizi, aniž bychom LeRobot importovali nebo spustili. Náš analytický skript ověřuje hashe zdrojových souborů, dočasně stahuje malou tabulku metadat a pomocí DuckDB 1.4.4 počítá hypotetické rozdělení a porovnání minim a maxim. Po běžném dokončení dočasnou tabulku odstraní. Agregované výsledky neuchovávají názvy úloh, ID jednotlivých epizod ani statistiky jednotlivých epizod. Balíček pro kontrolu zdrojového kódu obsahuje skript, který ověřuje vybrané struktury zdrojového kódu v pevně určené revizi bez spuštění původního kódu, spolu s původní licencí a uvedením autorství. Generátor obrázků z agregovaných výsledků znovu vytvoří obě schémata. Nebyly použity žádné záznamy, nezpracované snímky, model ani úloha trénování či srovnávacího testování.
Pro zopakování na macOS nebo Linuxu s Pythonem 3.11 a DuckDB 1.4.4:
python3.11 -m venv .lerobot-stats-venv
.lerobot-stats-venv/bin/python -m pip install duckdb==1.4.4
.lerobot-stats-venv/bin/python analyze.py > observations-reproduced.json
unzip source-check.zip -d lerobot-source-check
.lerobot-stats-venv/bin/python lerobot-source-check/source-check.py
Karta datové sady v pevně určené revizi ji označuje licencí Apache-2.0; toto označení samo o sobě neurčuje práva ke každému podkladovému materiálu. Nástroj pro kontrolu zdrojového kódu odkazuje na krátké výrazy z LeRobot; jeho licence v pevně určené revizi a uvedení autorských práv jsou součástí balíčku nástroje. sapien1 nabízí své původní příspěvky ke skriptům ke stažení a místnímu spuštění; žádná další licence k úpravám nebo dalšímu šíření těchto příspěvků není uvedena. Podmínky zdrojové datové sady a původního kódu jsou samostatné.