Pesquisa
Uma separação de episódios do LeRobot para avaliação pode usar estatísticas de normalização mais abrangentes
Idioma: Português (Brasil)
Uma equipe pode separar episódios de robôs para avaliação e ainda usar estatísticas de pré-processamento cujo escopo vai além dos episódios de treinamento. Analisamos um fluxo de treinamento do LeRobot e verificamos um snapshot público de metadados. Em uma divisão hipotética de 40 episódios de treinamento e 10 de avaliação, os intervalos salvos de estado e ação ultrapassam os intervalos dos episódios de treinamento em três de seis dimensões para cada um. Esta é uma comparação de metadados salvos, não uma execução de treinamento observada nem um resultado de desempenho do modelo. Ela ilustra por que uma revisão da separação para avaliação deve incluir tanto as estatísticas fornecidas ao processador quanto a lista de episódios.
A divisão e as estatísticas são decisões distintas
No commit 7910c20 do LeRobot, um eval_split configurado agrupa os episódios selecionados pela primeira tarefa listada e atribui os últimos ceil(group size × eval_split) de cada grupo à avaliação. A configuração padrão não tem divisão para avaliação; o exemplo abaixo define uma intencionalmente. O código cria objetos de conjunto de dados separados para treinamento e avaliação usando listas de episódios, a mesma raiz de conjunto de dados e a mesma revisão.
O carregador de metadados do conjunto de dados carrega meta/stats.json separadamente. No fluxo de treinamento analisado, uma política Diffusion nova, não retomada e sem caminho para um processador pré-treinado recebe as estatísticas dos metadados do conjunto de dados quando seus processadores são criados. A configuração padrão do Diffusion usa normalização mín-máx para estado e ação. A análise do código-fonte é específica dessa configuração e versão; outras políticas, substituições de configuração, processadores pré-treinados ou retomados, formatos e versões podem ser diferentes.
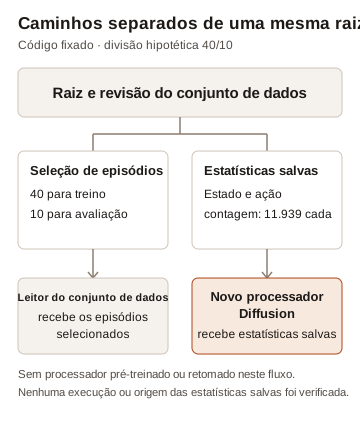
Não executamos o carregador do conjunto de dados nem uma política. O diagrama descreve o fluxo de código analisado nas condições informadas, não o registro de uma execução real.
Um exemplo de metadados
O snapshot público de lerobot/svla_so101_pickplace na revisão f641879 descreve 50 episódios e 11.939 quadros. Todos os 50 registros de episódios compartilham a mesma chave de agrupamento pela primeira tarefa. Se nenhum episódio for pré-selecionado ou excluído e eval_split=0.2, a regra analisada atribuirá 40 episódios ao treinamento e 10 à avaliação. Os resumos desses episódios declaram 9.180 e 2.759 quadros, respectivamente.
As estatísticas salvas de observation.state e action informam uma contagem de 11.939 cada. Seus arrays de mín/máx correspondem à agregação dos resumos dos 50 episódios dentro da tolerância absoluta e relativa de 1e-6. Em comparação direta com os valores extremos agregados dos 40 episódios hipotéticos de treinamento, os intervalos salvos vão além em três de seis dimensões para cada atributo. Essa contagem não muda quando se exige uma diferença maior que a tolerância de math.isclose, com tolerâncias relativa e absoluta de 1e-6.
| Atributo | Dimensões em que o intervalo salvo ultrapassa o dos episódios de treinamento | Intervalo mais estreito dos episódios de treinamento como proporção do intervalo salvo |
|---|---|---|
observation.state | 3 de 6 | 84,3% |
action | 3 de 6 | 84,2% |
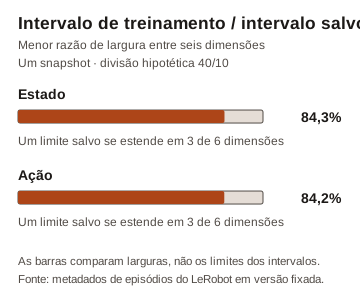
Cada percentual é a menor razão de largura de intervalo entre as seis dimensões do respectivo atributo; as duas linhas não necessariamente descrevem a mesma dimensão. As barras comparam larguras, não os pontos em que os intervalos começam ou terminam. O cálculo dos 40 episódios inclui todos os quadros declarados para esses episódios. Um amostrador real pode descartar quadros finais, amostrar janelas ou usar outras regras de seleção, portanto essa não é uma medição das posições usadas por um otimizador real.
Os resumos dos episódios reservados para avaliação também ampliam a agregação de todos os episódios em relação à agregação dos 40 episódios de treinamento em três dimensões para cada atributo. As estatísticas salvas correspondem à agregação de todos os episódios dentro da tolerância informada, mas não estabelecemos de forma independente como o arquivo salvo foi produzido nem verificamos os arquivos de quadros subjacentes. Se esses intervalos salvos forem fornecidos ao novo processador mín-máx descrito acima, os limites mais amplos poderão alterar sua escala. O exemplo não mostra o que alguma tarefa anterior carregou, se um conjunto de dados é adequado para uma política ou se uma pontuação mudou.
Verifique o escopo de um recálculo
A orientação conhecida é ajustar o pré-processamento dependente dos dados no conjunto de treinamento e aplicar a transformação resultante de maneira consistente aos dados de avaliação. A discussão do scikit-learn sobre vazamento de dados explica o princípio geral. Uma issue anterior do LeRobot também levantou preocupações sobre estatísticas globais e validação; nossa verificação não confirma o comportamento do robô relatado na issue nem diagnostica sua causa. Um cartão de outro conjunto de dados SO-101 já diferencia estatísticas calculadas apenas com dados de treinamento dos metadados do conjunto completo para uma avaliação controlada. Não verificamos as contagens nem os arquivos desse conjunto de dados.
Analise o fluxo de recálculo com o mesmo cuidado dedicado à divisão. Na versão fixada, o auxiliar recompute_stats usa por padrão um fluxo para dados numéricos que varre arquivos Parquet na raiz do conjunto de dados e percorre seus índices de episódios sem um filtro direto por dataset.episodes. Se esses arquivos ainda contiverem ambas as partições, passar apenas um objeto com episódios selecionados não comprova que as estatísticas numéricas sejam exclusivas do treinamento. O auxiliar grava as estatísticas nessa raiz e mantém as existentes para atributos que não recalcula; por padrão, ele ignora atributos de imagem e vídeo. Não executamos o auxiliar nem alteramos um conjunto de dados. Sua docstring já informa que ele percorre todos os episódios, e o guia de ferramentas de conjuntos de dados descreve a operação de recálculo.
Antes de considerar independente um resultado obtido com dados reservados para avaliação, registre os IDs dos episódios selecionados, a revisão do conjunto de dados, a origem e o escopo de atributos de cada estatística e a configuração do processador efetivamente usada. Verifique se um cálculo proposto apenas com dados de treinamento lê as linhas pretendidas e reutilize a transformação apropriada derivada do treinamento na avaliação. Verifique separadamente os atributos de imagem, vídeo e ação relativa, que podem seguir caminhos diferentes. Um processador pré-treinado ou retomado pode ter suas próprias estatísticas salvas, portanto analise o checkpoint real e as substituições de configuração em vez de presumir o comportamento deste exemplo.
Como verificamos
Lemos o código-fonte fixado sem importar nem executar o LeRobot. Nosso script de análise verifica os hashes do código-fonte, baixa temporariamente a pequena tabela de metadados e calcula a divisão hipotética e as comparações de mín/máx com o DuckDB 1.4.4. Ele remove a tabela temporária após uma execução normal. Os resultados agregados não retêm rótulos de tarefas, IDs de episódios individuais nem estatísticas por episódio. O pacote do verificador de código-fonte contém um script que verifica estruturas selecionadas do código-fonte fixado sem executar o código original, junto com a licença e a atribuição do projeto original. O gerador de figuras reproduz os dois diagramas a partir dos dados agregados. Não foram usados gravações, quadros brutos, modelo nem tarefas de treinamento ou benchmark.
Para reproduzir no macOS ou Linux com Python 3.11 e DuckDB 1.4.4:
python3.11 -m venv .lerobot-stats-venv
.lerobot-stats-venv/bin/python -m pip install duckdb==1.4.4
.lerobot-stats-venv/bin/python analyze.py > observations-reproduced.json
unzip source-check.zip -d lerobot-source-check
.lerobot-stats-venv/bin/python lerobot-source-check/source-check.py
O cartão fixado do conjunto de dados o identifica como Apache-2.0; essa indicação não determina os direitos de todos os recursos subjacentes. O verificador de código-fonte faz referência a pequenas expressões do LeRobot; a licença da versão fixada e a atribuição de direitos autorais estão incluídas no pacote do verificador. A sapien1 oferece suas contribuições originais ao script para download e execução local; nenhuma licença adicional para modificar ou redistribuir essas contribuições é informada. Os termos do conjunto de dados de origem e do código original são distintos.