Pesquisa
A configuração de recursos de 66 tarefas do Terminal-Bench
Idioma: Português (Brasil)
O Terminal-Bench v4.1.0 declara configurações de recursos diferentes para suas 66 tarefas. No levantamento dos arquivos de configuração, 31 tarefas especificam mais de 4.096 MB de memória e 22 especificam mais de duas CPUs. Montamos uma configuração de comparação com os valores explícitos mais frequentes para CPU, memória, armazenamento e GPU. Ela fica abaixo de pelo menos um valor declarado em 38 tarefas. Essas diferenças ajudam a identificar quais configurações a equipe deve preservar ou documentar ao preparar ambientes isolados de avaliação. Elas não permitem prever o consumo de recursos nem falhas de execução.
Ao executar o mesmo benchmark em um novo ambiente, quais condições continuam valendo? A resposta depende das versões da tarefa e do executor, das opções que substituem valores e das regras do backend.
A versão reúne tarefas com diferentes requisitos declarados
Examinamos todas as tarefas do manifesto oficial do Terminal-Bench v4.1.0, lançado em 3 de novembro de 2026. O levantamento abrange as 66 tarefas da versão, cada uma com um arquivo task.toml em uma revisão fixa do código-fonte. O repositório também contém tarefas antigas e arquivos auxiliares de teste que ficam fora do levantamento. Versão e manifesto oficiais
Os valores declarados para o ambiente principal vão de 2 a 16 CPUs e de 4.096 a 32.768 MB de memória. O valor mais frequente é de duas CPUs, presente em 44 tarefas. Para memória, o valor mais frequente é de 4.096 MB, presente em 35. As demais tarefas se distribuem entre valores maiores.
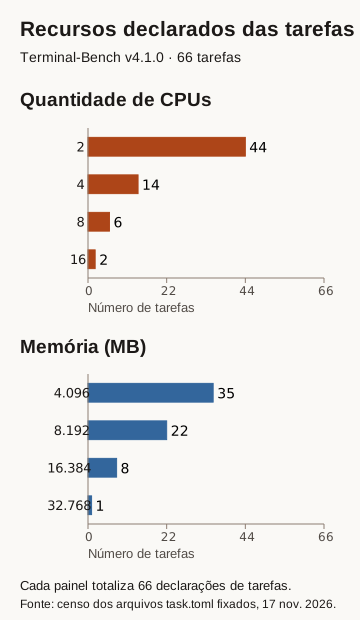
Cada painel cobre os mesmos 66 ambientes de tarefa. Os valores vêm dos arquivos de configuração da versão. Os dados completos do levantamento incluem uma URL fixa e o hash do arquivo de origem de cada tarefa.
Isso importa quando a equipe padroniza sua infraestrutura. Um ambiente uniforme pode simplificar o agendamento, mas altera algumas condições declaradas se o executor não aplicar os valores específicos de cada tarefa. Ter mais hardware disponível também não garante a preservação de um limite declarado mais baixo. A comparação depende do que o executor e o backend realmente aplicam.
Combinar valores frequentes altera muitas configurações declaradas
Montamos a configuração de comparação com o valor explícito mais frequente de cada um dos quatro campos.
| Campo | Valor na configuração de comparação |
|---|---|
| CPUs | 2 |
| Memória | 4.096 MB |
| Armazenamento | 10.240 MB |
| GPUs | 0 |
Criamos essa configuração para a análise. Ela não representa o padrão do Harbor, uma recomendação de fornecedor ou uma implantação observada. Os valores são frequentes individualmente. A combinação completa pode ter outra frequência.
Em cada tarefa, verificamos se algum valor declarado explicitamente excedia o valor de comparação do mesmo campo. Isso ocorreu em 38 das 66 tarefas. Por campo, foram 22 tarefas para CPU, 31 para memória, 17 para armazenamento e três para quantidade de GPUs. Os grupos se sobrepõem, então somá-los contaria algumas tarefas mais de uma vez. Os resultados da comparação incluem a lista exata de tarefas na união e em cada campo.
Nas outras 28 tarefas, nenhum valor registrado supera as quatro referências. Isso não confirma a compatibilidade com a configuração de comparação. Oito tarefas omitem a quantidade de GPUs, e o levantamento mantém essa ausência em vez de registrá-la como zero. Arquivos, contêineres auxiliares, imagens e serviços também podem exigir recursos que esses campos não descrevem.
Para executar tarefas sem GPU, os responsáveis disponibilizam um conjunto separado de 63 tarefas apenas para CPU no Terminal-Bench 4.1.0. Execute-o com harbor run -d terminal-bench/terminal-bench-cpu-only@4.1.0 e identifique seus resultados separadamente das pontuações da versão completa de 66 tarefas. A inclusão nesse conjunto não indica se a tarefa cabe em um limite específico de CPU, memória ou armazenamento.
Use a lista de exceções para verificar quais configurações seriam alteradas por um ambiente padronizado antes de executar as tarefas.
A declaração passa pelo executor e pelo backend
O arquivo da tarefa descreve parte da configuração da avaliação. Para entender como o executor usa essas declarações, analisamos uma revisão fixa do Harbor cujos metadados do pacote identificam a versão 0.26.0.
No código analisado, opções de uma tentativa podem substituir os valores de recursos da tarefa. As políticas de CPU e memória também podem determinar se os valores são aplicados ou ignorados. O analisador mantém sem valor os campos de CPU, memória e armazenamento que foram omitidos. O ambiente base interpreta uma quantidade de GPUs omitida como zero efetivo. O levantamento preserva a omissão para que seja possível distinguir a configuração escrita na tarefa da interpretação do executor. Lógica de ambientes do Harbor na revisão analisada
O backend também interfere. O adaptador do Docker analisado converte suas políticas automáticas de CPU e memória em limites. Ele ignora explicitamente a seleção do tipo de GPU, e o código que grava os recursos do Compose não define um teto de armazenamento. Três tarefas da versão declaram uma H100, mas isso não garante que o Docker atribua uma. Da mesma forma, o valor storage_mb, por si só, não estabelece um limite de disco no Docker. A configuração do Compose pode acrescentar restrições e outros backends podem aplicar regras diferentes. Adaptador do Docker · Gravação dos recursos do Compose
Para reproduzir a avaliação, preserve a declaração e registre como o backend escolhido a aplicou. A configuração solicitada e os recursos efetivamente alocados respondem a perguntas diferentes.
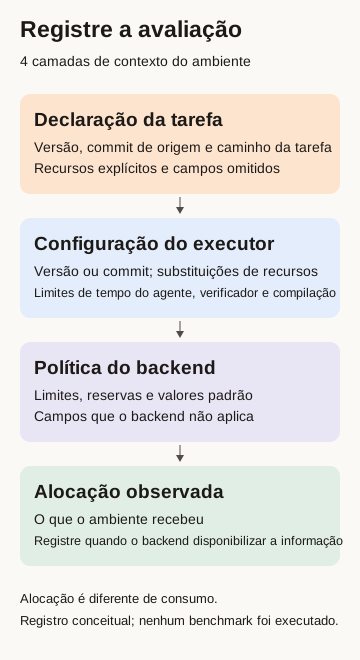
Mantenha as configurações solicitadas e as alocações observadas em campos separados.
Registre separadamente os prazos do agente e as configurações do verificador
Os 66 arquivos de tarefa definem explicitamente um prazo de 28.800 segundos para o agente, ou oito horas. Esse valor é o máximo configurado. Os prazos declarados para verificação variam de 60 a 18.000 segundos, e os da etapa de build do ambiente, de 300 a 18.000 segundos. Considere as fases separadamente ao estimar a duração de uma tarefa.
O executor analisado pode substituir prazos, aplicar valores máximos e usar multiplicadores. Na função examinada, o máximo é aplicado antes do multiplicador. A análise não soma os tetos das fases para prever o tempo total transcorrido. Resolução de prazos na revisão fixa · Cálculo do tempo por fase
Com as regras da versão do Harbor que analisamos, calculamos os prazos de verificação para todas as 66 tarefas do Terminal-Bench v4.1.0. Testamos separadamente um máximo de 600 segundos e a substituição do prazo por 600 segundos. Usamos um multiplicador de 1 nos dois casos. O maior prazo calculado foi de 600 segundos com ambas as configurações. O máximo preservou os 28 prazos mais curtos. A substituição elevou todos esses 28 prazos para 600 segundos. Para preservar os prazos mais curtos nessa configuração, use o máximo e registre a opção usada. Como o Harbor escolhe o prazo inicial · Como o Harbor aplica o máximo e o multiplicador
O limite de tempo do job que executa o agente pode interromper um agente em execução local antes que o prazo do próprio agente termine. Por exemplo, se o agente tem oito horas para uma tarefa, ele não pode usar todo esse tempo em um job hospedado pelo GitHub com limite de seis horas. A preparação feita dentro desse mesmo job também consome parte do tempo disponível. Registre separadamente o limite de tempo do job e o prazo do agente.
Todas as tarefas selecionam explicitamente a verificação separada. Seis fornecem um bloco de configuração para o ambiente do verificador. Na revisão analisada, o Harbor seleciona o bloco explícito inteiro sem combinar seus campos com o ambiente da tarefa. Sem esse bloco, copia o ambiente da tarefa. As opções de cada tentativa ainda podem alterar a configuração efetiva do verificador. Resolução da configuração do verificador
Registre as configurações do agente e do verificador separadamente, mesmo quando coincidirem. A escolha de verificação separada, por si só, não informa quais recursos foram alocados ou se os dois ambientes consomem recursos ao mesmo tempo.
Comparamos declarações de CPU, memória, armazenamento, GPU, prazos e modo de verificação no Terminal-Bench 4.0 e 4.1 para as 66 tarefas com os mesmos nomes e caminhos. A comparação encontrou mudanças nesses campos em duas tarefas. Em distributed-dedup, o prazo do verificador subiu de 1.800 para 3.900 segundos. Em payments-pipeline-fix, os valores explícitos do verificador passaram de 6 CPUs e 12.288 MB para 8 CPUs e 16.384 MB. São valores declarados, não medições da alocação. As notas da versão 4.1 informam que as 66 tarefas foram modificadas. Essa comparação de configuração deixa em aberto se as instruções, imagens e os verificadores são equivalentes.
Baixe compare-versions.py e census.json na mesma pasta. Com Python 3.11 ou posterior e acesso à internet, execute python3 compare-versions.py > comparison.json nessa pasta. O script consulta a revisão fixa do registro da versão 4.0 e os metadados das tarefas sem executá-las. O relatório local mantém a atribuição e o pedido do projeto para excluir esses dados dos conjuntos de treinamento.
O que preservar ao mudar a configuração da avaliação
O levantamento ajuda a montar um registro breve das configurações.
- Fixe o conjunto de tarefas. Guarde juntos o manifesto da versão, a revisão do código-fonte e os caminhos das tarefas. A contagem de arquivos de todo o repositório pode incluir conteúdo fora da versão do benchmark.
- Preserve as declarações originais. Registre valores explícitos e omissões, incluindo configurações separadas do verificador e prazos de cada fase.
- Documente o executor e as opções. Guarde a versão ou revisão exata e as opções que substituem ou multiplicam valores das tarefas.
- Verifique as regras do backend. Identifique quais campos viram limites, reservas, valores padrão ou solicitações que o backend não aceita.
- Registre os recursos alocados quando for possível observá-los. Guarde esse registro separadamente da configuração solicitada e do consumo medido durante a execução.
Se você mudar intencionalmente um limite ou uma alocação, registre a alteração junto ao resultado. Assim, quem consultar a avaliação poderá entender suas condições e considerar as diferenças entre ambientes.
A comparação das configurações e o código da análise permitem conferir as exceções. A sapien1 faz esse tipo de análise de tarefas e ambientes ao definir o escopo de um projeto de avaliação de agentes.
Para comparar outros limites, baixe o filtro de recursos e os dados do levantamento na mesma pasta. Por exemplo, python3 filter-census.py --cpus 4 --memory-mb 8192 --status within lista as declarações que respeitam esses valores tanto no ambiente da tarefa quanto no do verificador. A saída mantém as omissões e não informa, por si só, se a tarefa poderá ser executada. O Terminal-Bench pede que os dados do benchmark fiquem fora dos conjuntos de treinamento.
Compare as tarefas selecionadas por cada limite
Cada um dos dois exemplos de limites de recursos seleciona 44 das 66 tarefas do Terminal-Bench v4.1.0. As listas têm 36 tarefas em comum e 8 exclusivas cada. Para cada limite, o filtro compara os valores declarados de CPU, memória e armazenamento separadamente no ambiente da tarefa e no do verificador.
| CPUs | Memória (MB) | Armazenamento (MB) | Tarefas que atendem aos três limites |
|---|---|---|---|
| 4 | 8.192 | 10.240 | 44 |
| 2 | 16.384 | 20.480 | 44 |
Execute os dois comandos na pasta que contém o filtro e o arquivo do levantamento. Em cada relatório, os campos task em records indicam os IDs das tarefas selecionadas.
python3 filter-census.py --cpus 4 --memory-mb 8192 \
  --storage-mb 10240 --phases both --status within > ceiling-4cpu.json

python3 filter-census.py --cpus 2 --memory-mb 16384 \
  --storage-mb 20480 --phases both --status within > ceiling-2cpu.json
Ao informar uma pontuação, salve os IDs exatos das tarefas com a versão do benchmark e as configurações de recursos. Se comparar duas execuções usando as tarefas em comum, calcule as duas pontuações com a mesma lista.
Método e escopo
Concluímos em 17 de novembro de 2026 um levantamento completo das declarações de configuração de uma versão. O estudo se limita a essas declarações e não mede desempenho. A revisão de origem do conjunto Terminal-Bench é 4070d6c. A revisão do Harbor analisada é ec6aeab, identificada como 0.26.0 nos metadados do projeto. A metodologia inclui hashes completos, fontes, regras de extração e comandos para reproduzir o levantamento.
O coletor lê o manifesto oficial e 66 arquivos TOML, que somam 85.966 bytes na origem. Ele preserva os campos de versão separadamente e procura aliases antigos de recursos, etapas e blocos de ambiente adicionais. Não encontrou etapas nem aliases antigos nessa versão. Os downloads públicos contêm apenas fatos selecionados de configuração e hashes de origem. As instruções das tarefas, as soluções e os ambientes completos ficam de fora.
Verificamos de forma independente as tarefas do manifesto, os cálculos e amostras das fontes que cobrem um caso extremo, um campo de GPU omitido e um bloco explícito de verificação. Nenhum modelo, contêiner ou tarefa do benchmark foi executado.