Onderzoek
De resource-instellingen van 66 Terminal-Bench-taken
Taal: Nederlands
Terminal-Bench v4.1.0 geeft verschillende resource-instellingen op voor zijn 66 taken. Uit een inventarisatie van de configuratiebestanden blijkt dat 31 taken meer dan 4.096 MB geheugen opgeven en 22 meer dan twee CPU's. We hebben de meest voorkomende expliciete waarden voor CPU's, geheugen, opslag en GPU's samengevoegd tot een vergelijkingsconfiguratie. Die ligt bij 38 taken onder ten minste één opgegeven waarde. De verschillen laten zien welke instellingen het evaluatieteam moet behouden of documenteren bij het opzetten van geïsoleerde omgevingen. Ze voorspellen het verbruik of het mislukken van taken niet.
Welke voorwaarden gelden nog als je dezelfde benchmark in een nieuwe omgeving uitvoert? Dat hangt af van de versies van de taak en de runner, de opties die waarden vervangen en de regels van de backend.
De uitgave omvat taken met uiteenlopende waarden
We hebben alle taken in het officiële manifest van Terminal-Bench v4.1.0 bekeken. De versie verscheen op 3 november 2026. De inventarisatie omvat alle 66 taken, elk met een bestand task.toml op een vaste bronrevisie. De repository bevat ook oudere taken en ondersteunende testbestanden die buiten de inventarisatie vallen. Officiële versie en manifest
De opgegeven waarden in de hoofdomgeving lopen van 2 tot 16 CPU's en van 4.096 tot 32.768 MB geheugen. Twee CPU's komt het vaakst voor, bij 44 taken. De meest voorkomende geheugenwaarde is 4.096 MB, bij 35 taken. Voor de overige taken zijn hogere waarden opgegeven.
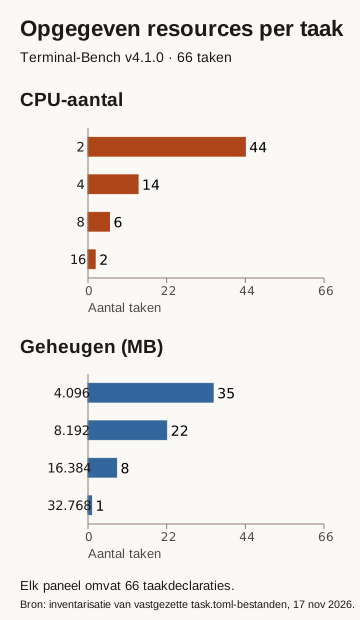
Beide delen van de afbeelding tonen dezelfde 66 taakomgevingen. De waarden komen uit de configuratiebestanden van deze versie. De volledige inventarisatie bevat per taak een URL naar de vaste revisie en de hash van het bronbestand.
Dat is van belang als een team zijn infrastructuur standaardiseert. Een uniforme omgeving kan de planning vereenvoudigen, maar verandert sommige opgegeven voorwaarden als de runner de instellingen per taak niet toepast. Meer beschikbare hardware behoudt een lagere opgegeven grens ook niet automatisch. Voor de vergelijking telt welke grenzen de runner en de backend daadwerkelijk toepassen.
Een configuratie met veelvoorkomende waarden verandert veel instellingen
Voor de vergelijkingsconfiguratie hebben we uit elk van de vier velden de meest voorkomende expliciete waarde genomen.
| Veld | Waarde in de vergelijkingsconfiguratie |
|---|---|
| CPU's | 2 |
| Geheugen | 4.096 MB |
| Opslag | 10.240 MB |
| GPU's | 0 |
Deze configuratie is voor de analyse samengesteld. Ze komt niet overeen met een standaardinstelling van Harbor, een aanbeveling van een leverancier of een waargenomen implementatie. De afzonderlijke waarden zijn gangbaar. De volledige combinatie kan minder vaak voorkomen.
Per taak controleerden we of een expliciet opgegeven waarde boven de overeenkomstige vergelijkingswaarde uitkwam. Dat gold voor 38 van de 66 taken. Per veld waren het 22 taken voor CPU, 31 voor geheugen, 17 voor opslag en drie voor het aantal GPU's. De groepen overlappen, dus optellen zou sommige taken dubbel tellen. De vergelijkingsresultaten bevatten de exacte taak-ID's voor alle betrokken taken en voor elk veld apart.
Bij de overige 28 taken komen de vastgelegde waarden niet boven deze vier grenzen uit. Dat toont niet aan dat de vergelijkingsconfiguratie geschikt is voor die taken. Acht taken laten het aantal GPU's weg. De inventarisatie houdt dat veld leeg. Bestanden, ondersteunende containers, images en diensten kunnen bovendien eisen stellen buiten deze vier velden.
Voor uitvoeringen zonder GPU bieden de beheerders in Terminal-Bench 4.1.0 een aparte dataset met 63 taken voor alleen CPU. Voer die uit met harbor run -d terminal-bench/terminal-bench-cpu-only@4.1.0 en rapporteer die uitkomsten apart van de scores voor de volledige versie met 66 taken. Opname in de CPU-dataset toont niet aan dat een taak binnen een specifieke grens voor CPU's, geheugen of opslag past.
Gebruik de lijst met uitzonderingen om vóór een uitvoering na te gaan welke instellingen een gestandaardiseerde omgeving zou veranderen.
De runner en de backend interpreteren de opgegeven waarden
Het taakbestand vormt een onderdeel van de evaluatieconfiguratie. Om na te gaan hoe de waarden worden verwerkt, hebben we Harbor op een vaste commit onderzocht. De pakketmetadata op die commit vermeldt versie 0.26.0.
In de onderzochte code kunnen opties per poging de resourcewaarden van de taak vervangen. Beleid voor CPU en geheugen kan ook bepalen of waarden worden toegepast of genegeerd. De parser laat niet-opgegeven waarden voor CPU, geheugen en opslag leeg. De basisomgeving behandelt een ontbrekend aantal GPU's als effectief nul. De inventarisatie houdt de oorspronkelijke weglating zichtbaar, zodat je de opgave in de taak kunt onderscheiden van de interpretatie door de runner. Omgevingslogica van Harbor op de onderzochte commit
Ook de backend telt mee. De onderzochte Docker-adapter zet zijn automatische CPU- en geheugenbeleid om in limieten. Hij negeert de keuze van het GPU-type uitdrukkelijk, en de functie die de Compose-resources schrijft legt geen opslaglimiet vast. Drie taken vermelden uitdrukkelijk een H100. Dat ene veld bewijst niet dat Docker er een toewijst. Ook uit storage_mb alleen volgt geen schijflimiet in Docker. Een bestaande Compose-configuratie kan extra beperkingen opleggen. Andere backends kunnen de waarden anders behandelen. Docker-adapter · Code voor Compose-resources
Bewaar voor een reproduceerbare evaluatie de declaratie en leg vast hoe de gekozen backend die heeft toegepast. De aangevraagde instelling en de werkelijke toewijzing beantwoorden verschillende vragen.
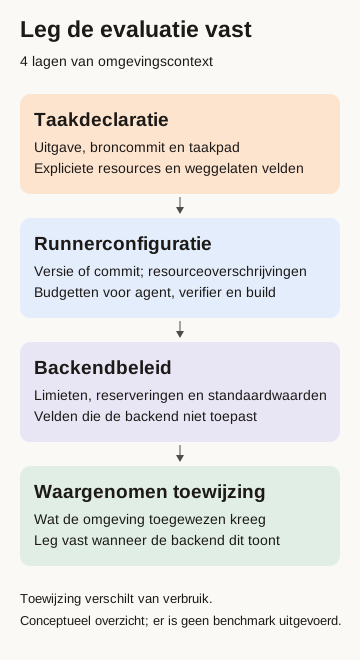
Houd aangevraagde instellingen en waargenomen toewijzingen in afzonderlijke velden bij.
Leg time-outs van de agent en instellingen van de verifier apart vast
Alle 66 taakbestanden geven de agent uitdrukkelijk een time-out van 28.800 seconden, oftewel acht uur. Dat is een ingestelde bovengrens. De opgegeven time-outs voor verificatie lopen van 60 tot 18.000 seconden. Voor de build lopen ze van 300 tot 18.000 seconden. Houd de fasen apart als je de duur van een taak schat.
De onderzochte runner kan time-outs vervangen en maxima en vermenigvuldigingsfactoren toepassen. De functie past eerst het maximum en dan de factor toe. De analyse telt de fasegrenzen niet op om de verstreken tijd te voorspellen. Bepaling van time-outs op de onderzochte revisie · Berekening van het tijdsbudget per fase
Met de regels uit de onderzochte Harbor-versie berekenden we de time-outs voor verificatie voor alle 66 taken in Terminal-Bench v4.1.0. We probeerden een maximum van 600 seconden en een vervangende time-out van 600 seconden afzonderlijk, beide met een factor van 1. De hoogste berekende time-out was bij beide instellingen 600 seconden. Het maximum behield de 28 kortere time-outs. De vervangende waarde verhoogde alle 28 tot 600 seconden. Wil je in deze opzet de kortere time-outs behouden, gebruik dan het maximum en leg vast welke instelling je hebt gebruikt. Hoe Harbor de aanvankelijke time-out kiest · Hoe Harbor het maximum en de factor toepast
De tijdslimiet van de bovenliggende job kan een lokaal draaiende agent stoppen voordat zijn eigen time-out is bereikt. Krijgt de agent bijvoorbeeld acht uur voor een taak, dan kan hij die tijd niet volledig benutten in een door GitHub gehoste job met een limiet van zes uur. Voorbereiding binnen diezelfde job gaat ook van de beschikbare tijd af. Leg de tijdslimiet van de job en de time-out van de agent apart vast.
Alle taken kiezen expliciet voor afzonderlijke verificatie. Zes geven een omgevingsblok voor de verifier op. De onderzochte Harbor-functie neemt zo'n expliciet blok in zijn geheel over. Ze voegt de velden niet afzonderlijk samen met de taakomgeving. Zonder apart blok wordt de taakomgeving gekopieerd. Opties per poging kunnen de effectieve configuratie van de verifier nog wijzigen. Bepaling van de verifier-configuratie
Leg de instellingen van de agent en de verifier afzonderlijk vast, ook als ze overeenkomen. De keuze voor afzonderlijke verificatie zegt op zichzelf niets over de werkelijke toewijzing of het gelijktijdig gebruik van resources door beide omgevingen.
We hebben de opgegeven waarden voor CPU's, geheugen, opslag, GPU's, time-outs en verificatiemodus in Terminal-Bench 4.0 en 4.1 vergeleken voor de 66 taken met dezelfde namen en paden. Uit de vergelijking blijkt dat in twee taken deze velden zijn veranderd. Voor distributed-dedup ging de time-out van de verifier van 1.800 naar 3.900 seconden. Voor payments-pipeline-fix gingen de expliciete verifier-waarden van 6 CPU's en 12.288 MB naar 8 CPU's en 16.384 MB. Dit zijn opgegeven waarden. Volgens de releaseopmerkingen van 4.1 zijn alle 66 taken aangepast. Deze beperkte vergelijking laat open of instructies, images en verifiers gelijkwaardig zijn.
Download compare-versions.py en census.json naar dezelfde map. Voer met Python 3.11 of nieuwer en een internetverbinding de opdracht python3 compare-versions.py > comparison.json uit die map uit. Het script haalt de vastgelegde registry van versie 4.0 en de taakmetadata op zonder taken uit te voeren. Het lokale rapport bewaart de bronvermelding en het verzoek van het project om de benchmarkgegevens buiten trainingscorpora te houden.
Wat je bewaart als de evaluatieconfiguratie verandert
Uit de inventarisatie kun je een kort configuratieverslag samenstellen.
- Leg de taakset vast. Bewaar het releasemanifest, de broncommit en de taakpaden bij elkaar. Het totale aantal bestanden in de repository kan materiaal van buiten de benchmarkversie omvatten.
- Bewaar de oorspronkelijke declaraties. Noteer expliciete waarden en weglatingen, inclusief aparte verifier-instellingen en tijdslimieten per fase.
- Documenteer de runner en zijn opties. Bewaar de versie of commit en de opties die taakwaarden vervangen of schalen.
- Controleer het backendbeleid. Ga na welke velden worden opgevat als limieten, reserveringen, standaardwaarden of niet-ondersteunde verzoeken.
- Leg de werkelijke toewijzing vast als die waarneembaar is. Houd die gescheiden van de aangevraagde configuratie en het gemeten verbruik tijdens de uitvoering.
Documenteer een bewust gewijzigd limiet of een andere toewijzing bij het resultaat. Een lezer kan dan de evaluatievoorwaarden begrijpen en rekening houden met verschillen tussen omgevingen.
Met de configuratievergelijking en de analysecode kun je de uitzonderingen onderzoeken. sapien1 gebruikt dit soort taak- en omgevingsonderzoek bij het afbakenen van een project voor agentevaluatie.
Download voor andere grenzen het resourcefilter en de inventarisatie naar dezelfde map. De opdracht python3 filter-census.py --cpus 4 --memory-mb 8192 --status within toont bijvoorbeeld taken waarvan de opgegeven waarden binnen die grenzen vallen voor de taak en de verifier. De uitvoer houdt ontbrekende velden zichtbaar en toont op zichzelf niet aan dat een taak kan draaien. Terminal-Bench vraagt om de benchmarkgegevens buiten trainingscorpora te houden.
Vergelijk de taken die bij elke bovengrens worden geselecteerd
De twee voorbeeldinstellingen selecteren elk 44 van de 66 taken in Terminal-Bench v4.1.0. De lijsten hebben 36 taken gemeen en bevatten elk 8 taken die alleen in die lijst staan. Bij elke bovengrens toetst het filter de opgegeven waarden voor CPU's, geheugen en opslag afzonderlijk voor de taakomgeving en de verificatieomgeving.
| CPU's | Geheugen (MB) | Opslag (MB) | Taken binnen alle drie de bovengrenzen |
|---|---|---|---|
| 4 | 8.192 | 10.240 | 44 |
| 2 | 16.384 | 20.480 | 44 |
Voer beide opdrachten uit in de map met het filter en de inventaris. In elk rapport staan de geselecteerde taak-ID's in de velden task binnen records.
python3 filter-census.py --cpus 4 --memory-mb 8192 \
  --storage-mb 10240 --phases both --status within > ceiling-4cpu.json

python3 filter-census.py --cpus 2 --memory-mb 16384 \
  --storage-mb 20480 --phases both --status within > ceiling-2cpu.json
Bewaar bij een gerapporteerde score de exacte taak-ID's, de benchmarkversie en de resource-instellingen. Vergelijk je twee uitvoeringen op hun gemeenschappelijke taken, bereken dan beide scores over dezelfde lijst.
Methode en bereik
We hebben op 17 november 2026 alle configuratiedeclaraties van één versie geïnventariseerd. Het onderzoek gaat over die declaraties en meet geen prestaties. De broncommit van de Terminal-Bench-dataset is 4070d6c. De onderzochte Harbor-commit is ec6aeab, volgens de projectmetadata versie 0.26.0. De methode bevat de volledige hashes, bronlinks, extractieregels en opdrachten om de inventarisatie te herhalen.
Het verzamelscript leest het officiële manifest en 66 TOML-bestanden met samen 85.966 bronbytes. Het bewaart versievelden apart en zoekt naar oude resource-aliassen, stappen en extra omgevingsblokken. Deze versie leverde geen stappen of oude aliassen op. De openbare downloads bevatten geselecteerde configuratiefeiten en bronhashes. Taakinstructies, oplossingen en volledige omgevingen zijn niet opgenomen.
We hebben de samenstelling van het manifest, de berekeningen en bronvoorbeelden onafhankelijk gecontroleerd. Daaronder waren een uitschieter, een weggelaten GPU-veld en een expliciet verificatieblok. We hebben geen model, container of benchmarktaak uitgevoerd.