Pananaliksik
Mga setting ng resource ng 66 na gawain sa Terminal-Bench
Wika ng artikulo: Tagalog
Iba-iba ang nakasaad na setting ng resource sa 66 na gawain ng Terminal-Bench v4.1.0. Sa pagsusuri ng mga configuration file, 31 gawain ang humihiling ng higit sa 4,096 MB na memory at 22 ang humihiling ng higit sa dalawang CPU. Bumuo kami ng preset mula sa pinakakaraniwang tahasang halaga ng CPU, memory, storage at GPU. Mas mababa ang preset sa kahit isang nakasaad na halaga sa 38 gawain. Ipinapakita ng mga pagkakaibang ito kung aling setting ang dapat panatilihin o itala ng team kapag nagse-set up ng mga sandbox para sa evaluation. Mula rito ay walang mahuhulaan na aktuwal na paggamit ng resource o pagkabigo ng gawain.
Kapag pinatakbo mo ang parehong benchmark sa ibang environment, aling mga kundisyon ang madadala mo? Nakasalalay ito sa bersyon ng gawain, bersyon ng runner, mga override at patakaran ng backend.
Iba-iba ang laki ng hinihinging resource sa release
Sinuri namin ang bawat gawain sa opisyal na manifest ng Terminal-Bench v4.1.0, na inilabas noong Nobyembre 3, 2026. Saklaw nito ang 66 na kasapi ng release. Bawat isa ay may task.toml sa isang nakapirming source commit. Mayroon ding mga lumang gawain at test fixture sa repository. Hiwalay ang mga iyon sa census na ito. Opisyal na release at manifest
Mula 2 hanggang 16 na CPU at 4,096 hanggang 32,768 MB na memory ang nakasaad sa pangunahing environment ng mga gawain. Dalawang CPU ang pinakakaraniwang halaga, na makikita sa 44 na gawain. Para sa memory, 4,096 MB ang pinakakaraniwan, sa 35 gawain. Mas malalaki ang nakasaad na halaga sa mga natitirang gawain.
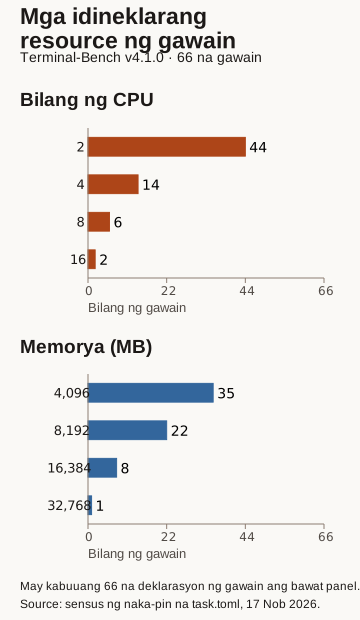
Parehong 66 na environment ng gawain ang saklaw ng bawat panel. Galing ang mga halaga sa mga configuration file ng release. Kasama sa kumpletong tala ang nakapirming URL at source hash ng bawat gawain.
Maaaring mapadali ng iisang setup ang scheduling ng team. Magbabago naman ang ilang nakasaad na kundisyon kung walang inilalapat na natatanging setting ang runner para sa bawat gawain. Kapag dinagdagan ang available na hardware, kailangan pa ring ipatupad ang mas maliit na nakasaad na limitasyon kung iyon ang nais panatilihin. Nakasalalay ang paghahambing sa aktuwal na ipinapatupad ng runner at backend.
Maraming deklarasyon ang nagbabago kapag ginamit ang mga karaniwang halaga bilang preset
Bilang paghahambing, bumuo kami ng preset gamit ang pinakakaraniwang tahasang halaga sa apat na field.
| Pagtatakda | Halaga sa preset na paghahambingan |
|---|---|
| Mga CPU | 2 |
| Memorya | 4,096 MB |
| Espasyo sa imbakan | 10,240 MB |
| Mga GPU | 0 |
Binuo ang preset para sa pagsusuring ito. May sariling default ang Harbor, at hiwalay din ang mga rekomendasyon ng vendor at mga aktuwal na deployment. Karaniwan ang bawat halaga kung titingnan nang hiwalay. Kailangang sukatin nang hiwalay kung alin ang pinakakaraniwang buong configuration.
Sa bawat gawain, tiningnan namin kung may tahasang halagang lumalampas sa katumbas na halaga sa preset. Lumampas ang 38 sa 66 na gawain. Bawat field ay may sariling bilang. Lumampas ang 22 para sa CPU, 31 para sa memory, 17 para sa storage at tatlo para sa bilang ng GPU. Nag-o-overlap ang mga pangkat kaya madodoble ang bilang ng ilang gawain kung pag-aadisyunin ang mga ito. Nasa mga resulta ng paghahambing ang mga eksaktong listahan para sa pinagsamang pangkat at sa bawat field.
Sa natitirang 28 gawain, walang nakatalang tahasang halaga na lumalampas sa apat na halaga ng preset. Kailangan pa ring suriin ang compatibility ng mga gawaing iyon. Walang isinasaad na bilang ng GPU sa walong gawain at pinanatili namin ang pagkakaibang iyon sa tahasang zero. Posible ring may ibang requirement mula sa mga file, sidecar, image o serbisyo.
Para sa pagpapatakbo na walang GPU, may hiwalay na CPU-only dataset na may 63 gawain ang mga maintainer sa Terminal-Bench 4.1.0. Patakbuhin ito gamit ang harbor run -d terminal-bench/terminal-bench-cpu-only@4.1.0. Lagyan ng sariling label ang mga resulta nito upang maihiwalay sa mga score ng buong release na may 66 na gawain. Kailangan pa ring suriin kung pasok ang bawat CPU-only na gawain sa partikular na limitasyon ng CPU, memory o storage.
Gamitin ang listahan ng mga gawaing lumampas upang makita kung aling setting ang mababago ng iisang setup. Makakatulong ito sa pag-review ng configuration bago patakbuhin ang benchmark.
Dumaraan sa runner at backend ang mga nakasaad na setting
Bahagi ng setup ng evaluation ang task file. Upang malaman kung paano pinoproseso ang mga setting, sinuri namin ang source ng Harbor sa isang nakapirming commit. Nakasaad sa package metadata na bersyon 0.26.0 ito.
Sa source na iyon, maaaring palitan ng mga override sa antas ng trial ang mga halaga sa gawain. Maaari ding magtakda ang mga patakaran ng CPU at memory kung ilalapat o lalaktawan ang mga halaga. Iniiwang nullable ng parser ang CPU, memory at storage kung walang nakasaad. Itinuturing ng base environment na zero ang epektibong bilang ng GPU kapag walang nakasaad na bilang. Tinatala ng census kung aling halaga ang wala sa pinagmulan para makita ang pagkakaiba ng isinulat na setting at ng interpretasyon ng runner. Logic ng environment sa nakapirming Harbor source
May sarili ring paraan ng pagpapatupad ang backend. Sa Docker adapter na sinuri, nagiging mga limitasyon ang awtomatikong patakaran ng CPU at memory. Hayagang binabalewala nito ang pagpili ng uri ng GPU, at walang inilalagay na limitasyon sa storage ang bahaging nagsusulat ng Compose resource configuration. Tatlong gawain ang tahasang tumutukoy sa H100. Kailangan ng karagdagang ebidensya upang masabing nakakuha nga nito ang Docker run. Kailangan ding i-verify ang limitasyon sa disk kahit may halagang storage_mb. Posibleng magtakda ng karagdagang limitasyon ang kasalukuyang Compose configuration. May sarili ring patakaran ang ibang backend. bahaging nag-uugnay sa Docker, bahaging nagsusulat ng Compose resource configuration
Para maulit ang evaluation, panatilihin ang orihinal na deklarasyon at itala kung paano ito aktuwal na ipinatupad ng napiling backend. Magkaibang impormasyon ang hinihiling na setting at ang halagang inilaan.
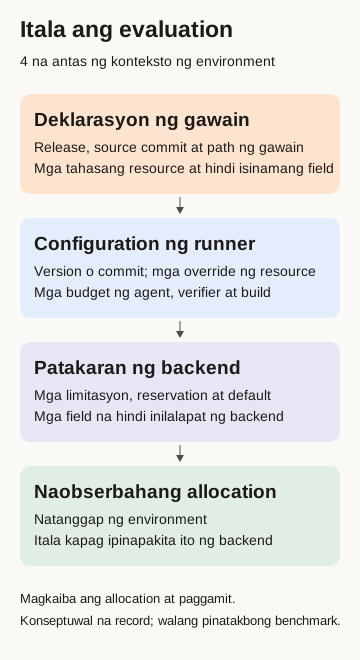
Gumamit ng magkahiwalay na field para sa mga hiniling na setting at sa mga nakitang inilaan na halaga.
Itala nang hiwalay ang mga timeout ng agent at mga setting ng verifier
Tahasang nililimitahan ng lahat ng 66 na task file ang oras ng agent sa 28,800 segundo, o walong oras. Isa itong itinakdang limitasyon. Kailangang sukatin nang hiwalay ang aktuwal na tagal. Nasa 60 hanggang 18,000 segundo ang mga timeout ng verifier, at 300 hanggang 18,000 segundo ang mga timeout ng build. May sariling oras ang bawat yugto kaya dapat magkakahiwalay ang mga limitasyon.
Maaaring maglapat ang runner na sinuri ng mga override, maximum at multiplier sa mga timeout. Mahalaga ang pagkakasunod. Sa function na sinuri, inuuna ang maximum bago ilapat ang multiplier. Walang pagtataya sa kabuuang aktuwal na tagal sa pamamagitan ng pag-aadisyon ng mga limitasyon ng bawat yugto sa pagsusuring ito. Pagkuwenta ng timeout sa nakapirming source, pagkuwenta ng oras para sa bawat yugto
Gamit ang mga tuntunin sa bersiyon ng Harbor na sinuri namin, kinalkula namin ang mga timeout ng verifier para sa lahat ng 66 na task sa Terminal-Bench v4.1.0. Hiwalay naming sinubukan ang maximum na 600 segundo at ang override na 600 segundo, na parehong may multiplier na 1. Sa parehong setting, 600 segundo ang pinakamahabang timeout na nakalkula. Pinanatili ng maximum ang 28 timeout na mas maikli na noon. Itinaas ng override ang lahat ng 28 sa 600 segundo. Para mapanatili ang mas maiikling timeout sa setup na ito, gamitin ang maximum at itala kung aling setting ang ginamit mo. Paano pinipili ng Harbor ang panimulang timeout · Paano inilalapat ng Harbor ang maximum at multiplier
Maaaring ihinto ng limitasyon sa oras ng job na nagpapatakbo sa agent ang isang agent na tumatakbo nang lokal bago maabot ang sarili nitong timeout. Halimbawa, kung may walong oras ang agent para sa isang task, hindi nito magagamit ang buong oras na iyon sa loob ng job na naka-host sa GitHub na may limitasyong anim na oras. Ang paghahanda sa loob ng parehong job ay gumagamit din ng bahagi ng oras na magagamit. Itala nang hiwalay ang limitasyon sa oras ng job at ang timeout ng agent.
Tahasang pumipili rin ang bawat gawain ng hiwalay na verification. Anim ang nagbibigay ng block para sa environment ng verifier. Buong block ang pinipili ng Harbor resolver na sinuri kapag tahasang tinukoy ang verifier environment. Kapag walang hiwalay na block, kinokopya ng resolver ang environment ng gawain. Maaari pa ring maapektuhan ng mga override sa trial ang kalalabasang setup ng verifier. Resolver ng configuration ng verifier
Itala nang magkahiwalay ang mga setting ng agent at verifier kahit pareho ang mga ito. Kailangan ng karagdagang impormasyon bukod sa pagpili ng hiwalay na verification upang matukoy ang aktuwal na alokasyon o kung sabay na gumagamit ng resource ang dalawang environment.
Inihambing namin ang piling mga deklarasyon ng CPU, memory, storage, GPU, timeout at verifier mode sa Terminal-Bench 4.0 at 4.1 para sa 66 na gawaing magkapareho ang pangalan at path. Sa paghahambing, dalawang gawain ang may pagbabago sa mga field na iyon. Tumaas ang timeout ng verifier para sa distributed-dedup mula 1,800 hanggang 3,900 segundo. Tumaas naman ang tahasang mga deklarasyon ng verifier para sa payments-pipeline-fix mula 6 na CPU at 12,288 MB hanggang 8 CPU at 16,384 MB. Mga deklarasyon ang mga halagang ito. Nangangailangan ng hiwalay na pagsukat ang aktuwal na alokasyon. Ayon sa release 4.1, binago ang lahat ng 66 na gawain. Kailangan ang mas malawak na pagsusuri upang malaman kung katumbas ang kanilang mga tagubilin, container image at verifier.
I-download ang compare-versions.py at census.json sa iisang folder. Gamit ang Python 3.11 o mas bago at may access sa network, patakbuhin ang python3 compare-versions.py > comparison.json mula sa folder na iyon. Kinukuha ng script ang nakapirming registry at metadata ng mga gawain sa 4.0, nang walang pinapatakbong gawain. Pinananatili ng lokal na report ang pagkilala sa upstream source at ang kahilingang huwag isama ang benchmark data sa mga corpus para sa training.
Mga dapat panatilihin kapag nagbabago ng setup ng evaluation
Sapat ang maikling talaan ng configuration para mapanatili ang mga nakitang kundisyon.
- Gumamit ng nakapirming pangkat ng mga gawain. Itago nang magkakasama ang release manifest, source commit at mga path ng gawain. Maaaring mapasama sa pagbilang ng file sa buong repository ang mga materyales na labas sa release.
- Itabi ang orihinal na mga deklarasyon. Itala kung aling mga halaga ang tahasang nakasaad o wala, kasama ang hiwalay na mga setting ng verifier at timeout ng bawat yugto.
- Itala ang runner at mga override. Itago ang eksaktong bersyon o commit at ang mga opsyong pumapalit o nagbabago sa laki ng mga setting ng gawain.
- Suriin ang patakaran ng backend. Tukuyin kung aling mga field ang ginagawang limitasyon, reservation o default, at kung aling mga kahilingan ang walang suporta.
- Itala ang alokasyon kung nasusukat ito. Ihiwalay ito sa hiniling na configuration at sa nasukat na paggamit habang tumatakbo ang benchmark.
Kapag sadyang binago ang limitasyon o alokasyon, itala ang pagbabago kasama ng resulta. Sa ganitong paraan, mauunawaan ng susunod na mambabasa kung sa anong mga kundisyon nakuha ang resulta at kung paano ito maihahambing sa ibang environment.
Maaaring makita ang mga eksepsyon sa paghahambing ng configuration at sa code ng pagsusuri. Ganito rin sinusuri ng sapien1 ang mga gawain at environment sa pagtukoy sa saklaw ng isang proyekto sa evaluation ng agent.
Para sa ibang limitasyon, i-download ang script na nagsasala batay sa limitasyon ng mga resource at ang talaan ng mga gawain sa iisang folder. Halimbawa, inililista ng python3 filter-census.py --cpus 4 --memory-mb 8192 --status within ang mga deklarasyong pasok sa mga limitasyong iyon para sa gawain at sa verifier. Makikita pa rin sa output kung aling mga halaga ang walang deklarasyon. Kailangan pa ng hiwalay na pag-verify upang malaman kung tatakbo ang gawain. Hinihiling ng Terminal-Bench na huwag isama ang benchmark data sa mga corpus para sa training.
Ihambing ang mga gawaing napipili sa bawat limitasyon ng resource
Bawat isa sa dalawang halimbawang limitasyon ng resource ay pumipili ng 44 sa 66 na gawain ng Terminal-Bench v4.1.0. May 36 na gawaing nasa parehong listahan at tig-8 na nasa isa lang sa mga ito. Sa bawat limitasyon, hiwalay na sinusuri ng filter ang nakasaad na CPU, memory at espasyo sa imbakan para sa environment ng gawain at para sa environment ng verifier.
| Mga CPU | Memorya (MB) | Espasyo sa imbakan (MB) | Mga gawaing pasok sa lahat ng tatlong limitasyon |
|---|---|---|---|
| 4 | 8,192 | 10,240 | 44 |
| 2 | 16,384 | 20,480 | 44 |
Patakbuhin ang parehong command mula sa folder na naglalaman ng filter at ng imbentaryo. Sa bawat ulat, makikita ang mga napiling ID ng gawain sa mga field na task sa loob ng records.
python3 filter-census.py --cpus 4 --memory-mb 8192 \
  --storage-mb 10240 --phases both --status within > ceiling-4cpu.json

python3 filter-census.py --cpus 2 --memory-mb 16384 \
  --storage-mb 20480 --phases both --status within > ceiling-2cpu.json
Kapag nag-uulat ng score, itabi ang eksaktong mga ID ng gawain kasama ang bersyon ng benchmark at ang mga setting ng resource. Kung paghahambingin mo ang dalawang run batay sa mga gawaing pareho nilang nasaklaw, gamitin ang iisang listahan sa pagkalkula ng dalawang score.
Paraan at saklaw
Ito ay kumpletong census ng mga deklarasyon sa configuration ng iisang release, na tinipon noong Nobyembre 17, 2026. Ang saklaw ay mga deklarasyon ng release. Ang representatibong sample ng mas malawak na hanay ng mga benchmark ng agent o pag-eeksperimento sa performance ay nangangailangan ng ibang pamamaraan. Nagmula ang dataset sa Terminal-Bench commit 4070d6c, at ang sinuring runner source ay mula sa Harbor commit ec6aeab na may bersyong 0.26.0 sa project metadata. Nakalista ang mga buong hash, link ng source, patakaran sa pagkuha ng datos at mga command para ulitin ang pagsusuri sa pamamaraan.
Binabasa ng collector ang opisyal na manifest at ang 66 na TOML file, na may kabuuang 85,966 byte sa source. Pinananatili nitong magkakahiwalay ang mga field ng bersyon at sinusuri kung may lumang alias ng resource, mga hakbang o karagdagang block ng environment. Walang natagpuang hakbang o lumang alias ng resource sa release na ito. Ang mga pampublikong download ay naglalaman ng piling impormasyon sa configuration at mga source hash. Hiwalay rito ang mga tagubilin at solusyon ng mga gawain at ang mga buong environment.
Hiwalay naming sinuri ang listahan ng mga gawaing kasama sa manifest, mga kalkulasyon at mga sample ng source para sa isang outlier, isang walang nakasaad na GPU at isang may tahasang block ng verifier. Walang model, container o gawain sa benchmark na pinatakbo.