Riset
Pengaturan sumber daya 66 tugas Terminal-Bench
Bahasa: Bahasa Indonesia
Terminal-Bench v4.1.0 mendeklarasikan pengaturan sumber daya yang berbeda untuk 66 tugasnya. Pendataan berkas konfigurasi menunjukkan bahwa 31 tugas menetapkan memori lebih dari 4.096 MB dan 22 menetapkan lebih dari dua CPU. Kami menyusun konfigurasi pembanding dari nilai CPU, memori, penyimpanan, dan GPU yang paling sering dinyatakan secara eksplisit. Konfigurasi ini berada di bawah setidaknya satu nilai yang dideklarasikan pada 38 tugas. Perbedaan ini membantu tim menentukan pengaturan yang perlu dipertahankan atau dicatat saat menyiapkan lingkungan evaluasi terisolasi. Perbedaan ini tidak memprediksi pemakaian sumber daya atau kegagalan tugas.
Saat menjalankan tolok ukur yang sama di lingkungan baru, kondisi mana yang tetap berlaku? Jawabannya bergantung pada versi tugas dan pelaksana, opsi yang mengganti nilai tugas, serta kebijakan sistem pelaksana.
Rilis ini memuat tugas dengan beragam tingkat sumber daya
Kami memeriksa semua tugas dalam manifes resmi Terminal-Bench v4.1.0 yang dirilis pada 3 November 2026. Pendataan mencakup seluruh 66 tugas, masing-masing dengan berkas task.toml pada revisi sumber yang ditetapkan. Repositori juga memuat tugas lama dan berkas pendukung pengujian yang berada di luar pendataan. Rilis dan manifes resmi
Nilai yang dideklarasikan untuk lingkungan utama berkisar dari 2 hingga 16 CPU dan dari 4.096 hingga 32.768 MB memori. Nilai CPU yang paling umum adalah dua, pada 44 tugas. Nilai memori yang paling umum adalah 4.096 MB, pada 35 tugas. Tugas lainnya menggunakan nilai yang lebih tinggi.
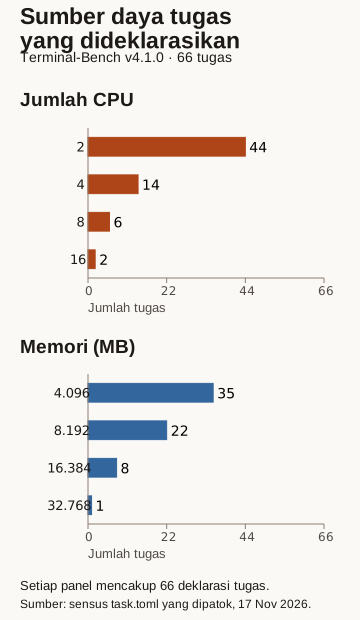
Kedua panel mencakup 66 lingkungan tugas yang sama. Nilainya diambil dari berkas konfigurasi rilis. Data pengamatan lengkap mencantumkan URL ke revisi yang ditetapkan dan hash berkas sumber untuk setiap tugas.
Perbedaan ini penting ketika tim menstandarkan infrastrukturnya. Lingkungan yang seragam dapat memudahkan penjadwalan, tetapi mengubah sebagian kondisi yang dideklarasikan jika pelaksana tidak menerapkan pengaturan khusus tiap tugas. Perangkat keras yang lebih banyak juga tidak otomatis mempertahankan batas yang lebih rendah. Hasil perbandingan bergantung pada batas yang benar-benar diterapkan oleh pelaksana dan sistem pelaksana.
Konfigurasi dari nilai yang umum mengubah banyak deklarasi
Untuk membuat pembanding, kami menggabungkan nilai eksplisit yang paling sering muncul di setiap bidang.
| Bidang | Nilai pada konfigurasi pembanding |
|---|---|
| CPU | 2 |
| Memori | 4.096 MB |
| Penyimpanan | 10.240 MB |
| GPU | 0 |
Konfigurasi ini disusun untuk analisis. Konfigurasi ini bukan pengaturan bawaan Harbor, rekomendasi penyedia, atau penerapan yang diamati. Tiap nilai umum jika dilihat sendiri. Seberapa sering kombinasi lengkapnya muncul bisa berbeda.
Untuk setiap tugas, kami memeriksa apakah ada nilai eksplisit yang melebihi nilai pembanding pada bidang yang sama. Hal ini terjadi pada 38 dari 66 tugas. Secara terpisah, 22 tugas melebihi nilai CPU, 31 nilai memori, 17 nilai penyimpanan, dan tiga jumlah GPU. Kelompok-kelompok ini tumpang tindih, sehingga menjumlahkannya akan menghitung sebagian tugas lebih dari sekali. Hasil perbandingan memuat ID yang tepat untuk semua tugas yang termasuk dan untuk setiap bidang.
Pada 28 tugas lainnya, tidak ada nilai tercatat yang melebihi keempat nilai pembanding. Hal ini belum menunjukkan bahwa konfigurasi tersebut cocok untuk tugas-tugas itu. Delapan tugas tidak mencantumkan jumlah GPU. Pendataan tetap mencatatnya sebagai nilai yang tidak disebutkan, bukan sebagai angka nol. Berkas, kontainer pendamping, citra, dan layanan juga dapat menambah persyaratan di luar keempat bidang tersebut.
Untuk menjalankan tolok ukur tanpa GPU, pengelola menyediakan set terpisah berisi 63 tugas khusus CPU pada Terminal-Bench 4.1.0. Jalankan dengan harbor run -d terminal-bench/terminal-bench-cpu-only@4.1.0 dan laporkan hasilnya secara terpisah dari skor rilis lengkap yang berisi 66 tugas. Keanggotaan di set itu tidak menunjukkan apakah sebuah tugas memenuhi batas CPU, memori, atau penyimpanan tertentu.
Sebelum menjalankan tugas, gunakan daftar pengecualian untuk memeriksa pengaturan mana yang akan diubah oleh lingkungan standar.
Deklarasi ditafsirkan oleh pelaksana dan sistem pelaksana
Berkas tugas menjelaskan sebagian konfigurasi evaluasi. Untuk memahami bagaimana deklarasi digunakan, kami meninjau revisi tetap Harbor yang metadata paketnya mencantumkan versi 0.26.0.
Pada kode yang ditinjau, opsi untuk suatu percobaan dapat mengganti nilai sumber daya tugas. Kebijakan CPU dan memori dapat menentukan apakah nilai diterapkan atau diabaikan. Pengurai membiarkan nilai CPU, memori, dan penyimpanan yang tidak disebutkan tetap kosong. Lingkungan dasar memperlakukan jumlah GPU yang tidak disebutkan sebagai nol efektif. Pendataan mempertahankan ketidaklengkapan asli agar pembaca dapat membedakan pengaturan dalam tugas dari penafsiran pelaksana. Logika lingkungan Harbor pada revisi yang ditinjau
Sistem pelaksana turut menentukan hasilnya. Adaptor Docker yang ditinjau menerjemahkan kebijakan CPU dan memori otomatis menjadi batas. Adaptor itu secara eksplisit mengabaikan pemilihan jenis GPU, dan kode penulis sumber daya Compose tidak menetapkan batas penyimpanan. Tiga tugas secara eksplisit menyebut H100. Bidang tersebut saja tidak membuktikan bahwa Docker akan mengalokasikan H100. Demikian pula, nilai storage_mb saja tidak menetapkan batas disk di Docker. Konfigurasi Compose dapat menambah pembatasan dan sistem pelaksana lain dapat menerapkan aturan berbeda. Adaptor Docker · Kode penulis sumber daya Compose
Agar evaluasi dapat diulang, simpan deklarasinya dan catat bagaimana sistem yang dipilih menerapkannya. Pengaturan yang diminta dan sumber daya yang benar-benar dialokasikan menjawab pertanyaan berbeda.
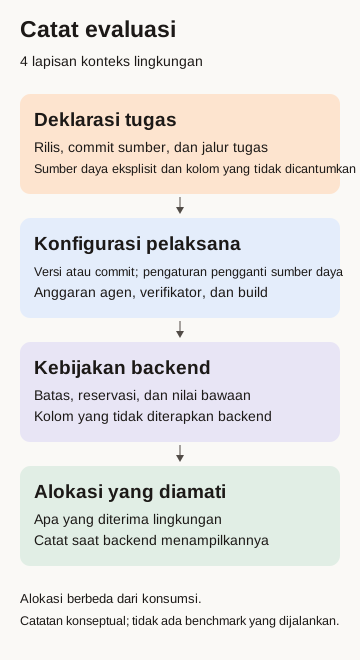
Simpan pengaturan yang diminta dan alokasi yang diamati di bidang terpisah.
Catat batas waktu agen dan pengaturan verifikasi secara terpisah
Semua 66 berkas tugas secara eksplisit membatasi waktu agen hingga 28.800 detik, atau delapan jam. Ini adalah batas yang dikonfigurasi. Batas waktu verifikasi yang dideklarasikan berkisar 60 hingga 18.000 detik, sedangkan batas tahap penyiapan lingkungan berkisar 300 hingga 18.000 detik. Pertimbangkan tiap tahap secara terpisah saat memperkirakan durasi tugas.
Pelaksana yang ditinjau dapat mengganti batas waktu dan menerapkan nilai maksimum serta pengali. Fungsi yang diperiksa menerapkan maksimum sebelum pengali. Analisis ini tidak menjumlahkan batas setiap tahap untuk memprediksi waktu keseluruhan yang berlalu. Penentuan batas waktu pada revisi yang ditinjau · Penghitungan anggaran waktu tiap tahap
Dengan aturan dari versi Harbor yang kami periksa, kami menghitung batas waktu verifikasi untuk semua 66 tugas Terminal-Bench v4.1.0. Kami mencoba nilai maksimum 600 detik dan penggantian batas waktu menjadi 600 detik secara terpisah, dengan pengali 1 pada keduanya. Batas waktu tertinggi yang dihitung adalah 600 detik pada kedua pengaturan. Nilai maksimum mempertahankan 28 batas waktu yang lebih pendek. Penggantian menaikkan semua 28 batas itu menjadi 600 detik. Untuk mempertahankan batas waktu yang lebih pendek pada konfigurasi ini, gunakan nilai maksimum dan catat pengaturan yang dipakai. Cara Harbor memilih batas waktu awal · Cara Harbor menerapkan nilai maksimum dan pengali
Batas waktu job dapat menghentikan agen yang berjalan secara lokal sebelum batas waktu agen itu sendiri tercapai. Misalnya, jika agen diberi waktu delapan jam untuk sebuah tugas, agen tidak bisa menggunakan seluruh waktu itu di dalam job yang dihosting GitHub dengan batas enam jam. Penyiapan dalam job yang sama juga mengurangi waktu yang tersedia. Catat batas waktu job dan batas waktu agen secara terpisah.
Semua tugas secara eksplisit memilih verifikasi terpisah. Enam menyertakan blok lingkungan verifikator. Fungsi Harbor yang ditinjau memilih blok yang dinyatakan eksplisit secara utuh, tanpa menggabungkan bidangnya dengan lingkungan tugas. Jika tidak ada blok terpisah, fungsi menyalin lingkungan tugas. Opsi untuk suatu percobaan masih dapat mengubah konfigurasi efektif verifikator. Pemilihan lingkungan verifikator
Catat pengaturan agen dan verifikator secara terpisah, sekalipun nilainya sama. Pemilihan verifikasi terpisah tidak menunjukkan alokasi yang sebenarnya atau apakah kedua lingkungan memakai sumber daya secara bersamaan.
Kami membandingkan deklarasi CPU, memori, penyimpanan, GPU, batas waktu, dan mode verifikasi pada Terminal-Bench 4.0 dan 4.1 untuk 66 tugas dengan nama dan jalur yang sama. Perbandingan menemukan perubahan bidang-bidang ini pada dua tugas. Di distributed-dedup, batas waktu verifikator naik dari 1.800 menjadi 3.900 detik. Di payments-pipeline-fix, nilai eksplisit verifikator naik dari 6 CPU dan 12.288 MB menjadi 8 CPU dan 16.384 MB. Ini adalah nilai yang dideklarasikan. Catatan rilis 4.1 menyebutkan bahwa semua 66 tugas diubah. Pemeriksaan ini tidak menetapkan apakah petunjuk, citra, atau verifikatornya setara.
Unduh compare-versions.py dan census.json ke folder yang sama. Dengan Python 3.11 atau lebih baru dan akses internet, jalankan python3 compare-versions.py > comparison.json dari folder itu. Skrip mengambil registri rilis 4.0 pada revisi tetap dan metadata tugas tanpa menjalankan tugas. Laporan lokal mempertahankan atribusi dan permintaan proyek agar data tolok ukur tidak dimasukkan ke korpus pelatihan.
Apa yang perlu disimpan saat konfigurasi evaluasi berubah
Pendataan ini dapat digunakan untuk menyusun catatan konfigurasi yang ringkas.
- Tetapkan set tugas. Simpan manifes rilis, revisi sumber, dan jalur tugas bersama-sama. Hitungan berkas seluruh repositori dapat mencakup materi di luar rilis tolok ukur.
- Simpan deklarasi asli. Catat nilai yang dinyatakan secara eksplisit dan bidang yang tidak disebutkan, termasuk pengaturan verifikator terpisah dan batas waktu per tahap.
- Dokumentasikan pelaksana dan opsinya. Simpan versi atau revisi yang tepat dan opsi yang mengganti atau mengalikan nilai tugas.
- Periksa kebijakan sistem pelaksana. Tentukan bidang yang menjadi batas, reservasi, nilai bawaan, atau permintaan yang tidak didukung.
- Catat alokasi yang terjadi jika dapat diamati. Pisahkan dari konfigurasi yang diminta dan pemakaian yang diukur saat tugas berjalan.
Jika sengaja mengubah batas atau alokasi, catat perubahan bersama hasilnya. Pembaca berikutnya dapat memahami kondisi evaluasi dan mempertimbangkan perbedaan antarlingkungan.
Perbandingan konfigurasi dan kode analisis memungkinkan pemeriksaan pengecualian. sapien1 meninjau tugas dan lingkungan dengan cara ini saat menentukan lingkup proyek evaluasi agen.
Untuk membandingkan batas lain, unduh filter sumber daya dan data pendataan ke folder yang sama. Sebagai contoh, python3 filter-census.py --cpus 4 --memory-mb 8192 --status within mendaftar tugas dengan nilai yang dideklarasikan dalam batas tersebut pada lingkungan tugas maupun verifikator. Keluaran mempertahankan nilai yang tidak disebutkan dan tidak membuktikan apakah suatu tugas dapat berjalan. Terminal-Bench meminta agar data tolok ukur tidak dimasukkan ke korpus pelatihan.
Bandingkan tugas yang dipilih oleh setiap batas sumber daya
Kedua contoh batas sumber daya masing-masing memilih 44 dari 66 tugas Terminal-Bench v4.1.0. Ada 36 tugas yang sama dan 8 tugas yang hanya ada di masing-masing daftar. Untuk setiap batas, filter memeriksa nilai CPU, memori, dan penyimpanan yang dideklarasikan secara terpisah untuk lingkungan tugas dan lingkungan verifikasi.
| CPU | Memori (MB) | Penyimpanan (MB) | Tugas yang memenuhi ketiga batas |
|---|---|---|---|
| 4 | 8.192 | 10.240 | 44 |
| 2 | 16.384 | 20.480 | 44 |
Jalankan kedua perintah dari folder yang berisi filter dan hasil pendataan. Pada setiap laporan, kolom task di dalam records menunjukkan ID tugas yang dipilih.
python3 filter-census.py --cpus 4 --memory-mb 8192 \
  --storage-mb 10240 --phases both --status within > ceiling-4cpu.json

python3 filter-census.py --cpus 2 --memory-mb 16384 \
  --storage-mb 20480 --phases both --status within > ceiling-2cpu.json
Saat melaporkan skor, simpan ID tugas yang tepat bersama versi tolok ukur dan pengaturan sumber daya. Jika kamu membandingkan dua eksekusi berdasarkan tugas yang sama, hitung kedua skor dengan daftar yang sama.
Metode dan ruang lingkup
Pada 17 November 2026 kami menyelesaikan pendataan semua deklarasi konfigurasi dalam satu rilis. Analisis mencakup deklarasi tersebut dan tidak mengukur performa. Revisi sumber set data Terminal-Bench adalah 4070d6c. Revisi Harbor yang ditinjau adalah ec6aeab, yang disebut sebagai versi 0.26.0 pada metadata proyek. Metode berisi hash lengkap, tautan sumber, aturan pengambilan data, dan perintah untuk mengulang pendataan.
Skrip pengumpul membaca manifes resmi dan 66 berkas TOML yang berjumlah 85.966 byte pada sumber. Skrip menyimpan bidang versi secara terpisah dan memeriksa alias sumber daya lama, langkah, dan blok lingkungan tambahan. Skrip tidak menemukan langkah atau alias lama pada rilis ini. Unduhan publik mencakup fakta konfigurasi yang dipilih dan hash sumber. Petunjuk tugas, solusi, dan lingkungan lengkap tidak disertakan.
Kami memeriksa secara independen daftar tugas dalam manifes, hitungan, dan sampel sumber yang mencakup nilai ekstrem, bidang GPU yang tidak disebutkan, serta blok verifikator eksplisit. Kami tidak menjalankan model, kontainer, atau tugas tolok ukur.