Forskning
Ressursinnstillingene for 66 oppgaver i Terminal-Bench
Språk: Norsk bokmål
Terminal-Bench v4.1.0 angir ulike ressursinnstillinger for sine 66 oppgaver. Konfigurasjonsfilene viser at 31 oppgaver angir mer enn 4 096 MB minne, og at 22 angir mer enn to prosessorer. Vi satte sammen et sammenligningsoppsett med de vanligste eksplisitte verdiene for prosessorer, minne, lagring og GPU-er. Det ligger under minst én deklarert verdi for 38 oppgaver. Forskjellene viser hvilke innstillinger teamet bør bevare eller dokumentere når det setter opp isolerte evalueringsmiljøer. De sier ikke hvordan ressursbruken blir eller om en oppgave vil feile.
Hvilke vilkår bevares hvis du kjører den samme referansetesten i et nytt miljø? Det avhenger av oppgaveversjonen, versjonen av kjøreprogrammet, valg som erstatter oppgavens verdier og reglene i det underliggende systemet.
Utgivelsen omfatter flere ressursnivåer
Vi gjennomgikk alle oppgavene i det offisielle manifestet til Terminal-Bench v4.1.0, som ble utgitt 3. november 2026. Gjennomgangen omfatter de 66 oppgavene i utgivelsen, hver med en task.toml-fil på en fast kilderevisjon. Kodelageret inneholder også eldre oppgaver og testfiler som faller utenfor gjennomgangen. Offisiell utgivelse og manifest
De oppgitte verdiene for hovedmiljøet varierer fra 2 til 16 prosessorer og fra 4 096 til 32 768 MB minne. To prosessorer er vanligst, med 44 oppgaver. For minne er 4 096 MB vanligst, med 35 oppgaver. Resten fordeler seg på høyere verdier.
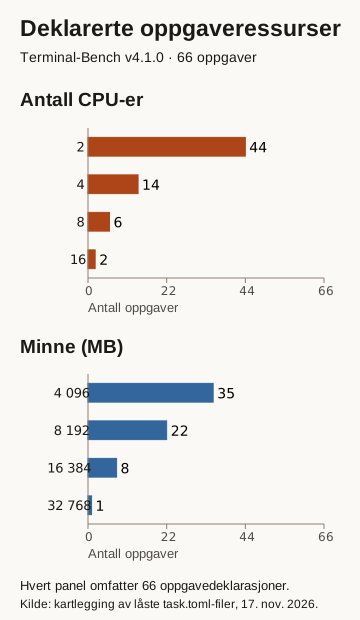
Begge delene av figuren dekker de samme 66 oppgavemiljøene. Verdiene er hentet fra konfigurasjonsfilene til utgivelsen. De fullstendige observasjonene inneholder en lenke til den faste revisjonen og kildefilens hashverdi for hver oppgave.
Dette har betydning når et team standardiserer infrastrukturen. Et enhetlig miljø kan forenkle planleggingen, men endrer enkelte deklarerte vilkår dersom kjøreprogrammet ikke bruker de oppgavespesifikke innstillingene. Mer tilgjengelig maskinvare bevarer heller ikke automatisk en lavere deklarert grense. Sammenligningen avhenger av hvilke regler kjøreprogrammet og det underliggende systemet faktisk håndhever.
Et oppsett med vanlige verdier endrer mange deklarasjoner
Sammenligningsoppsettet kombinerer den vanligste eksplisitte verdien fra hvert av de fire feltene.
| Felt | Verdi i sammenligningsoppsettet |
|---|---|
| Prosessorer | 2 |
| Minne | 4 096 MB |
| Lagring | 10 240 MB |
| GPU-er | 0 |
Vi laget oppsettet for analysen. Det er verken en Harbor-standard, en leverandøranbefaling eller et observert driftsoppsett. Verdiene er vanlige hver for seg. Frekvensen av den fullstendige kombinasjonen kan være en annen.
For hver oppgave sjekket vi om minst én uttrykkelig deklarert verdi var høyere enn den tilsvarende verdien i oppsettet. Det gjaldt 38 av 66 oppgaver. Antallet per felt var 22 for prosessorer, 31 for minne, 17 for lagring og tre for GPU-antallet. Gruppene overlapper, så å summere dem ville telt noen oppgaver flere ganger. Sammenligningsresultatene inneholder nøyaktige oppgave-ID-er for den samlede mengden og hvert felt.
I de øvrige 28 oppgavene ligger ingen registrert verdi over disse fire sammenligningsverdiene. Det viser ikke at oppsettet er kompatibelt med dem. Åtte oppgaver utelater GPU-antallet. Gjennomgangen bevarer dette som en utelatelse fremfor å registrere null. Filer, tilleggscontainere, avbildninger og tjenester kan også gi krav utenfor de fire feltene.
For kjøringer uten GPU tilbyr vedlikeholderne et eget datasett med 63 oppgaver for CPU i Terminal-Bench 4.1.0. Kjør det med harbor run -d terminal-bench/terminal-bench-cpu-only@4.1.0 og rapporter resultatene separat fra poengsummene for alle 66 oppgaver. At en oppgave er med i datasettet, viser ikke at den holder seg innenfor en bestemt grense for prosessorer, minne eller lagring.
Bruk listen over avvik til å sjekke hvilke innstillinger et standardisert oppsett ville endre før kjøringen.
Kjøreprogrammet og det underliggende systemet tolker deklarasjonen
Oppgavefilen beskriver én del av evalueringen. For å forstå hvordan deklarasjonene brukes, undersøkte vi Harbor på en fast kilderevisjon der pakkemetadata oppgir versjon 0.26.0.
I den undersøkte koden kan valg for det enkelte forsøket erstatte oppgavens ressursverdier. Prosessor- og minnereglene kan også avgjøre om verdiene blir brukt eller ignorert. Parseren lar utelatte verdier for prosessorer, minne og lagring stå usatt. Basismiljøet tolker et utelatt GPU-antall som null i kjøringen. Gjennomgangen bevarer den opprinnelige utelatelsen, slik at leseren kan skille oppgavens innstilling fra kjøreprogrammets tolkning. Miljølogikken til Harbor på den undersøkte revisjonen
Det underliggende systemet har også betydning. Docker-adapteren vi undersøkte, gjør sine automatiske regler for prosessorer og minne om til grenser. Den ignorerer valget av GPU-type uttrykkelig, og koden som skriver Compose-ressurser, setter ikke et lagringstak. Tre oppgaver oppgir en H100 uttrykkelig. Det feltet alene viser ikke at Docker tildeler en H100. På samme måte etablerer en storage_mb-verdi alene ingen diskgrense i Docker. Compose-konfigurasjonen kan legge til begrensninger, og andre kjøreplattformer kan behandle verdiene annerledes. Docker-adapteren · Koden som skriver Compose-ressursene
For å gjøre evalueringen reproduserbar, behold deklarasjonen og noter hvordan den valgte plattformen brukte den. Innstillingene som ble forespurt og ressursene som faktisk ble tildelt, svarer på forskjellige spørsmål.
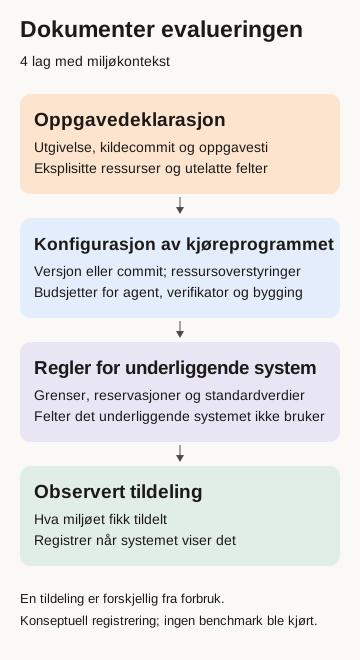
Registrer forespurte innstillinger og observerte tildelinger i separate felt.
Registrer tidsgrenser og verifikatorinnstillinger separat
Alle 66 oppgavefiler angir uttrykkelig 28 800 sekunder som agentens tidsgrense, altså åtte timer. Det er den konfigurerte øvre grensen. De angitte tidsgrensene for verifisering ligger mellom 60 og 18 000 sekunder. For oppbygging av miljøet er de mellom 300 og 18 000 sekunder. Hold fasene fra hverandre når du anslår hvor lang tid en oppgave tar.
Kjøreprogrammet vi undersøkte, kan erstatte tidsgrenser og bruke maksimalverdier og faktorer. I den undersøkte funksjonen brukes maksimalverdien før faktoren. Analysen summerer ikke fasegrensene for å beregne faktisk forløpt tid. Fastsetting av tidsgrenser i den undersøkte revisjonen · Beregning av tidsbudsjett per fase
Med reglene fra Harbor-versjonen vi undersøkte, beregnet vi tidsgrensene for verifisering for alle 66 oppgavene i Terminal-Bench v4.1.0. Vi prøvde en maksimalverdi på 600 sekunder og en erstatningsverdi på 600 sekunder hver for seg. Faktoren var 1 i begge tilfeller. Den høyeste beregnede tidsgrensen ble 600 sekunder med begge innstillingene. Maksimalverdien beholdt de 28 kortere tidsgrensene. Erstatningsverdien økte alle 28 til 600 sekunder. Bruk maksimalverdien hvis du vil beholde de kortere tidsgrensene i dette oppsettet, og registrer innstillingen du brukte. Slik velger Harbor den opprinnelige tidsgrensen · Slik bruker Harbor maksimalverdien og faktoren
Tidsgrensen for den overordnede jobben kan stoppe en agent som kjører lokalt, før agentens egen tidsgrense nås. Hvis agenten for eksempel har åtte timer til en oppgave, kan den ikke bruke alle åtte i en jobb som kjøres på GitHubs infrastruktur med en tidsgrense på seks timer. Klargjøring i den samme jobben tar også av tiden som er tilgjengelig. Registrer jobbens og agentens tidsgrenser separat.
Alle oppgaver velger uttrykkelig separat verifisering. Seks gir en egen miljøblokk for verifikatoren. Harbor-funksjonen vi undersøkte, velger en eksplisitt verifikatorblokk i sin helhet uten å slå sammen feltene med oppgavemiljøet. Uten en egen blokk kopierer den oppgavemiljøet. Alternativer for det enkelte forsøket kan fortsatt endre den effektive verifikatorkonfigurasjonen. Valg av verifikatorens miljø
Dokumenter agent- og verifikatorinnstillinger separat, også når de samsvarer. Separat verifisering sier i seg selv ikke hvilke ressurser som tildeles eller om miljøene bruker ressurser samtidig.
Vi sammenlignet deklarasjoner for prosessorer, minne, lagring, GPU-er, tidsgrenser og verifikasjonsmodus i Terminal-Bench 4.0 og 4.1 for de 66 oppgavene med samme navn og stier. Sammenligningen viste at disse feltene endret seg for to oppgaver. I distributed-dedup økte verifikatorens tidsgrense fra 1 800 til 3 900 sekunder. I payments-pipeline-fix økte de eksplisitte verifikatorverdiene fra 6 prosessorer og 12 288 MB til 8 prosessorer og 16 384 MB. Dette er deklarerte verdier, ikke observert tildeling. Utgivelsesnotatene for 4.1 opplyser at alle 66 oppgaver ble endret. Denne avgrensede sammenligningen avgjør ikke om instruksjoner, avbildninger eller verifikatorer er likeverdige.
Last ned compare-versions.py og census.json til samme mappe. Kjør python3 compare-versions.py > comparison.json fra mappen med Python 3.11 eller nyere og internettilgang. Skriptet henter den faste revisjonen av 4.0-registeret og metadata om oppgavene uten å kjøre dem. Den lokale rapporten bevarer krediteringen og prosjektets anmodning om å holde dataene utenfor treningskorpuser.
Hva du bør bevare når du endrer evalueringsoppsettet
Gjennomgangen gir grunnlag for en kort konfigurasjonslogg.
- Lås oppgavemengden. Behold utgivelsesmanifestet, kilderevisjonen og oppgavestiene samlet. Antallet filer i hele kodelageret kan omfatte materiale utenfor utgivelsen.
- Behold de opprinnelige deklarasjonene. Registrer eksplisitte verdier og utelatelser, inkludert egne verifikatorinnstillinger og tidsgrenser for hver fase.
- Dokumenter kjøreprogrammet og valgene. Lagre nøyaktig versjon eller revisjon og valgene som erstatter eller skalerer oppgaveinnstillinger.
- Sjekk reglene på kjøreplattformen. Se hvilke felt som blir grenser, reservasjoner, standardverdier eller forespørsler uten støtte.
- Registrer faktisk tildeling når den kan observeres. Hold den adskilt fra ønsket konfigurasjon og målt forbruk under kjøringen.
Hvis du bevisst endrer en grense eller tildeling, bør du dokumentere det ved resultatet. En senere leser kan da forstå vilkårene for evalueringen og ta hensyn til miljøforskjeller.
Konfigurasjonssammenligningen og analysekoden lar deg undersøke unntakene. sapien1 bruker denne typen gjennomgang av oppgaver og miljøer ved avgrensning av prosjekter for agentevaluering.
For å sammenligne andre grenser, last ned ressursfilteret og dataene fra gjennomgangen til samme mappe. python3 filter-census.py --cpus 4 --memory-mb 8192 --status within lister for eksempel opp de oppgitte verdiene som holder seg innenfor grensene i både oppgave- og verifikatormiljøet. Utdata beholder utelatelser og avgjør ikke om oppgaven kan kjøres. Terminal-Bench ber om at data fra referansetesten holdes utenfor treningskorpuser.
Sammenlign oppgavene som velges med hvert sett med grenser
Hvert av de to eksemplene på ressursgrenser velger 44 av de 66 oppgavene i Terminal-Bench v4.1.0. Listene har 36 oppgaver felles og 8 oppgaver hver som bare finnes på den ene listen. For hvert sett med grenser sjekker filteret de oppgitte verdiene for prosessorer, minne og lagring separat i oppgavemiljøet og verifiseringsmiljøet.
| Prosessorer | Minne (MB) | Lagring (MB) | Oppgaver innenfor alle tre grensene |
|---|---|---|---|
| 4 | 8 192 | 10 240 | 44 |
| 2 | 16 384 | 20 480 | 44 |
Kjør begge kommandoene fra mappen med filteret og kartleggingsfilen. I hver rapport viser task-feltene i records ID-ene til oppgavene som ble valgt.
python3 filter-census.py --cpus 4 --memory-mb 8192 \
  --storage-mb 10240 --phases both --status within > ceiling-4cpu.json

python3 filter-census.py --cpus 2 --memory-mb 16384 \
  --storage-mb 20480 --phases both --status within > ceiling-2cpu.json
Lagre de nøyaktige oppgave-ID-ene sammen med benchmarkversjonen og ressursinnstillingene når du rapporterer en poengsum. Hvis du sammenligner to kjøringer på de felles oppgavene, beregner du begge poengsummene ut fra den samme listen.
Metode og omfang
Vi fullførte den 17. november 2026 en gjennomgang av alle konfigurasjonsdeklarasjoner i én utgivelse. Arbeidet dekker disse deklarasjonene og måler ikke ytelse. Kilderevisjonen til Terminal-Bench-datasettet er 4070d6c. Harbor-revisjonen vi undersøkte, er ec6aeab, identifisert som versjon 0.26.0 i prosjektmetadataene. Metoden inneholder komplette hashverdier, kildelenker, regler for uttrekk og kommandoer for å gjenta analysen.
Innsamlingsskriptet leser det offisielle manifestet og 66 TOML-filer med til sammen 85 966 byte kildedata. Det bevarer versjonsfeltene separat og sjekker etter eldre ressursaliaser, trinn og ekstra miljøblokker. Det fant ingen trinn eller eldre ressursaliaser i denne versjonen. De offentlige nedlastingene inneholder utvalgte konfigurasjonsopplysninger og kildehashverdier. Oppgaveinstruksjoner, løsninger og fullstendige miljøer er ikke med.
Vi sjekket uavhengig hvilke oppgaver manifestet omfatter, beregningene og et utvalg kildefiler med en avvikende verdi, et utelatt GPU-felt og en uttrykkelig verifikatorblokk. Vi kjørte ingen modeller, containere eller oppgaver fra referansetesten.