Forskning
Resursinställningarna i 66 uppgifter från Terminal-Bench
Språk: Svenska
Terminal-Bench v4.1.0 anger olika resursinställningar för sina 66 uppgifter. Genomgången av konfigurationsfilerna visade att 31 uppgifter anger mer än 4 096 MB minne och att 22 anger fler än två processorer. Vi tog fram en jämförelsekonfiguration med de vanligaste uttryckligen angivna värdena för processorer, minne, lagring och GPU:er. Den ligger under minst ett angivet värde för 38 uppgifter. Skillnaderna visar vilka inställningar ett team bör bevara eller dokumentera när det förbereder isolerade utvärderingsmiljöer. De förutsäger varken resursförbrukning eller om uppgifterna kommer att misslyckas.
Vilka villkor följer med om du kör samma benchmark i en ny miljö? Svaret beror på uppgiftens version, körprogrammets version, alternativ som ersätter inställningar och reglerna i den underliggande körmiljön.
Versionen omfattar uppgifter med olika resursnivåer
Vi granskade alla uppgifter i det officiella manifestet för Terminal-Bench v4.1.0, som släpptes den 3 november 2026. Genomgången omfattar de 66 uppgifterna i versionen, var och en med en task.toml-fil på en fast källrevision. Kodarkivet innehåller också äldre uppgifter och testfiler som ligger utanför genomgången. Officiell version och manifest
I huvudmiljön varierar de angivna värdena mellan 2 och 16 processorer och mellan 4 096 och 32 768 MB minne. Två processorer är den vanligaste angivelsen och förekommer i 44 uppgifter. För minne är 4 096 MB vanligast, i 35 uppgifter. Övriga uppgifter har högre värden.
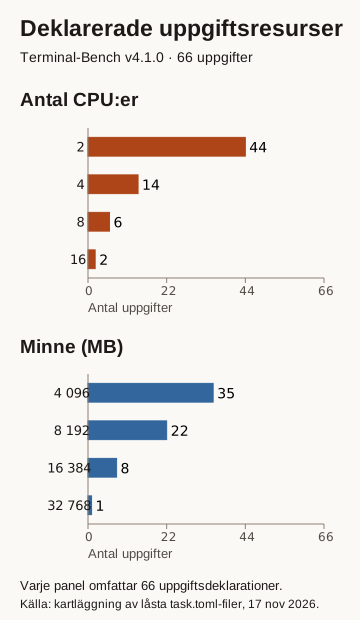
Båda delarna av figuren omfattar samma 66 uppgiftsmiljöer. Värdena kommer från versionens konfigurationsfiler. De fullständiga uppgifterna innehåller en länk till den fasta revisionen och källfilens hashvärde för varje uppgift.
Skillnaderna spelar roll när ett team standardiserar sin infrastruktur. En enhetlig miljö kan förenkla planeringen men ändrar vissa angivna villkor om körprogrammet inte tillämpar de uppgiftsspecifika inställningarna. Mer tillgänglig hårdvara bevarar inte automatiskt en lägre angiven gräns. Jämförelsen beror på vilka gränser körprogrammet och den underliggande miljön faktiskt tillämpar.
En konfiguration med vanliga värden ändrar många inställningar
Jämförelsekonfigurationen kombinerar det vanligaste uttryckligen angivna värdet i vart och ett av fyra fält.
| Fält | Värde i jämförelsekonfigurationen |
|---|---|
| Processorer | 2 |
| Minne | 4 096 MB |
| Lagring | 10 240 MB |
| GPU:er | 0 |
Vi tog fram kombinationen för analysen. Den motsvarar varken Harbors standardinställningar, en leverantörs rekommendation eller en observerad driftsättning. Värdena är vanliga var för sig. Hur ofta hela konfigurationen förekommer kan skilja sig.
För varje uppgift kontrollerade vi om något uttryckligt värde låg över motsvarande jämförelsevärde. Det gällde 38 av 66 uppgifter. Antalet per fält var 22 för processorer, 31 för minne, 17 för lagring och tre för GPU-antal. Grupperna överlappar, så en summering skulle räkna vissa uppgifter flera gånger. Jämförelseresultaten innehåller exakta uppgifts-ID:n för hela mängden och för varje fält.
I de övriga 28 uppgifterna ligger inget registrerat värde över dessa fyra jämförelsevärden. Det räcker inte för att visa att konfigurationen fungerar för dem. Åtta uppgifter saknar GPU-antal. Genomgången behåller den uppgiften som utelämnad i stället för att ange noll. Filer, sidocontainrar, avbilder och tjänster kan också ställa krav utanför de fyra fälten.
För körningar utan GPU tillhandahåller projektets utvecklare en separat datamängd med 63 uppgifter för enbart CPU i Terminal-Bench 4.1.0. Kör den med harbor run -d terminal-bench/terminal-bench-cpu-only@4.1.0 och redovisa dess resultat separat från poängen för den fullständiga versionen med 66 uppgifter. Att en uppgift finns i datamängden visar inte att den ryms inom en viss processor-, minnes- eller lagringsgräns.
Använd listan över avvikelser före körningen för att se vilka inställningar en standardiserad miljö skulle ändra.
Körprogrammet och den underliggande miljön tolkar de angivna värdena
Uppgiftsfilen beskriver en del av utvärderingskonfigurationen. För att se hur uppgifterna används granskade vi Harbor på en fast källrevision vars paketmetadata anger version 0.26.0.
I den granskade koden kan inställningar för en enskild körning ersätta uppgiftens resursvärden. Regler för processorer och minne kan också avgöra om värdena tillämpas eller ignoreras. Parsern lämnar utelämnade värden för processorer, minne och lagring osatta. Basmiljön tolkar ett utelämnat GPU-antal som noll. Genomgången behåller ursprungliga utelämnanden så att läsaren kan skilja uppgiftens inställning från körprogrammets tolkning. Harbors miljölogik vid den granskade revisionen
Även den underliggande miljön påverkar resultatet. Den granskade Docker-adaptern omsätter sina automatiska regler för processorer och minne till gränser. Den ignorerar uttryckligen valet av GPU-typ, och koden som skriver Compose-resurser anger inget lagringstak. Tre uppgifter anger uttryckligen en H100. Uppgiften i det fältet räcker inte för att visa att Docker tilldelar en sådan. På samma sätt är storage_mb i sig inget belägg för en diskgräns i Docker. Compose-konfigurationen kan lägga till begränsningar och andra körmiljöer kan hantera värdena annorlunda. Docker-adaptern · Koden som skriver Compose-resurser
För att utvärderingen ska gå att upprepa, spara uppgiftens deklaration och dokumentera vad den valda körmiljön gjorde med den. De begärda inställningarna och den faktiska tilldelningen svarar på olika frågor.
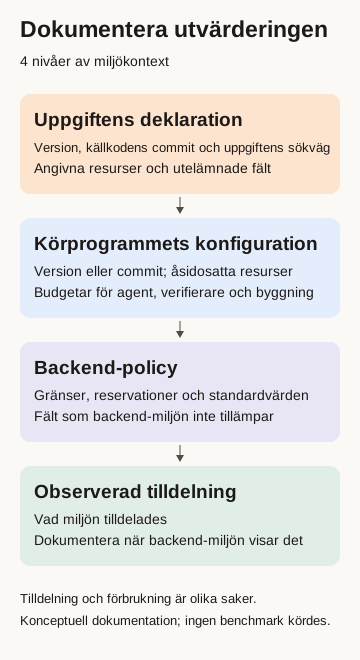
Registrera de begärda inställningarna och de observerade tilldelningarna i separata fält.
Dokumentera agentens och verifierarens tidsgränser separat
Alla 66 uppgiftsfiler anger uttryckligen 28 800 sekunder som agentens tidsgräns, alltså åtta timmar. Det är ett inställt maxvärde. De angivna tidsgränserna för verifiering sträcker sig från 60 till 18 000 sekunder och för bygget från 300 till 18 000 sekunder. Håll isär faserna när du uppskattar hur lång tid en uppgift tar.
Det granskade körprogrammet kan ersätta tidsgränser och tillämpa maxvärden och multiplikatorer. I den granskade funktionen tillämpas maxvärdet före multiplikatorn. Analysen summerar inte fasernas gränser för att förutsäga den totala tiden. Tillämpning av tidsgränser i den granskade koden · Beräkning av tidsbudgeten per fas
Med reglerna från den version av Harbor som vi granskade räknade vi ut tidsgränserna för verifiering för alla 66 uppgifter i Terminal-Bench v4.1.0. Vi prövade ett maxvärde på 600 sekunder och ett ersättningsvärde på 600 sekunder var för sig. Multiplikatorn var 1 i båda fallen. Den högsta beräknade tidsgränsen blev 600 sekunder med båda inställningarna. Maxvärdet behöll de 28 kortare tidsgränserna. Ersättningsvärdet höjde alla 28 till 600 sekunder. Använd maxvärdet för att behålla de kortare tidsgränserna i det här upplägget och dokumentera vilken inställning du använde. Så väljer Harbor den ursprungliga tidsgränsen · Så tillämpar Harbor maxvärdet och multiplikatorn
Tidsgränsen för det överordnade jobbet kan stoppa en agent som körs lokalt innan agentens egen tidsgräns nås. Om agenten till exempel får åtta timmar för en uppgift kan den inte använda alla åtta i ett jobb som körs på GitHubs infrastruktur med en tidsgräns på sex timmar. Förberedelser inom samma jobb tar också av den tid som finns tillgänglig. Dokumentera tidsgränsen för jobbet och tidsgränsen för agenten separat.
Varje uppgift väljer uttryckligen separat verifiering. Sex anger ett miljöblock för verifieraren. I den granskade Harbor-funktionen väljs ett uttryckligt verifierarblock i sin helhet, utan att slå ihop dess fält med uppgiftsmiljöns. Om ett separat block saknas kopierar funktionen uppgiftsmiljön. Inställningar för en enskild körning kan ändå påverka verifierarens effektiva konfiguration. Hur verifierarens miljö väljs
Dokumentera agentens och verifierarens inställningar var för sig, även när de stämmer överens. Separat verifiering säger i sig inget om den faktiska resurstilldelningen eller om miljöerna använder resurser samtidigt.
Vi jämförde angivelserna för processorer, minne, lagring, GPU:er, tidsgränser och verifieringsläge mellan Terminal-Bench 4.0 och 4.1 för de 66 uppgifter som har samma namn och sökvägar. Jämförelsen visade ändringar i dessa fält för två uppgifter. För distributed-dedup ökade verifierarens tidsgräns från 1 800 till 3 900 sekunder. För payments-pipeline-fix höjdes verifierarens uttryckliga värden från 6 processorer och 12 288 MB till 8 processorer och 16 384 MB. Det här är angivna värden. Enligt versionsanteckningarna för 4.1 har alla 66 uppgifter ändrats. Den avgränsade kontrollen lämnar öppet om instruktioner, avbilder och verifierare är likvärdiga.
Ladda ned compare-versions.py och census.json till samma mapp. Använd Python 3.11 eller senare och internetanslutning och kör python3 compare-versions.py > comparison.json från den mappen. Skriptet hämtar den fasta revisionen av registret för version 4.0 och uppgiftsmetadata utan att köra uppgifterna. Den lokala rapporten bevarar källangivelsen och projektets begäran om att hålla benchmarkdata utanför träningskorpusar.
Vad du bör spara när utvärderingens inställningar ändras
Genomgången ger underlag för en kort konfigurationsbeskrivning.
- Lås uppgiftsmängden. Spara versionsmanifestet, källrevisionen och uppgifternas sökvägar tillsammans. Antalet filer i hela kodarkivet kan omfatta material utanför benchmarkversionen.
- Bevara ursprungsdeklarationerna. Registrera uttryckliga värden och utelämnade fält, inklusive separata verifierarinställningar och tidsgränser för varje fas.
- Dokumentera körprogrammet och dess alternativ. Spara den exakta versionen eller revisionen och alternativen som ersätter eller multiplicerar uppgiftsvärdena.
- Kontrollera reglerna för körmiljön. Se vilka fält som omsätts till gränser, reservationer, standardvärden eller begäranden som inte stöds.
- Dokumentera den faktiska tilldelningen när den kan observeras. Håll den åtskild från inställningarna som begärdes och förbrukningen som mättes under körningen.
Om du medvetet ändrar en gräns eller tilldelning ska du dokumentera ändringen tillsammans med resultatet. Då kan en framtida läsare förstå förutsättningarna för utvärderingen och ta hänsyn till skillnaderna mellan miljöerna.
Med konfigurationsjämförelsen och analyskoden kan du granska avvikelserna. sapien1 gör sådana granskningar av uppgifter och miljöer vid planering av projekt för agentutvärdering.
Ladda ned resursfiltret och genomgångens data till samma mapp för att jämföra andra gränser. python3 filter-census.py --cpus 4 --memory-mb 8192 --status within listar till exempel uppgifter där de angivna värdena ligger inom gränserna både i uppgiftsmiljön och i verifieringsmiljön. Utdata bevarar utelämnade fält och räcker inte för att avgöra om uppgiften kan köras. Terminal-Bench ber att data från benchmarken hålls utanför träningskorpusar.
Jämför uppgifterna som väljs vid varje resursgräns
Vart och ett av de två exemplen på resursgränser väljer 44 av de 66 uppgifterna i Terminal-Bench v4.1.0. Listorna har 36 uppgifter gemensamt och 8 uppgifter som bara finns i respektive lista. För varje uppsättning gränser kontrollerar filtret de angivna värdena för processorer, minne och lagring separat i uppgiftsmiljön och verifieringsmiljön.
| Processorer | Minne (MB) | Lagring (MB) | Uppgifter inom alla tre gränser |
|---|---|---|---|
| 4 | 8 192 | 10 240 | 44 |
| 2 | 16 384 | 20 480 | 44 |
Kör båda kommandona från mappen med filtret och inventeringsfilen. I varje rapport visar task-fälten i records vilka uppgifts-ID:n som valdes.
python3 filter-census.py --cpus 4 --memory-mb 8192 \
  --storage-mb 10240 --phases both --status within > ceiling-4cpu.json

python3 filter-census.py --cpus 2 --memory-mb 16384 \
  --storage-mb 20480 --phases both --status within > ceiling-2cpu.json
Spara exakta uppgifts-ID:n tillsammans med benchmarkversionen och resursinställningarna när du rapporterar ett resultat. Om du jämför två körningar på deras gemensamma uppgifter ska du beräkna båda resultaten över samma lista.
Metod och omfattning
Den 17 november 2026 slutförde vi genomgången av deklarerade konfigurationsvärden i en enda version. Genomgången täcker dessa angivelser och mäter inga prestanda. Källrevisionen för Terminal-Bench är 4070d6c. Harbor granskades vid revision ec6aeab, identifierad som version 0.26.0 i projektets metadata. Metoden innehåller fullständiga hashvärden, källänkar, uttagsregler och kommandon för att göra om genomgången.
Insamlingsskriptet läser det officiella manifestet och 66 TOML-filer med totalt 85 966 byte källdata. Det bevarar versionsfälten separat och letar efter äldre resursalias, steg och ytterligare miljöblock. Skriptet hittade inga steg eller äldre resursalias i versionen. De offentliga nedladdningarna innehåller valda konfigurationsuppgifter och källornas hashvärden. Uppgiftsinstruktioner, lösningar och fullständiga miljöer ingår inte.
Vi kontrollerade fristående vilka uppgifter manifestet omfattade, beräkningarna och källexempel med ett avvikande värde, en utelämnad GPU-angivelse och ett uttryckligt verifieringsblock. Vi körde inga modeller, containrar eller benchmarkuppgifter.