Forskning
Ressourceindstillingerne i 66 Terminal-Bench-opgaver
Sprog: Dansk
Terminal-Bench v4.1.0 angiver forskellige ressourceindstillinger for sine 66 opgaver. Gennemgangen af konfigurationsfilerne viste, at 31 opgaver angiver mere end 4.096 MB hukommelse, og at 22 angiver mere end to CPU'er. Vi sammensatte en konfiguration med de hyppigste udtrykkelige værdier for CPU, hukommelse, lager og GPU. Den ligger under mindst én angivet værdi i 38 opgaver. Forskellene viser, hvilke indstillinger der bør bevares eller dokumenteres, når et team opretter isolerede evalueringsmiljøer. De kan ikke forudsige ressourceforbruget eller opgaver, der mislykkes.
Hvilke vilkår bevares, når du kører den samme benchmark i et nyt miljø? Det afhænger af opgavens og kørselsprogrammets versioner, de indstillinger der erstatter opgavens værdier, og reglerne i det system der afvikler opgaven.
Udgivelsen omfatter flere ressourceniveauer
Vi gennemgik alle opgaver i det officielle manifest for Terminal-Bench v4.1.0, som blev udgivet 3. november 2026. Gennemgangen omfatter alle 66 opgaver i udgivelsen, hver med en task.toml-fil på en fast kilderevision. Kodearkivet indeholder også tidligere opgaver og hjælpefiler til test, der falder uden for gennemgangen. Officiel udgivelse og manifest
De angivne værdier for hovedmiljøet spænder fra 2 til 16 CPU'er og fra 4.096 til 32.768 MB hukommelse. To CPU'er er den mest almindelige værdi og forekommer i 44 opgaver. For hukommelse er 4.096 MB mest almindeligt og forekommer i 35 opgaver. De øvrige opgaver fordeler sig på højere værdier.
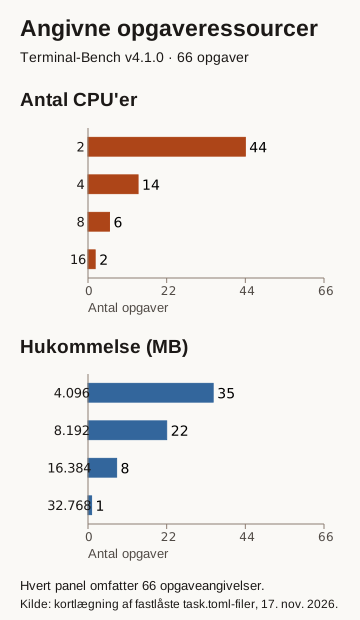
Begge dele af figuren dækker de samme 66 opgavemiljøer. Værdierne kommer fra udgivelsens konfigurationsfiler. De fulde observationer indeholder en henvisning til den faste revision og kildefilens hashværdi for hver opgave.
Forskellene har betydning, når et team ensretter sin infrastruktur. Et ensartet miljø kan forenkle planlægningen, men ændrer nogle angivne vilkår, hvis kørselsprogrammet ikke anvender de opgavespecifikke indstillinger. Mere tilgængelig hardware bevarer heller ikke automatisk en lavere angivet grænse. Sammenligningen afhænger af, hvilke grænser kørselsprogrammet og det bagvedliggende system håndhæver.
En konfiguration med almindelige værdier ændrer mange angivelser
Til sammenligningen valgte vi den hyppigste udtrykkeligt angivne værdi for hvert af de fire felter.
| Felt | Værdi i sammenligningskonfigurationen |
|---|---|
| CPU'er | 2 |
| Hukommelse | 4.096 MB |
| Lager | 10.240 MB |
| GPU'er | 0 |
Vi sammensatte konfigurationen til analysen. Den svarer hverken til Harbors standard, en anbefaling fra en leverandør eller en observeret udrulning. Værdierne er almindelige hver for sig. Den samlede kombination kan forekomme en anden andel af gangene.
For hver opgave kontrollerede vi, om mindst én udtrykkelig angivelse lå over den tilsvarende sammenligningsværdi. Det gjaldt 38 af 66 opgaver. Fordelt på felt overskred 22 opgaver CPU-værdien, 31 hukommelsesværdien, 17 lagerværdien og tre antallet af GPU'er. Grupperne overlapper, så en samlet optælling af felterne ville medregne nogle opgaver flere gange. Sammenligningsresultaterne indeholder de præcise opgave-id'er for den samlede mængde og for hvert felt.
I de øvrige 28 opgaver ligger ingen registreret værdi over de fire sammenligningsværdier. Det fastslår ikke, at konfigurationen er kompatibel med opgaverne. Otte opgaver udelader antallet af GPU'er. Gennemgangen lader feltet stå som udeladt i stedet for at angive nul. Filer, hjælpecontainere, images og tjenester kan stille krav ud over de fire felter.
Til kørsler uden GPU tilbyder vedligeholderne i Terminal-Bench 4.1.0 et særskilt datasæt med 63 opgaver til CPU. Kør det med harbor run -d terminal-bench/terminal-bench-cpu-only@4.1.0, og angiv resultater for datasættet særskilt fra resultaterne for alle 66 opgaver. At en opgave indgår, viser ikke, om den holder sig inden for en bestemt grænse for CPU, hukommelse eller lager.
Brug listen over undtagelser til at se, hvilke indstillinger et standardiseret miljø ville ændre før en kørsel.
Kørselsprogrammet og det bagvedliggende system fortolker angivelserne
Opgavefilen udgør en del af evalueringskonfigurationen. For at forstå, hvordan angivelserne bruges, gennemgik vi Harbor på en fast revision, hvor pakkens metadata angiver version 0.26.0.
I den gennemgåede kode kan indstillinger for det enkelte forsøg erstatte opgavens ressourceværdier. Reglerne for CPU og hukommelse kan også afgøre, om værdierne anvendes eller ignoreres. Parseren lader udeladte værdier for CPU, hukommelse og lager stå uden værdi. Basismiljøet fortolker et udeladt GPU-antal som nul ved kørsel. Gennemgangen bevarer de oprindelige udeladelser, så læseren kan skelne mellem opgavens indstilling og kørselsprogrammets fortolkning. Harbors miljølogik på den gennemgåede revision
Det bagvedliggende system påvirker også resultatet. Den gennemgåede Docker-adapter omsætter sine automatiske regler for CPU og hukommelse til grænser. Den ignorerer udtrykkeligt valget af GPU-type, og koden, der skriver Compose-ressourcer, sætter ingen lagergrænse. Tre opgaver angiver udtrykkeligt en H100. Det felt alene viser ikke, at Docker tildeler en H100. På samme måde fastsætter storage_mb alene ingen diskgrænse i Docker. En Compose-konfiguration kan tilføje begrænsninger, og andre systemer kan behandle angivelserne anderledes. Docker-adapteren · Koden, der skriver Compose-ressourcer
For at gøre evalueringen reproducerbar skal du bevare deklarationen og registrere, hvordan det valgte system brugte den. Den ønskede indstilling og den faktiske tildeling besvarer forskellige spørgsmål.
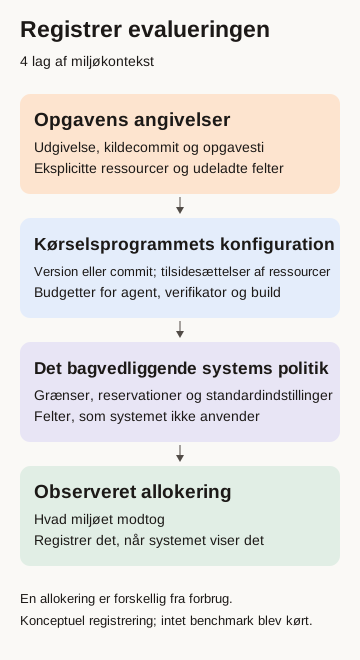
Registrer de ønskede indstillinger og de observerede tildelinger i separate felter.
Registrer agentens tidsgrænser og verifikatorens indstillinger hver for sig
Alle 66 opgavefiler angiver udtrykkeligt en tidsgrænse på 28.800 sekunder for agenten, svarende til otte timer. Det er en konfigureret øvre grænse. De angivne grænser for verifikation går fra 60 til 18.000 sekunder. For opbygning af miljøet går de fra 300 til 18.000 sekunder. Hold faserne adskilt, når du anslår opgavens varighed.
Det gennemgåede kørselsprogram kan erstatte tidsgrænser og anvende maksimumværdier og multiplikatorer. Den gennemgåede funktion anvender maksimumværdien før multiplikatoren. Analysen lægger ikke fasegrænserne sammen for at forudsige den samlede tid. Fastlæggelse af tidsgrænser i den gennemgåede revision · Beregning af tidsbudget pr. fase
Med reglerne fra den version af Harbor, vi gennemgik, beregnede vi tidsgrænser for verifikation for alle 66 opgaver i Terminal-Bench v4.1.0. Vi prøvede et maksimum på 600 sekunder og en erstatningsværdi på 600 sekunder hver for sig. Multiplikatoren var 1 i begge tilfælde. Begge indstillinger gav en højeste beregnet tidsgrænse på 600 sekunder. Maksimum bevarede de 28 kortere tidsgrænser. Erstatningsværdien hævede alle 28 til 600 sekunder. Brug maksimum, hvis du vil bevare de kortere tidsgrænser i denne opsætning, og registrer den indstilling, du brugte. Sådan vælger Harbor den oprindelige tidsgrænse · Sådan anvender Harbor maksimum og multiplikator
En tidsgrænse for det overordnede job kan stoppe en agent, der kører lokalt, før agentens egen tidsgrænse er nået. Hvis agenten for eksempel har otte timer til en opgave, kan den ikke få alle otte timer i et job, som GitHub hoster, med en grænse på seks timer. Klargøring i det samme job bruger også af den tilgængelige tid. Registrer jobbets og agentens tidsgrænser hver for sig.
Alle opgaver vælger udtrykkeligt særskilt verifikation. Seks angiver en miljøblok til verifikatoren. Den gennemgåede Harbor-funktion vælger en udtrykkeligt angivet blok som helhed uden at flette felterne med opgavemiljøets. Uden en separat blok kopierer funktionen opgavemiljøet. Indstillinger for den enkelte kørsel kan stadig ændre verifikatorens effektive konfiguration. Valg af verifikatorens miljø
Registrer agentens og verifikatorens indstillinger hver for sig, også når de er ens. Særskilt verifikation fortæller i sig selv ikke, hvilke ressourcer der faktisk er tildelt, eller om de to miljøer bruger ressourcer samtidig.
Vi sammenlignede angivelser for CPU, hukommelse, lager, GPU, tidsgrænser og verifikationsform i Terminal-Bench 4.0 og 4.1 for de 66 opgaver med samme navne og stier. Sammenligningen fandt ændringer i felterne for to opgaver. For distributed-dedup steg verifikatorens tidsgrænse fra 1.800 til 3.900 sekunder. For payments-pipeline-fix steg verifikatorens udtrykkeligt angivne værdier fra 6 CPU'er og 12.288 MB til 8 CPU'er og 16.384 MB. Det er angivne værdier. Udgivelsesnoterne til 4.1 siger, at alle 66 opgaver blev ændret. Den afgrænsede konfigurationskontrol viser ikke, om instruktioner, images og verifikatorer er ens.
Download compare-versions.py og census.json til samme mappe. Brug Python 3.11 eller nyere og internetadgang, og kør python3 compare-versions.py > comparison.json fra mappen. Scriptet henter kilderegistret for version 4.0 på den faste revision samt opgavemetadata uden at udføre opgaver. Rapporten bevarer kildeangivelsen og projektets anmodning om at holde benchmarkdata ude af træningskorpusser.
Hvad du bør gemme, når evalueringens konfiguration ændres
Gennemgangen giver grundlag for en kort konfigurationslog.
- Fastlås opgavesættet. Gem udgivelsesmanifestet, kilderevisionen og opgavestierne samlet. Filantallet i hele kodearkivet kan omfatte materiale uden for udgivelsen.
- Bevar de oprindelige deklarationer. Registrer udtrykkelige værdier og udeladelser, herunder særskilte verifikatorindstillinger og tidsgrænser for hver fase.
- Dokumenter kørselsprogrammet og dets indstillinger. Gem den præcise version eller revision og de valg, der erstatter eller skalerer opgaveindstillingerne.
- Kontrollér reglerne i det bagvedliggende system. Find ud af, hvilke felter systemet omsætter til grænser, reservationer, standardværdier eller anmodninger, det ikke understøtter.
- Registrer den faktiske tildeling, når den kan observeres. Hold den adskilt fra den ønskede konfiguration og det målte forbrug under kørslen.
Hvis du bevidst ændrer en grænse eller en tildeling, skal du dokumentere det sammen med resultatet. Det hjælper senere læsere med at forstå betingelserne og tage højde for forskelle mellem miljøer.
Med konfigurationssammenligningen og analysekoden kan du undersøge undtagelserne. sapien1 gennemgår opgaver og miljøer på denne måde, når virksomheden afgrænser et projekt om evaluering af agenter.
Download ressourcefilteret og gennemgangens data til den samme mappe for at sammenligne andre grænser. python3 filter-census.py --cpus 4 --memory-mb 8192 --status within viser for eksempel opgaver, hvor de angivne værdier er inden for grænserne både i opgavemiljøet og i verifikatorens miljø. Uddata bevarer udeladelserne og afgør ikke, om en opgave kan køres. Terminal-Bench beder om, at benchmarkdata holdes ude af træningskorpusser.
Sammenlign de opgaver, der vælges under hvert sæt grænser
Hvert af de to eksempler på ressourcegrænser vælger 44 af de 66 opgaver i Terminal-Bench v4.1.0. Listerne har 36 opgaver til fælles, og hver liste har 8 opgaver, der kun findes på den liste. For hvert sæt grænser tjekker filtret de angivne værdier for CPU'er, hukommelse og lager særskilt i opgavemiljøet og i verifikationsmiljøet.
| CPU'er | Hukommelse (MB) | Lager (MB) | Opgaver inden for alle tre grænser |
|---|---|---|---|
| 4 | 8.192 | 10.240 | 44 |
| 2 | 16.384 | 20.480 | 44 |
Kør begge kommandoer fra den mappe, der indeholder filteret og optællingen. I hver rapport viser task-felterne i records, hvilke opgave-id'er der er valgt.
python3 filter-census.py --cpus 4 --memory-mb 8192 \
  --storage-mb 10240 --phases both --status within > ceiling-4cpu.json

python3 filter-census.py --cpus 2 --memory-mb 16384 \
  --storage-mb 20480 --phases both --status within > ceiling-2cpu.json
Gem de nøjagtige opgave-id'er sammen med benchmarkversionen og ressourceindstillingerne, når du rapporterer en score. Hvis du sammenligner to kørsler på de opgaver, de har til fælles, skal du beregne begge scorer ud fra den samme liste.
Metode og afgrænsning
Vi afsluttede 17. november 2026 en gennemgang af alle konfigurationsdeklarationer i én udgivelse. Arbejdet beskriver deklarationerne og måler ingen ydeevne. Terminal-Bench-datasættets kilderevision er 4070d6c. Vi gennemgik Harbor på revision ec6aeab, identificeret som version 0.26.0 i projektets metadata. Metoden indeholder de fulde hashværdier, kildelinks, udtræksregler og kommandoer til at gentage gennemgangen.
Indsamlingsscriptet læser det officielle manifest og 66 TOML-filer med i alt 85.966 byte kildedata. Det holder versionsfelterne adskilt og kontrollerer, om der er ældre ressourcealiaser, trin eller ekstra miljøblokke. Det fandt ingen trin eller ældre ressourcealiaser i udgivelsen. De offentlige downloads indeholder udvalgte konfigurationsoplysninger og hashværdier for kilderne. Opgaveinstruktioner, løsninger og fulde miljøer indgår ikke.
Vi kontrollerede uafhængigt, hvilke opgaver manifestet omfattede, beregningerne og eksempler fra kildedataene. Eksemplerne omfattede en afvigende værdi, et udeladt GPU-felt og en udtrykkeligt angivet verifikatorblok. Vi kørte ingen modeller, containere eller benchmarkopgaver.