Forskning
Det skal du forberede, før din virksomhed licenserer sine data
Sprog: Dansk
En god første henvendelse forklarer, hvem der har kontrol over dataene, hvad de indeholder, og hvordan de kan vurderes. En mindre gennemgang af ti offentligt beskrevne programmer for dataleverandører viste forskellige indgange: en interesseformular, en konto, en anmodning om en produktlistning, en mødeanmodning eller et estimat. Otte programmer havde læsbar information om forberedelse. Deres offentliggjorte processer viser, hvorfor de oplysninger, der skal til for at indlede en samtale, kan være forskellige fra dem, der kræves til en vurdering eller produktlistning.
For en virksomhed, der overvejer sit første datapartnerskab, er det praktiske resultat et kort forberedelsesnotat. Beskriv virksomheden og dens beslutningstagere, datasættet og dets historik samt de tilladelser og begrænsninger, der skal afklares. Tilføj detaljer, efterhånden som udbyderens gennemgang skrider frem.
Den første formular viser, hvor samtalen begynder
Den første offentlige handling kan se enkel ud, selv om udbyderen beskriver en mere detaljeret gennemgang senere i forløbet.
Neudatas side om produktlistning beskriver en indledende anmodning med virksomheds- og kontaktoplysninger. En analytiker skal godkende anmodningen, før produktlistningen oprettes, og i den offentliggjorte proces følger et due diligence-spørgeskema eller et risikotjek efter godkendelsen. Den, der kun forbereder sig på den første formular, vil overse den efterfølgende produktbeskrivelse og due diligence. Neudatas proces for produktlistning
Defined.ai's offentliggjorte proces begynder med oprettelsen af en Jira-konto. Senere trin omfatter kommercielle muligheder, datakvalitet, volumen, organisering, metadata, licensrettigheder og compliance. Kontotrinnet giver derfor i sig selv kun lidt information om det materiale, som en datapartner bør være klar til at drøfte. Defined.ai's partnerskabsprogram
Andre programmer stiller spørgsmål om datasættet i den offentlige formular. OpenAI spørger om datatype, anslået størrelse med enheder, format, rettigheder til at dele dataene og behov for hjælp til at forberede dem. Shutterstock spørger om, hvilken type indhold man har kontrol over, og hvor stort biblioteket er. OpenAI's interesseformular, Shutterstocks Data Partner Network
Forskellen har betydning for forberedelsen. Brug den indledende formular til at finde ud af, hvad næste handling er, og læs derefter udbyderens beskrivelse af vurdering og onboarding. En kontaktanmodning, en godkendt produktlistning og en aftalt licens er forskellige resultater.
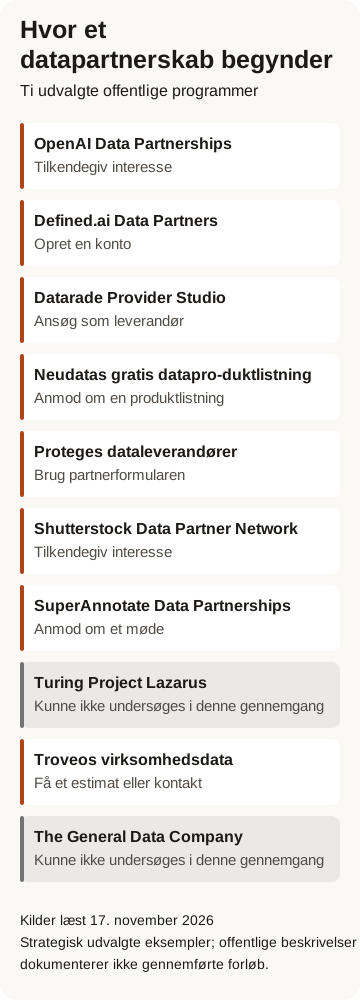
Offentlige indgange læst 17. november 2026. Oversigten over de undersøgte programmer knytter hver observation til dens kilde.
Beskriv datasættet med de enheder, der forklarer det
”Vi har flere terabyte” efterlader vigtige spørgsmål ubesvarede. En beskrivelse bør gøre det muligt for modtageren at forstå, hvad disse bytes repræsenterer, og om dataposterne har en brugbar kontekst.
Den undersøgte OpenAI-formular beder udtrykkeligt om enheder for den anslåede størrelse og giver ord og timer som eksempler. Shutterstocks felt til bibliotekets størrelse passer til en indholdssamling. Det er forskellige måder at beskrive omfang på, så ét tal for lagerstørrelse vil næppe være tilstrækkeligt til alle henvendelser. OpenAI's formular, Shutterstocks formular
Driftsdata kræver en anden type beskrivelse. Troveos side om virksomhedsdata omtaler systemer, teamstørrelse og driftshistorik og beskriver sammenhænge i samtaler, dokumentmetadata og projekthistorik. SuperAnnotates eksempler omfatter kommunikation, procesdokumenter, beslutninger, domænespecifikke data og dokumenteret arbejde. Begge sider gør det arbejde, som dataposterne repræsenterer, til en del af beskrivelsen. Troveos side om virksomhedsdata, SuperAnnotates datapartnerskaber
Notér indholdstype, omtrentligt omfang, datoperiode og kildesystemer i det første notat. Tilføj den kontekst, der gør dataposterne forståelige: om beskeder stadig indgår i deres samtaletråde, om dokumenter har versionshistorik, eller om et datasæt indeholder en feltordbog. Neudatas offentlige vejledning anbefaler specifikt understøttende materiale som dataordbøger til at forklare et dataprodukt. Neudatas leverandørvejledning
Her er et fiktivt eksempel på en nyttig beskrivelse:
Et arkiv med vedligeholdelsesdata for udstyr over tre år med cirka 80.000 arbejdsordrer. Hver post forbinder en indberettet fejl, inspektionsnoter, den udførte reparation og afslutningsstatus. Arkivet kan eksporteres som strukturerede tabeller med en feltordbog. Bilag og identificerende felter er endnu ikke gennemgået med henblik på inklusion.
Skeln mellem kontrol over filerne og tilladelse til at licensere dem
Forbered en klar redegørelse for, hvor dataposterne kommer fra, og hvem der kan godkende den foreslåede brug. Gør uafklarede tilladelser synlige, så de kan indgå i samtalen.
OpenAI's interesseformular spørger, om ansøgeren har rettigheder til at dele dataene. Datarades leverandørside beskriver kommercialiseringsrettigheder og begrænsninger for persondata som forhold, der har betydning for, om en leverandør kan komme i betragtning. Defined.ai beskriver kontrol af licensrettigheder og compliance som en del af sin vurdering. Det er offentlige krav eller spørgsmål fra disse programmer; en besvaret formular fastslår ikke, at et datasæt er juridisk afklaret. OpenAI's formular, Datarades leverandørkrav, Defined.ai's vurderingsproces
Dit forberedelsesnotat kan identificere den foreslåede licensgiver, hvordan dataene blev skabt eller indhentet, relevante aftaler og begrænsninger, som teamet allerede kender. Det kan også identificere, hvem der skal afklare de resterende spørgsmål. Hold denne beskrivelse adskilt fra en påstand om, at alle rettigheder er verificeret.
Omfanget er også vigtigt her. Den tiltænkte datapakke kan omfatte én tidsperiode, ét system eller én samling frem for alt, hvad organisationen råder over. En beskrivelse af de foreslåede afgrænsninger gør den næste samtale mere konkret. Den hjælper også med at skelne mellem en repræsentativ stikprøve og en fuld overførsel.
Brug et kort notat, og tilføj derefter den ønskede dokumentation
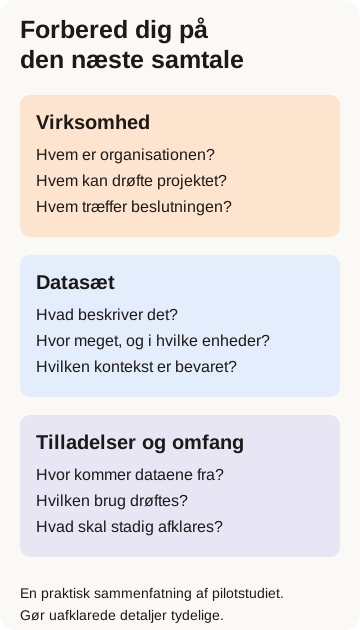
Arbejdsarket samler de observerede spørgsmål i tre praktiske afsnit. Denne inddeling er vores sammenfatning af pilotstudiet.
| Afsnit | Det skal du forberede |
|---|---|
| Virksomhed og beslutningstagere | Organisation, domæne, relevant driftshistorik, kontaktperson og ansvarlig for det foreslåede partnerskab |
| Datasæt og forberedelse | Indholdstyper, omtrentlige mængder med enheder, datoperiode, systemer, formater, tilgængelige metadata og arbejde, der kræves til vurdering |
| Tilladelser og omfang | Dataenes oprindelse, foreslået licensgiver, kendte begrænsninger, tilladte anvendelser, der skal drøftes, og uafklarede spørgsmål om godkendelse |
Brug ”ukendt”, hvor en oplysning er uafklaret. Et estimat bør indeholde sin enhed og forklare, hvordan det er udarbejdet. En erklæring om rettigheder bør angive sit grundlag frem for at betragte besiddelse af filerne som bevis.
For eksempel er ”cirka 4.000 timer, anslået ud fra mediebibliotekets indeks” mere nyttigt end ”stort videoarkiv”. ”Vores team skal gennemgå bidragyderaftalerne for denne brug” er mere nyttigt end en udokumenteret erklæring om, at hele arkivet er afklaret.
Det næste skridt afhænger af programmet. SuperAnnotate beskriver en indledende samtale om projektets omfang efterfulgt af en vurdering af en stikprøve; Datarade beskriver en gennemgang af ansøgningen før oprettelse af en profil og offentliggørelse af produkter. Spørg, hvad den næste vurdering kræver, og brug den aftalte proces for det materiale, du stiller til rådighed. SuperAnnotates beskrevne proces, Datarades ansøgningsproces
Download arbejdsarket til forberedelse. Med observationerne og analysescriptet kan læserne undersøge koblingen til kilderne og reproducere pilotstudiets optællinger.
Sådan gennemførte vi pilotstudiet
Vi udvalgte ti programmer for at dække forskellige former for offentlig modtagelse af henvendelser: OpenAI, Defined.ai, Datarade, Neudata, Protege, Shutterstock, SuperAnnotate, Turing Lazarus, Troveo og The General Data Company. Det var et bevidst udvalg af forskellige eksempler, ikke en tilfældig eller udtømmende stikprøve af datakøbere.
Den 17. november 2026 læste vi officielle engelsksprogede programsider og relevante offentlige forklaringer ved hjælp af webekstraktion. Otte indeholdt væsentlig information om forberedelse eller indledende trin. Indholdet på Turing Lazarus' programside og The General Data Companys indgang til partnerskaber kunne ikke læses med den metode. De står fortsat som ukendte i datasættet. Proteges indlejrede formular og Neudatas linkede formular kunne heller ikke læses, selv om deres offentlige sider beskrev indgangene.
Vi indtastede ikke personoplysninger, oprettede ikke konti, indsendte ikke ansøgninger, uploadede ikke data og testede ikke validering af formularfelter. Offentlige udsagn beskriver, hvad udbyderne oplyser; de dokumenterer ikke gennemførte vurderinger, accept, transaktionspriser eller resultater for kunder. Søgeresultater kan bygge på indekserede kopier, og sider kan ændre sig. Den fulde metodebeskrivelse og oversigten over de undersøgte programmer angiver undersøgelsens omfang og hver enkelt adgangsbegrænsning.
Hvis du har brug for hjælp til at afgrænse et muligt dataprojekt, kan du læse om at levere data til sapien1.