Forskning
En screening af referencefiler ændrer opgavesammensætningen i GDPvals offentlige datasæt
Sprog: Dansk
En benchmarkscore er lettere at fortolke, når du ved, hvilke opgaver der kan indgå i den. I GDPvals offentlige gold-opgavetabel starter hver af de 44 erhvervsgrupper med fem opgaver. Men en sammenligning, der kræver en angivet ekspertreferencefil, kan ikke bruge alle rækker i tabellen på samme måde: 35 af 220 rækker har en tom deliverable_files-liste.
Dette antal er allerede dokumenteret i gbench-implementeringen af GDPval. Vi har optalt, hvordan de tomme lister fordeler sig på sektorer og erhvervsgrupper i det samme fastlåste øjebliksbillede af GDPval. Alle 44 erhvervsgrupper har stadig mindst én række med en angivet fil. Men den resterende sammensætning er ikke lige så jævnt fordelt som udgangstabellen.
Hvilke opgaver angiver en referencefil fra en ekspert?
Disse optællinger viser kun, om tabellen angiver mindst én sti til en ekspertleverance. En angivet sti er ikke bevis for, at filen er tilgængelig eller kan gengives. En tom liste fastslår ikke, om der findes en reference et andet sted uden for denne tabel.
| Sektor | Rækker i den offentlige gold-tabel | Med en angivet leverance | Med en tom liste |
|---|---|---|---|
| Finans og forsikring | 25 | 17 | 8 |
| Offentlig forvaltning | 25 | 22 | 3 |
| Sundhed og social bistand | 25 | 22 | 3 |
| Information | 25 | 14 | 11 |
| Fremstilling | 25 | 25 | 0 |
| Liberale, videnskabelige og tekniske tjenesteydelser | 25 | 24 | 1 |
| Fast ejendom, udlejning og leasing | 25 | 20 | 5 |
| Detailhandel | 20 | 16 | 4 |
| Engroshandel | 25 | 25 | 0 |
| I alt | 220 | 185 | 35 |
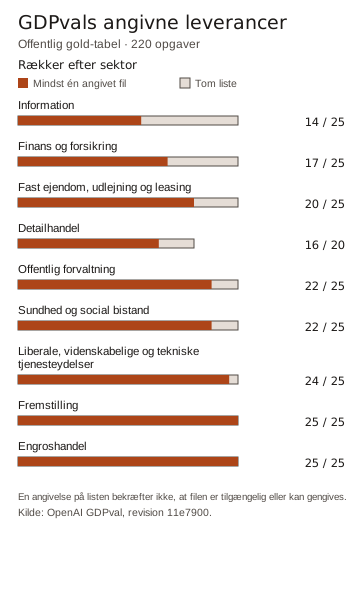
Søjlerne viser angivelser på listen, ikke bekræftet filadgang eller mulighed for gengivelse.
Tabellen indeholder 44 erhvervs- og sektorgrupper med fem opgaver i hver. Af dem beholder 22 alle fem rækker efter denne screening, mens 22 beholder mellem to og fire. Alle erhvervsgrupper er stadig repræsenteret, men det betyder ikke længere i sig selv, at de hver har samme antal opgaver.
Forskellen mellem sektorerne er nyttig at have med, når man læser et samlet resultat. Information og fremstilling tegner sig hver for 25 af de oprindelige 220 rækker, svarende til 11,4 %. I en hypotetisk samlet opgørelse, hvor netop de 185 rækker med en angivelse på listen vægtes ens pr. opgave, ville information tegne sig for 14/185, svarende til 7,6 %, og fremstilling for 25/185, svarende til 13,5 %. Det er andele af opgaver, ikke modelscores eller skøn over værdien af forskellige erhverv.
Kan bedømmeren læse referencefilerne?
Beregningen med 185 rækker er ikke gbenchs endelige nævner ved scoring. Dokumentationen beskriver yderligere fire opgaver, hvis angivne leverancer ikke kan gengives som tekst. Det efterlader 181 opgaver med referencer, der kan gengives, i det pågældende øjebliksbillede. Vi har ikke selv gengivet filerne eller kørt gbench.
Selv uden at vide, hvilke sektorer de fire opgaver tilhører, sætter tallene nyttige grænser for det dokumenterede sæt med referencer, der kan gengives. Hvis der er tale om fire forskellige rækker blandt de 185 med en angivelse på listen, er der mindst 21 rækker fra fremstilling og højst 14 fra information tilbage. Med ens vægt pr. opgave er disse grænser henholdsvis 21/181 (11,6 %) og 14/181 (7,7 %). En faktisk kørsel kan have en anden nævner for de scorede opgaver, fordi fejl under generering, fejl hos dommeren og antallet af forsøg pr. opgave også har betydning. Disse tal beskriver ikke OpenAI’s oprindelige resultater med menneskelig bedømmelse.
Andre bedømmelsesmetoder har andre krav. I NeMo Gyms dokumenterede rubric-tilstand ved commit 5d6429f bedømmer en LLM-dommer en kandidatleverance ud fra opgavens rubric. Koden til klargøring kopierer ikke deliverable_files-listen med ekspertoutput, mens rubric-verifikatoren rapporterer missing_rubric, hvis begge rubric-felter er tomme. Eventuelle angivne inputfiler til opgaven skal gøres tilgængelige, og der er stadig brug for et kandidatoutput og en dommer. Klargøringskaldet fastlåser ikke en revision af datasættet. Vi har ikke kørt NeMo Gym eller målt dækningen. Dets rubric-score og gbenchs andel af sejre eller uafgjorte resultater er forskellige mål.
Hvad dommeren kan se
Tilgængeligheden af referencer er kun én del af sammenligningen. gbench-dokumentationen oplyser allerede, at 32 af de 220 rubrics overskrider standardgrænsen på 8.000 tegn. Formateringsfunktionen bevarer hele kriterier i deres oprindelige rækkefølge, indtil det næste ville overskride grænsen, og tilføjer derefter en markering for afkortning. Hvis det første kriterium alene overskrider grænsen, vises kun en del af det. Antal tegn er ikke det samme som antal tokens.
Vi anvendte den fastlåste formateringsfunktion på opgavetabellen. Blandt de 185 rækker med en angivet ekspertleverance ville 26 rubrics blive afkortet ved standardgrænsen, så i alt 247 hele kriterier udelades fra disse rækker. En angivet leverance kan ikke nødvendigvis gengives, og mislykkede eller tomme genereringer kan forhindre et kald til dommeren. Tallene er derfor ikke antal bedømte sammenligninger. Som illustration ville en ændring alene af formateringsfunktionens grænse til 12.000 eller 16.000 tegn medføre afkortning af henholdsvis to eller nul af de 185 rubrics. Vi har ikke kørt disse indstillinger gennem en evaluator eller dommer. Antallet af udeladte kriterier fastslår hverken deres betydning eller, om en afgørelse ville ændre sig. En højere grænse kan give mindre plads til resten af et fast kontekstvindue. Undersøg de oplysninger om afkortning, som den faktiske kørsel registrerer, sammen med dens reference- og scoringstal.
Rubric-screeningen genskaber disse optællinger med DuckDB 1.4.4. Den downloader midlertidigt den komplette fastlåste opgavetabel og behandler rubric-tekst i hukommelsen. Dens output gemmer kun samlede tal, ikke opgave-id’er eller rubric-tekst. Den fjerner den midlertidige tabel efter en normal kørsel. Den udfører kun den inspicerede og hash-verificerede formateringsfunktion fra gbench i et begrænset navnerum, som ikke er en sikkerhedssandkasse. Arkivet indeholder licensen og meddelelsen fra det oprindelige projekt. Efter opsætningen af DuckDB nedenfor kan du bruge Python 3.11 til at oprette miljøet, downloade arkivet og køre det på macOS eller Linux:
unzip rubric-screen.zip -d rubric-screen
.gdpval-venv/bin/python rubric-screen/rubric-screen.py > rubric-observations.json
Registrer vejen fra opgaver til scores
Når du opsætter eller sammenligner en evaluering, skal du registrere datasættets revision, den krævede referencetype og hver regel for, om en opgave kan indgå. Rapportér antal pr. gruppe i udgangstabellen, efter referencekontrol og efter scoring. Hold årsagerne til en manglende angivet reference, en ulæselig reference, en mislykket generering og en ubrugelig dommerafgørelse adskilt. Et enkelt samlet resultat kan ellers skjule, hvilke opgaver der ikke længere bidrog.
Angiv også, hvordan de resterende opgaver og forsøg vægtes. Ens vægt pr. opgave, ens vægt pr. erhvervsgruppe og ens vægt pr. forsøg besvarer forskellige spørgsmål, når antallene er forskellige. Ingen af dem afhjælper i sig selv manglende evidens. Den passende opgørelse afhænger af, hvad evalueringen skal måle.
For et opgavesæt, som du selv designer, viser vejledningen til evaluering af agenter, hvordan du definerer observerbare kontroller og fortolker gentagne forsøg.
Notér den præcise version af hver inputfil
En fastlåst opgavetabel fastlåser ikke nødvendigvis hver fil, som en evaluator downloader. I en tidligere offentlig GDPval-tabel ved revision 4bf6426 angiver 122 af 220 opgaverækker inputfiler. Alle 262 angivne input-URL’er peger på repositoriets skiftende main-gren. Udbyderens metadata viser, at 62 af de samme stier havde andre størrelser og blob-id’er ved revision 11e7900. Disse 62 stier optræder i 20 af rækkerne i den tidligere tabel. Det er opgaveinput, som er adskilt fra de ekspertreferenceoutput i deliverable_files, der er optalt ovenfor.
Dette viser ikke, at en bestemt evaluering brugte et ændret input, at en fil er beskadiget, eller at en score ændrede sig. Det viser, hvorfor de skiftende URL’er i en gemt tabel senere kan føre til en anden version af et input. Vi har ikke analyseret indholdet af inputfilerne.
Ved Inspect Evals-commit 5c092d5 fastlåser GDPval-indlæseren sin opgavetabel til revision a3848a2. Den tabel er byteidentisk med den tidligere tabel ovenfor, og udbyderens metadata for inputfilerne stemmer også overens. Indlæseren omsætter parrede tabel-URL’er til filtilknytninger for eksempler. Inspects dokumentation siger, at disse tilknytninger kan bruge URL’er. Denne kildevej kan derfor medføre skiftende URL’er sammen med en fastlåst tabel. Vi har ikke testet Inspects download eller cachelagring af filer eller fastslået, hvad en bestemt kørsel brugte.
En evaluator kan i stedet slå stier relativt til datasættet op ved samme uforanderlige revision som tabellen. Den gbench-implementering, der er undersøgt her, angiver eksplicit sin fastlåste revision ved hentning af vedhæftede filer. Registrer revisionen, og verificer, hvor det er praktisk muligt, de filer, der faktisk blev brugt. Hugging Faces downloaddokumentation forklarer, hvordan en skiftende revision kan slås op som et commit for at sikre ensartede downloads.
Analysescriptet for input-URL’er genskaber optællingerne med DuckDB 1.4.4. Det downloader midlertidigt den tidligere opgavetabel, fjerner den efter en normal kørsel og gemmer ingen opgavetekst, individuelle id’er, inputstier eller inputindhold i sit output. Et valgfrit flag kontrollerer svarheadere for én sti og den aktuelle main-revision. Resultatet kan ændre sig, når main ændrer sig. Til denne kontrol sender scriptet kun HEAD-anmodninger, også gennem omdirigeringer, og utilgængelige resultater forbliver uobserverede. Kontrollerne med Pythons standardbibliotek sammenligner tabellen og metadataene, som Inspect har fastlåst, og inspicerer den fastlåste indlæserkilde uden at køre den. Kontrollen af tabellens hash læser hele tabellen ind i hukommelsen, men analyserer eller gemmer ikke opgaveindholdet. Scriptene anmoder ikke om selve inputfilernes indhold.
Efter opsætningen af DuckDB nedenfor kan du køre kontrollerne på macOS eller Linux med:
.gdpval-venv/bin/python input-url-revisions.py > input-url-observations.json
.gdpval-venv/bin/python inspect-dataset-check.py
.gdpval-venv/bin/python inspect-source-check.py
Sådan talte vi
Til optællingen af tilgængelige referencer inspicerede vi Parquet-tabellen train ved GDPval-revision 11e7900cdcac61bc4daf59e65feb238acda98fbf, verificerede 220 forskellige opgave-id’er og grupperede kun efter sektor, erhvervsgruppe og længden af hver deliverable_files-liste. Analysescriptet kontrollerer kildens hash og genskaber optællingerne med DuckDB 1.4.4. Det downloader midlertidigt hele tabellen og fjerner den efter en normal kørsel. Dets output gemmer ingen prompts, rubrics, individuelle opgave-id’er, leverancestier eller leverancer. Vi kørte ingen model, benchmark eller funktion til gengivelse af referencer.
For at genskabe resultatet lokalt med Python 3.9 eller nyere på macOS eller Linux skal du sikre, at python3 vælger den version:
python3 -m venv .gdpval-venv
.gdpval-venv/bin/python -m pip install duckdb==1.4.4
.gdpval-venv/bin/python analyze.py > observations.json
sapien1 stiller disse scripts til rådighed til download og lokal kørsel. Der er ikke angivet nogen yderligere licens til at ændre eller videredistribuere dem. Kildedatasættets vilkår er særskilte.
OpenAI beskriver gold-delmængden med 220 opgaver som udgivet som open source. Det fastlåste datasætkort indeholder en benchmark-canary og intet licensfelt. Undersøg de vilkår, der gælder for din egen brug, frem for at udlede dem af en mærkat på kortet eller af denne optælling. Sektor- og erhvervsbetegnelserne samt benchmarket er fortsat krediteret deres kilde.