Investigación
Un filtro de archivos de referencia cambia la composición de tareas públicas de GDPval
Idioma: Español
Una puntuación de benchmark es más fácil de interpretar cuando sabes qué tareas pueden incluirse en ella. En la tabla pública de tareas gold de GDPval, cada una de las 44 ocupaciones comienza con cinco tareas. Pero una comparación que exige un archivo de referencia experto enumerado no puede usar todas las filas de esa tabla de la misma manera: 35 de las 220 filas tienen una lista deliverable_files vacía.
Ese total ya está documentado en la implementación de GDPval de gbench. Contamos cómo se distribuyen esas listas vacías entre sectores y ocupaciones en la misma instantánea fijada de GDPval. Las 44 ocupaciones siguen teniendo al menos una fila con un archivo enumerado. Pero la composición restante no está distribuida de forma tan uniforme como la tabla inicial.
¿Qué tareas tienen un archivo de referencia de un experto en la lista?
Estos recuentos solo indican si la tabla enumera al menos una ruta de entregable experto. Una ruta enumerada no demuestra que se pueda acceder al archivo ni renderizarlo. Una lista vacía no permite determinar si existe una referencia fuera de esta tabla.
| Sector | Filas en la tabla gold pública | Con un entregable enumerado | Con una lista vacía |
|---|---|---|---|
| Finanzas y seguros | 25 | 17 | 8 |
| Gobierno | 25 | 22 | 3 |
| Salud y asistencia social | 25 | 22 | 3 |
| Información | 25 | 14 | 11 |
| Manufactura | 25 | 25 | 0 |
| Servicios profesionales, científicos y técnicos | 25 | 24 | 1 |
| Bienes raíces, alquiler y arrendamiento | 25 | 20 | 5 |
| Comercio minorista | 20 | 16 | 4 |
| Comercio mayorista | 25 | 25 | 0 |
| Total | 220 | 185 | 35 |
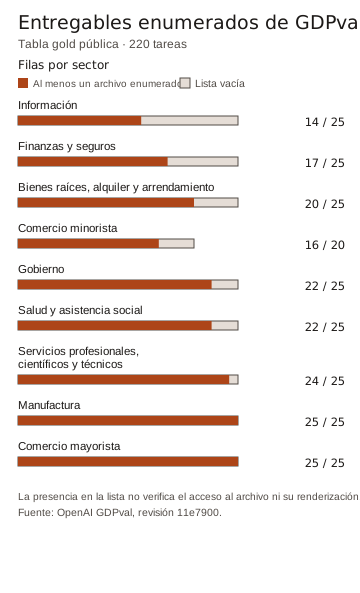
Las barras muestran la presencia en la lista, no la verificación del acceso al archivo ni de su renderización.
La tabla contiene 44 grupos de ocupación y sector de cinco tareas cada uno. De ellos, 22 conservan las cinco filas tras este filtro y 22 conservan entre dos y cuatro. Todas las ocupaciones siguen presentes, pero su presencia por sí sola ya no significa que cada una tenga el mismo número de tareas.
El contraste entre sectores es útil al interpretar un resultado agregado. Información y Manufactura representan cada uno 25 de las 220 filas originales, es decir, un 11,4 %. En un resumen hipotético que ponderara por igual exactamente las 185 tareas con presencia en la lista, Información representaría 14/185, o un 7,6 %, y Manufactura 25/185, o un 13,5 %. Son proporciones de tareas, no puntuaciones de modelos ni estimaciones del valor de distintas ocupaciones.
¿Puede el evaluador leer los archivos de referencia?
El cálculo de 185 filas no es el denominador final de puntuación de gbench. Su documentación describe otras cuatro tareas cuyos entregables enumerados no se renderizan como texto, lo que deja 181 tareas con referencias renderizables en esa instantánea. No renderizamos esos archivos de forma independiente ni ejecutamos gbench.
Incluso sin saber a qué sectores pertenecen esas cuatro tareas, los recuentos permiten establecer un límite útil para el conjunto documentado de referencias renderizables. Si son cuatro filas distintas de las 185 con presencia en la lista, quedan al menos 21 filas de Manufactura y como máximo 14 de Información. Con igual ponderación por tarea, esos límites son 21/181 (11,6 %) y 14/181 (7,7 %), respectivamente. Una ejecución real puede tener un denominador de puntuación diferente, ya que también influyen los fallos de generación, los fallos del juez y el número de intentos por tarea. Estos recuentos no describen los resultados originales de OpenAI evaluados por personas.
Otros métodos de evaluación tienen requisitos diferentes. En el modo de rúbrica documentado de NeMo Gym en el commit 5d6429f, un LLM que actúa como juez califica un entregable candidato según la rúbrica de la tarea. Su código de preparación no copia la lista deliverable_files de resultados expertos, mientras que su verificador de rúbrica informa de missing_rubric si ambos campos de la rúbrica están vacíos. Los archivos de entrada de la tarea que estén enumerados deben prepararse, y siguen siendo necesarios un resultado candidato y un juez; la llamada de preparación no fija una revisión del conjunto de datos. No ejecutamos NeMo Gym ni medimos su cobertura. Su puntuación de rúbrica y la tasa de victorias o empates de gbench son medidas diferentes.
Lo que puede ver el juez
La disponibilidad de referencias es solo una parte de la comparación. La documentación de gbench ya señala que 32 de las 220 rúbricas superan su límite predeterminado de 8.000 caracteres. Su formateador conserva los criterios completos en su orden original hasta que el siguiente superaría el límite y, entonces, añade un marcador de truncamiento; si el primer criterio por sí solo supera el límite, muestra solo una parte de ese criterio. Los recuentos de caracteres no son recuentos de tokens.
Aplicamos ese formateador fijado a la tabla de tareas. Entre las 185 filas con un entregable experto enumerado, 26 rúbricas se recortarían con el límite predeterminado, lo que dejaría fuera 247 criterios completos en esas filas. Un entregable enumerado no es necesariamente renderizable, y las generaciones fallidas o vacías pueden impedir una llamada al juez, por lo que estos no son recuentos de comparaciones evaluadas. A modo de ejemplo, cambiar únicamente el límite del formateador a 12.000 o 16.000 caracteres recortaría dos o ninguna de esas 185 rúbricas, respectivamente. No ejecutamos esas configuraciones en un evaluador ni en un juez. Los recuentos de criterios omitidos no determinan su importancia ni si cambiaría un veredicto; un límite mayor puede dejar menos espacio para el resto de una ventana de contexto fija. Inspecciona la información de recorte registrada por la ejecución real junto con sus recuentos de referencias y puntuaciones.
El filtro de rúbricas reproduce estos recuentos con DuckDB 1.4.4. Descarga temporalmente la tabla completa de tareas fijada y procesa el texto de las rúbricas en memoria; su salida conserva recuentos agregados, no identificadores de tareas ni texto de rúbricas. Elimina la tabla temporal después de una ejecución normal. Solo ejecuta el formateador de gbench inspeccionado y verificado mediante hash en un espacio de nombres restringido, que no es un entorno aislado de seguridad. El archivo incluye la licencia y el aviso del proyecto original. Después de configurar DuckDB como se indica a continuación, usa Python 3.11 para crear el entorno, descargar el archivo y ejecutarlo en macOS o Linux:
unzip rubric-screen.zip -d rubric-screen
.gdpval-venv/bin/python rubric-screen/rubric-screen.py > rubric-observations.json
Registra el recorrido de las tareas hasta las puntuaciones
Al configurar o comparar una evaluación, registra la revisión del conjunto de datos, el tipo de referencia requerido y cada regla de elegibilidad. Informa los recuentos por grupo en la tabla inicial, después de las comprobaciones de referencias y después de la puntuación. Distingue los motivos: referencia no enumerada, referencia ilegible, generación fallida y veredicto del juez inutilizable. De lo contrario, un solo resultado agregado puede ocultar qué tareas dejaron de contribuir.
Indica también cómo se ponderan las tareas y los intentos restantes. La ponderación igual por tarea, por ocupación o por intento responde a preguntas diferentes cuando los recuentos varían. Ninguna subsana por sí sola la falta de evidencia; el resumen adecuado depende de lo que la evaluación pretende medir.
Para un conjunto de tareas que estés diseñando, la guía de evaluación de agentes muestra cómo definir comprobaciones observables e interpretar pruebas repetidas.
Anota la versión exacta de cada archivo de entrada
Una tabla de tareas fijada no implica necesariamente que también esté fijado cada archivo que descarga un evaluador. En una tabla pública anterior de GDPval, en la revisión 4bf6426, 122 de las 220 filas de tareas enumeran archivos de entrada. Las 262 URL de entrada enumeradas apuntan a la rama main del repositorio, que puede cambiar. Los metadatos del proveedor indican que 62 de esas mismas rutas tenían tamaños e identificadores de blob diferentes en la revisión 11e7900; esas 62 rutas aparecen en 20 filas de la tabla anterior. Se trata de entradas de tareas, distintas de los resultados de referencia expertos en deliverable_files contados anteriormente.
Esto no demuestra que una evaluación concreta usara una entrada modificada, que un archivo esté dañado ni que una puntuación haya cambiado. Sí muestra por qué seguir más adelante las URL cambiantes de una tabla guardada puede seleccionar una versión diferente de una entrada. No analizamos el contenido de los archivos de entrada.
En el commit 5c092d5 de Inspect Evals, el cargador de GDPval fija su tabla de tareas a la revisión a3848a2. Esa tabla es idéntica byte por byte a la tabla anterior, y los metadatos de los archivos de entrada del proveedor también coinciden. El cargador asigna las URL emparejadas de la tabla a asignaciones de archivos de muestra; la documentación de Inspect indica que esas asignaciones pueden usar URL. Por tanto, esta ruta de código puede incluir URL cambiantes junto a una tabla fija. No probamos las descargas de archivos ni la caché de Inspect, ni determinamos qué se usó en alguna ejecución.
En cambio, un evaluador puede resolver las rutas relativas al conjunto de datos en la misma revisión inmutable que su tabla. La implementación de gbench inspeccionada aquí proporciona explícitamente su revisión fijada al obtener los archivos adjuntos. Registra la revisión y, cuando sea posible, verifica los archivos realmente usados. La documentación de descarga de Hugging Face explica cómo resolver una revisión cambiante a un commit para obtener descargas coherentes.
El script de análisis de URL de entrada reproduce los recuentos con DuckDB 1.4.4. Descarga temporalmente la tabla de tareas anterior, la elimina después de una ejecución normal y no conserva en su salida texto de tareas, identificadores individuales, rutas de entrada ni contenido de entrada. Una opción permite comprobar las cabeceras de respuesta de una ruta y la revisión actual de main; su resultado puede cambiar a medida que cambia main. Para esa comprobación, el script envía únicamente solicitudes HEAD, incluso a través de redirecciones, y deja sin observar los resultados no disponibles. Las comprobaciones con la biblioteca estándar de Python comparan la tabla y los metadatos fijados por Inspect e inspeccionan el código fuente del cargador fijado sin ejecutarlo. La comprobación del hash de la tabla lee la tabla completa en memoria, pero no analiza ni conserva el contenido de sus tareas. Los scripts no solicitan los cuerpos de los archivos de entrada.
Después de configurar DuckDB como se indica a continuación, ejecuta las comprobaciones en macOS o Linux con:
.gdpval-venv/bin/python input-url-revisions.py > input-url-observations.json
.gdpval-venv/bin/python inspect-dataset-check.py
.gdpval-venv/bin/python inspect-source-check.py
Cómo contamos
Para el censo de disponibilidad de referencias, inspeccionamos la tabla Parquet train de la revisión 11e7900cdcac61bc4daf59e65feb238acda98fbf de GDPval, verificamos 220 identificadores de tareas distintos y agrupamos solo por sector, ocupación y longitud de cada lista deliverable_files. El script de análisis comprueba el hash de la fuente y reproduce los recuentos con DuckDB 1.4.4. Descarga temporalmente la tabla completa y la elimina después de una ejecución normal; su salida no conserva prompts, rúbricas, identificadores de tareas individuales, rutas de entregables ni entregables. No se ejecutó ningún modelo, benchmark ni renderizador de referencias.
Para reproducirlo localmente con Python 3.9 o posterior en macOS o Linux, asegúrate de que python3 seleccione esa versión:
python3 -m venv .gdpval-venv
.gdpval-venv/bin/python -m pip install duckdb==1.4.4
.gdpval-venv/bin/python analyze.py > observations.json
sapien1 pone estos scripts a disposición para descargarlos y ejecutarlos localmente; no se indica ninguna licencia adicional para modificarlos o redistribuirlos. Los términos del conjunto de datos de origen son independientes.
OpenAI describe el subconjunto gold de 220 tareas como de código abierto. La ficha fijada del conjunto de datos contiene un canario del benchmark y no incluye un campo de licencia; consulta los términos aplicables a tu propio uso en lugar de deducirlos de una etiqueta de la ficha o de este recuento. Las denominaciones de sectores y ocupaciones y el benchmark siguen atribuidos a su fuente.