Pananaliksik
Binabago ng pag-filter batay sa reference file ang komposisyon ng mga pampublikong task sa GDPval
Wika ng artikulo: Tagalog
Mas madaling unawain ang benchmark score kapag alam mo kung aling mga task ang maaaring maisama rito. Sa pampublikong gold task table ng GDPval, nagsisimula ang bawat isa sa 44 na trabaho na may limang task. Pero hindi magagamit nang pare-pareho ang bawat row sa talahanayang iyon sa isang paghahambing na nangangailangan ng nakalistang expert reference file: 35 sa 220 row ang may walang lamang listahan ng deliverable_files.
Nakadokumento na ang kabuuang iyon sa implementasyon ng GDPval sa gbench. Binilang namin kung paano nakakalat ang mga walang lamang listahang iyon sa mga sektor at trabaho sa parehong nakatakdang snapshot ng GDPval. May kahit isang row pa rin na may nakalistang file ang lahat ng 44 na trabaho. Pero hindi na kasing pantay ng orihinal na talahanayan ang distribusyon ng natitirang mga task.
Aling mga gawain ang may nakalistang reference file mula sa eksperto?
Tinutukoy lamang ng mga bilang na ito kung may kahit isang path ng expert deliverable na nakalista sa talahanayan. Ang nakalistang path ay hindi patunay na maa-access o maipapakita ang file. Hindi rin pinatutunayan ng walang lamang listahan kung may reference sa ibang lugar sa labas ng talahanayang ito.
| Sektor | Mga row sa pampublikong gold table | May nakalistang deliverable | Walang laman ang listahan |
|---|---|---|---|
| Pananalapi at Seguro | 25 | 17 | 8 |
| Pamahalaan | 25 | 22 | 3 |
| Pangangalagang Pangkalusugan at Tulong Panlipunan | 25 | 22 | 3 |
| Impormasyon | 25 | 14 | 11 |
| Pagmamanupaktura | 25 | 25 | 0 |
| Propesyonal, Siyentipiko, at Teknikal na Serbisyo | 25 | 24 | 1 |
| Real Estate, Pagpaparenta, at Pagpapaupa | 25 | 20 | 5 |
| Tingiang Kalakalan | 20 | 16 | 4 |
| Pakyawang Kalakalan | 25 | 25 | 0 |
| Kabuuan | 220 | 185 | 35 |
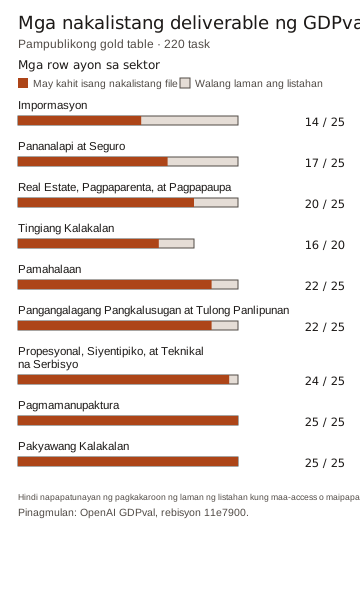
Ipinapakita ng mga bar kung may laman ang listahan; hindi nila pinatutunayang maa-access o maipapakita ang file.
May 44 na pangkat ng trabaho at sektor sa talahanayan, na may tiglilimang task. Sa mga iyon, 22 ang nagpapanatili ng lahat ng limang row sa pag-filter na ito at 22 ang nagpapanatili ng dalawa hanggang apat. Nananatili ang bawat trabaho, pero ang presensya lamang nito ay hindi na nangangahulugang pare-pareho ang bilang ng mga task para sa bawat isa.
Mahalaga ang pagkakaiba sa pagitan ng mga sektor kapag binabasa ang pinagsama-samang resulta. Ang Impormasyon at Pagmamanupaktura ay may tig-25 sa orihinal na 220 row, o 11.4%. Sa isang hipotetikal na buod na pantay ang bigat ng bawat task at sumasaklaw sa eksaktong 185 row na may laman ang listahan, ang bahagi ng Impormasyon ay magiging 14/185, o 7.6%, at ang sa Pagmamanupaktura ay 25/185, o 13.5%. Mga bahagi ito ng mga task, hindi mga model score o pagtataya ng halaga ng iba't ibang trabaho.
Mababasa ba ng sistema ng pagmamarka ang mga reference file?
Ang kalkulasyong may 185 row ay hindi ang pinal na denominator sa pagmamarka ng gbench. Inilalarawan sa dokumentasyon nito ang apat pang task na ang mga nakalistang deliverable ay hindi maipakita bilang teksto, kaya 181 task na may reference na maipapakita ang natitira sa snapshot na iyon. Hindi namin hiwalay na sinubukang ipakita ang mga file na iyon o patakbuhin ang gbench.
Kahit hindi alam kung saang mga sektor kabilang ang apat na task na iyon, nagbibigay ang mga bilang ng kapaki-pakinabang na hangganan para sa nakadokumentong hanay na may reference na maipapakita. Kung apat na magkakaibang row ang mga iyon mula sa 185 row na may laman ang listahan, mananatili ang hindi bababa sa 21 row ng Pagmamanupaktura at hindi hihigit sa 14 na row ng Impormasyon. Kung pantay ang bigat ng bawat task, ang mga hangganang iyon ay 21/181 (11.6%) at 14/181 (7.7%), ayon sa pagkakasunod. Maaaring iba ang denominator ng mga namarkahang task sa aktuwal na pagpapatakbo dahil mahalaga rin ang mga pagkabigo sa pagbuo, pagkabigo ng judge, at bilang ng pagsubok sa bawat task. Hindi inilalarawan ng mga bilang na ito ang orihinal na resulta ng OpenAI na minarkahan ng tao.
May iba't ibang kinakailangan ang ibang paraan ng pagmamarka. Sa nakadokumentong rubric mode ng NeMo Gym sa commit na 5d6429f, minamarkahan ng isang LLM judge ang isang candidate deliverable batay sa rubric ng task. Hindi kinokopya ng code para sa paghahanda nito ang listahan ng deliverable_files para sa expert output, samantalang ibinabalik ng code na sumusuri sa pamantayan sa pagmamarka nito ang missing_rubric kung parehong walang laman ang dalawang field ng rubric. Kailangang ihanda ang anumang nakalistang task-input file, at kailangan pa rin ng candidate output at judge; hindi nagtatakda ng partikular na rebisyon ng dataset ang preparation call. Hindi namin pinatakbo ang NeMo Gym o sinukat ang saklaw nito. Magkaibang sukatan ang rubric score nito at ang rate ng panalo o tabla ng gbench.
Ano ang nakikita ng judge
Isang bahagi lamang ng paghahambing ang pagkakaroon ng reference. Iniulat na ng dokumentasyon ng gbench na 32 sa 220 rubric ang lumalampas sa default na limitasyon nitong 8,000 character para sa rubric. Pinananatili ng formatter nito ang buong pamantayan sa orihinal na pagkakasunod hanggang sa lumampas sa limitasyon ang susunod, at saka nagdadagdag ng marker na nagsasaad na may pinutol; kung ang unang pamantayan pa lamang ay lampas na sa limitasyon, bahagi lamang nito ang ipinapakita. Magkaiba ang bilang ng character at bilang ng token.
Inilapat namin ang nakatakdang formatter na iyon sa talahanayan ng mga task. Sa 185 row na may nakalistang expert deliverable, 26 na rubric ang mapuputol sa default na limitasyon, na mag-iiwan ng kabuuang 247 buong pamantayan sa mga row na iyon. Hindi tiyak na maipapakita ang isang nakalistang deliverable, at maaaring makahadlang sa pagtawag sa judge ang mga nabigo o walang lamang output, kaya hindi ito mga bilang ng mga paghahambing na hinusgahan. Bilang halimbawa, kung limitasyon lamang ng formatter ang babaguhin sa 12,000 o 16,000 character, dalawa o wala sa 185 rubric na iyon ang mapuputol, ayon sa pagkakasunod. Hindi namin sinubukan ang mga setting na iyon sa isang evaluator o judge. Hindi pinatutunayan ng bilang ng mga inalis na pamantayan ang kahalagahan ng mga ito o kung magbabago ang hatol; maaaring mabawasan ng mas mataas na limitasyon ang natitirang espasyo sa isang nakapirming context window. Suriin ang impormasyong naitala ng aktuwal na pagpapatakbo tungkol sa pagputol kasama ng mga bilang nito para sa reference at pagmamarka.
Makukuha muli ang mga bilang na ito sa script na sumusuri sa mga pamantayan sa pagmamarka gamit ang DuckDB 1.4.4. Pansamantala nitong dina-download ang buong nakatakdang talahanayan ng mga task at pinoproseso ang teksto ng rubric sa memory; pinagsama-samang bilang lamang ang nananatili sa output nito, hindi mga task ID o teksto ng rubric. Inaalis nito ang pansamantalang talahanayan pagkatapos ng normal na pagpapatakbo. Ang sinuri at napatunayan sa pamamagitan ng hash na formatter mula sa gbench lamang ang pinapatakbo nito sa isang restricted namespace, na hindi isang security sandbox. Kasama sa archive ang lisensya at notice mula sa orihinal na pinagmulan. Pagkatapos ng setup ng DuckDB sa ibaba, gamitin ang Python 3.11 upang likhain ang environment, i-download ang archive, at patakbuhin ito sa macOS o Linux:
unzip rubric-screen.zip -d rubric-screen
.gdpval-venv/bin/python rubric-screen/rubric-screen.py > rubric-observations.json
Itala ang landas mula sa mga task hanggang sa mga score
Kapag nagse-set up o naghahambing ng isang evaluation, itala ang rebisyon ng dataset, ang kinakailangang uri ng reference, at bawat tuntunin sa pagiging kwalipikado. Iulat ang mga bilang ayon sa pangkat sa panimulang talahanayan, pagkatapos ng mga pagsusuri sa reference, at pagkatapos ng pagmamarka. Itala nang magkakahiwalay ang mga dahilan para sa kawalan ng nakalistang reference, hindi mabasang reference, nabigong pagbuo, at hindi magamit na hatol ng judge. Kung hindi, maaaring itago ng iisang pinagsama-samang resulta kung aling mga task ang tumigil sa pag-ambag.
Sabihin din kung paano binibigyan ng bigat ang natitirang mga task at pagsubok. Magkakaibang tanong ang sinasagot ng pantay na bigat sa bawat task, bawat trabaho, at bawat pagsubok kapag magkakaiba ang mga bilang. Wala sa mga ito ang mismong pumupuno sa nawawalang ebidensya; nakadepende ang angkop na buod sa nilalayong sukatin ng evaluation.
Para sa isang hanay ng mga task na ikaw mismo ang nagdidisenyo, ipinapakita ng gabay sa agent evaluation kung paano magtakda ng mga pagsusuring maaaring obserbahan at unawain ang mga paulit-ulit na pagsubok.
Itala ang eksaktong bersyon ng bawat input file
Hindi nangangahulugang nakatakda rin sa partikular na rebisyon ang bawat file na dina-download ng evaluator dahil lamang nakatakda sa gayong rebisyon ang talahanayan ng mga task. Sa isang naunang pampublikong talahanayan ng GDPval sa rebisyong 4bf6426, 122 sa 220 row ng task ang may nakalistang input file. Ang lahat ng 262 nakalistang input URL ay tumuturo sa nagbabagong branch na main ng repository. Ayon sa metadata ng provider, 62 sa parehong mga path na iyon ang may ibang laki at blob ID pagsapit ng rebisyong 11e7900; lumilitaw ang 62 path na iyon sa 20 row ng naunang talahanayan. Mga task input ang mga ito, na hiwalay sa mga expert reference output sa deliverable_files na binilang sa itaas.
Hindi nito ipinapakita na isang partikular na evaluation ang gumamit ng nabagong input, na sira ang isang file, o na nagbago ang isang score. Ipinapakita nito kung bakit maaaring ibang bersyon ng input ang mapili kapag sinundan sa ibang pagkakataon ang mga nagbabagong URL sa isang naka-save na talahanayan. Hindi namin sinuri ang nilalaman ng mga input file.
Sa commit na 5c092d5 ng Inspect Evals, itinatakda ng GDPval loader ang talahanayan ng mga task nito sa rebisyong a3848a2. Byte-identical ang talahanayang iyon sa naunang talahanayan sa itaas, at tumutugma rin ang metadata ng input file ng provider. Minamapa ng loader ang magkapares na URL sa talahanayan tungo sa mga sample file mapping; ayon sa dokumentasyon ng Inspect, maaaring gumamit ng mga URL ang mga mapping na iyon. Kaya maaaring magdala ang source path na ito ng mga nagbabagong URL kasama ng isang nakatakdang talahanayan. Hindi namin sinubukan ang pag-download o caching ng file ng Inspect, o tinukoy kung ano ang ginamit sa alinmang pagpapatakbo.
Sa halip, maaaring lutasin ng evaluator ang mga path na nakabatay sa lokasyon ng dataset sa parehong hindi nababagong rebisyon ng talahanayan nito. Ang implementasyon ng gbench na sinuri rito ay tahasang nagbibigay ng nakatakdang rebisyon nito kapag kumukuha ng mga attachment. Itala ang rebisyon at, kung praktikal, beripikahin ang mga file na aktuwal na ginamit. Ipinapaliwanag ng dokumentasyon ng Hugging Face sa pag-download kung paano tukuyin ang commit na katumbas ng isang nagbabagong rebisyon para maging pare-pareho ang mga download.
Ginagawang muli ng script para sa pagsusuri ng input URL ang mga bilang gamit ang DuckDB 1.4.4. Pansamantala nitong dina-download ang naunang talahanayan ng mga task, inaalis ito pagkatapos ng normal na pagpapatakbo, at hindi pinananatili sa output nito ang teksto ng task, mga indibidwal na ID, input path, o nilalaman ng input. May opsyonal na flag na sumusuri sa response header ng isang path at sa kasalukuyang rebisyon ng main; maaaring magbago ang resulta nito habang nagbabago ang main. Para sa pagsusuring iyon, mga HEAD request lamang ang ipinapadala ng script, kabilang sa mga redirect, at nananatiling hindi naobserbahan ang mga resultang hindi available. Inihahambing ng mga pagsusuri gamit ang Python standard library ang talahanayan at metadata na nakatakda sa partikular na rebisyon ng Inspect at sinusuri ang source ng loader na nakatakda sa partikular na rebisyon nang hindi ito pinapatakbo. Binabasa ng pagsusuri sa hash ng talahanayan ang buong talahanayan sa memory, pero hindi nito pina-parse o pinananatili ang nilalaman ng mga task. Hindi hinihingi ng mga script ang mga body ng input file.
Pagkatapos ng setup ng DuckDB sa ibaba, patakbuhin ang mga pagsusuri sa macOS o Linux gamit ang:
.gdpval-venv/bin/python input-url-revisions.py > input-url-observations.json
.gdpval-venv/bin/python inspect-dataset-check.py
.gdpval-venv/bin/python inspect-source-check.py
Paano kami nagbilang
Para sa pagsusuri sa pagkakaroon ng reference, sinuri namin ang talahanayang Parquet na train sa rebisyon ng GDPval na 11e7900cdcac61bc4daf59e65feb238acda98fbf, bineripika ang 220 magkakaibang task ID, at pinangkat lamang ang sektor, trabaho, at haba ng bawat listahan ng deliverable_files. Sinusuri ng script para sa pagsusuri ang hash ng source at ginagawang muli ang mga bilang gamit ang DuckDB 1.4.4. Pansamantala nitong dina-download ang buong talahanayan at inaalis ito pagkatapos ng normal na pagpapatakbo; walang prompt, rubric, indibidwal na task ID, deliverable path, o deliverable na pinananatili sa output nito. Walang model, benchmark, o reference renderer na pinatakbo.
Upang gawin itong muli sa sariling computer gamit ang Python 3.9 o mas bago sa macOS o Linux, tiyaking ang bersyong iyon ang pinipili ng python3:
python3 -m venv .gdpval-venv
.gdpval-venv/bin/python -m pip install duckdb==1.4.4
.gdpval-venv/bin/python analyze.py > observations.json
Ginagawang available ng sapien1 ang mga script na ito para i-download at patakbuhin sa sariling computer; walang nakasaad na karagdagang lisensya para baguhin o muling ipamahagi ang mga ito. Hiwalay ang mga tuntunin ng pinagmulang dataset.
Ayon sa OpenAI, inilabas nito bilang open source ang gold subset na may 220 gawain. Ang dataset card na nakatakda sa partikular na rebisyon ay may benchmark canary at walang field para sa lisensya; suriin ang mga tuntuning naaangkop sa sarili mong paggamit sa halip na huminuha mula sa label ng card o sa bilang na ito. Ang mga label ng sektor at trabaho at ang benchmark ay nananatiling naka-attribute sa orihinal na pinagmulan.