Onderzoek
Een selectie op referentiebestanden verandert de publieke taakverdeling van GDPval
Taal: Nederlands
Een benchmarkscore is makkelijker te duiden als je weet welke taken erin kunnen meetellen. In de publieke gold-taaktabel van GDPval begint elk van de 44 beroepen met vijf taken. Maar een vergelijking waarvoor een vermeld expertreferentiebestand nodig is, kan niet elke rij in die tabel op dezelfde manier gebruiken: bij 35 van de 220 rijen is de lijst deliverable_files leeg.
Dat totaal is al gedocumenteerd in de GDPval-implementatie van gbench. Wij telden hoe die lege lijsten over sectoren en beroepen zijn verdeeld in dezelfde vastgepinde GDPval-snapshot. Alle 44 beroepen hebben nog steeds minstens één rij met een vermeld bestand. Maar de resterende verdeling is minder gelijkmatig dan die in de oorspronkelijke tabel.
Bij welke taken staat een referentiebestand van een expert vermeld?
Deze aantallen geven alleen aan of de tabel minstens één pad naar een expertbestand vermeldt. Een vermeld pad bewijst niet dat het bestand toegankelijk of weer te geven is. Een lege lijst zegt niet of er ergens buiten deze tabel een referentie bestaat.
| Sector | Rijen in publieke gold-tabel | Met vermeld bestand | Met lege lijst |
|---|---|---|---|
| Financiële dienstverlening en verzekeringen | 25 | 17 | 8 |
| Overheid | 25 | 22 | 3 |
| Gezondheidszorg en maatschappelijke dienstverlening | 25 | 22 | 3 |
| Informatie | 25 | 14 | 11 |
| Industrie | 25 | 25 | 0 |
| Zakelijke, wetenschappelijke en technische dienstverlening | 25 | 24 | 1 |
| Onroerend goed en verhuur en leasing | 25 | 20 | 5 |
| Detailhandel | 20 | 16 | 4 |
| Groothandel | 25 | 25 | 0 |
| Totaal | 220 | 185 | 35 |
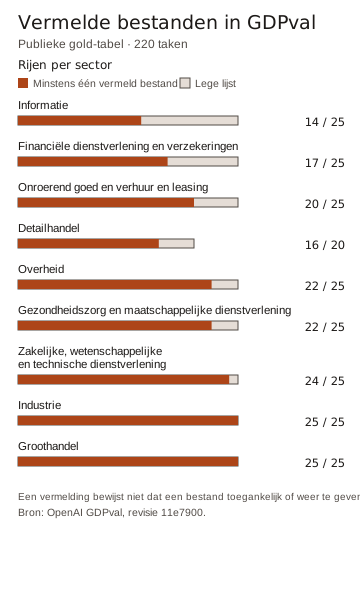
De balken tonen vermeldingen in de lijst, geen gecontroleerde toegankelijkheid of weergave.
De tabel bevat 44 groepen van beroep en sector met elk vijf taken. Daarvan behouden 22 groepen bij deze selectie alle vijf de rijen en 22 groepen twee tot vier. Elk beroep is nog steeds vertegenwoordigd, maar dat betekent niet meer dat elk beroep evenveel taken heeft.
Het verschil tussen sectoren helpt bij het duiden van een totaalcijfer. Informatie en industrie zijn elk goed voor 25 van de oorspronkelijke 220 rijen, oftewel 11,4%. In een hypothetisch overzicht waarin precies de 185 rijen met een vermelding per taak even zwaar wegen, zou informatie goed zijn voor 14/185, oftewel 7,6%, en industrie voor 25/185, oftewel 13,5%. Dit zijn aandelen in het aantal taken, geen modelscores of schattingen van de waarde van verschillende beroepen.
Kan het beoordelingssysteem de referentiebestanden lezen?
De berekening met 185 rijen is niet de uiteindelijke noemer voor de scores van gbench. De documentatie beschrijft nog vier taken waarvan de vermelde bestanden niet naar tekst kunnen worden omgezet. In die snapshot blijven daardoor 181 taken over waarvan de referentie naar tekst kan worden omgezet. Wij hebben die bestanden niet zelf omgezet en gbench niet uitgevoerd.
Ook zonder te weten tot welke sectoren die vier taken behoren, stellen de aantallen bruikbare grenzen aan de gedocumenteerde set met naar tekst omzetbare referenties. Als het om vier verschillende rijen uit de 185 rijen met een vermelding gaat, blijven er minstens 21 rijen voor industrie en hoogstens 14 voor informatie over. Bij een gelijke weging per taak zijn die grenzen respectievelijk 21/181 (11,6%) en 14/181 (7,7%). Bij een daadwerkelijke run kan de noemer voor de score anders zijn, omdat ook mislukte generaties, fouten bij de beoordeling en het aantal pogingen per taak meetellen. Deze aantallen beschrijven niet de oorspronkelijke, door mensen beoordeelde resultaten van OpenAI.
Andere beoordelingsmethoden stellen andere eisen. In de gedocumenteerde rubric-modus van NeMo Gym bij commit 5d6429f beoordeelt een LLM-beoordelaar een kandidaatbestand aan de hand van de rubric van de taak. De voorbereidingscode kopieert de lijst deliverable_files met expertuitvoer niet, terwijl de rubric-verificatie missing_rubric meldt als beide rubricvelden leeg zijn. Eventuele vermelde invoerbestanden voor de taak moeten worden klaargezet en er zijn nog steeds een kandidaatuitvoer en een beoordelaar nodig; de voorbereidingsaanroep legt geen datasetrevisie vast. Wij hebben NeMo Gym niet uitgevoerd en de dekking ervan niet gemeten. De rubricscore van NeMo Gym en het aandeel gewonnen of gelijkgespeelde vergelijkingen van gbench zijn verschillende maatstaven.
Wat de beoordelaar kan zien
De beschikbaarheid van referenties is maar één onderdeel van de vergelijking. De documentatie van gbench meldt al dat 32 van de 220 rubrics de standaardlimiet van 8.000 tekens voor rubrics overschrijden. De formatter behoudt volledige criteria in hun oorspronkelijke volgorde totdat het volgende criterium de limiet zou overschrijden en voegt dan een markering toe dat de tekst is afgekapt. Als het eerste criterium op zichzelf al langer is dan de limiet, toont de formatter slechts een deel ervan. Aantallen tekens zijn geen aantallen tokens.
Wij hebben die vastgepinde formatter op de taaktabel toegepast. Van de 185 rijen met een vermeld expertbestand zouden bij de standaardlimiet 26 rubrics worden afgekapt, waarbij over die rijen samen 247 volledige criteria wegvallen. Een vermeld bestand is niet per se naar tekst om te zetten en mislukte of lege generaties kunnen een beoordelingsaanroep verhinderen. Dit zijn dus geen aantallen beoordeelde vergelijkingen. Ter illustratie: als alleen de limiet van de formatter wordt gewijzigd naar 12.000 of 16.000 tekens, zouden respectievelijk twee of geen van die 185 rubrics worden afgekapt. Wij hebben die instellingen niet met een evaluator of beoordelaar uitgevoerd. Het aantal weggelaten criteria zegt niets over hun belang of over een mogelijke verandering van het oordeel; een hogere limiet kan minder ruimte overlaten voor de rest van een vast contextvenster. Bekijk de afkapinformatie die de daadwerkelijke run vastlegt naast de aantallen referenties en scores.
De rubricselectie reproduceert deze aantallen met DuckDB 1.4.4. Het script downloadt tijdelijk de volledige vastgepinde taaktabel en verwerkt de rubrictekst in het geheugen; de uitvoer bevat alleen geaggregeerde aantallen, geen taak-ID's of rubrictekst. Na een normale run verwijdert het de tijdelijke tabel. Het voert alleen de geïnspecteerde, met een hash gecontroleerde formatter van gbench uit in een beperkte naamruimte, die geen beveiligingssandbox is. Het archief bevat de oorspronkelijke licentie en kennisgeving. Maak na de onderstaande installatie van DuckDB met Python 3.11 de omgeving aan, download het archief en voer het uit op macOS of Linux:
unzip rubric-screen.zip -d rubric-screen
.gdpval-venv/bin/python rubric-screen/rubric-screen.py > rubric-observations.json
Leg het pad van taken naar scores vast
Leg bij het opzetten of vergelijken van een evaluatie de datasetrevisie, het vereiste referentietype en elke toelatingsregel vast. Rapporteer aantallen per groep in de begintabel, na referentiecontroles en na de beoordeling. Houd de redenen voor een ontbrekende vermelde referentie, een onleesbare referentie, een mislukte generatie en een onbruikbaar oordeel van de beoordelaar apart bij. Eén totaalcijfer kan anders verhullen welke taken niet meer meetelden.
Vermeld ook hoe de resterende taken en pogingen worden gewogen. Gelijke weging per taak, per beroep en per poging beantwoordt verschillende vragen als de aantallen verschillen. Geen van deze methoden vult ontbrekend bewijs op zichzelf aan; welk overzicht geschikt is, hangt af van wat de evaluatie moet meten.
Voor een zelf ontworpen taakset laat de handleiding voor agentevaluatie zien hoe je waarneembare controles vastlegt en herhaalde proeven interpreteert.
Noteer de exacte versie van elk invoerbestand
Een vastgepinde taaktabel legt niet noodzakelijk elk bestand vast dat een evaluator downloadt. In een eerdere publieke GDPval-tabel bij revisie 4bf6426 vermelden 122 van de 220 taakrijen invoerbestanden. Alle 262 vermelde invoer-URL's verwijzen naar de veranderlijke main-branch van de repository. Uit de metadata van de aanbieder blijkt dat 62 van diezelfde paden bij revisie 11e7900 een andere grootte en andere blob-ID's hadden; die 62 paden komen voor in 20 rijen van de eerdere tabel. Dit zijn taakinvoerbestanden, geen expertuitvoerbestanden in deliverable_files die hierboven als referentie zijn geteld.
Dit toont niet aan dat een specifieke evaluatie gewijzigde invoer gebruikte, dat een bestand beschadigd is of dat een score veranderde. Het laat wel zien waarom het later volgen van veranderlijke URL's uit een opgeslagen tabel een andere versie van een invoerbestand kan opleveren. Wij hebben de inhoud van de invoerbestanden niet geanalyseerd.
Bij Inspect Evals-commit 5c092d5 pint de GDPval-loader zijn taaktabel vast op revisie a3848a2. Die tabel is byte voor byte identiek aan de eerdere tabel hierboven en ook de metadata van de invoerbestanden van de aanbieder komen overeen. De loader zet gekoppelde tabel-URL's om in bestandstoewijzingen voor samples; volgens de documentatie van Inspect kunnen die toewijzingen URL's gebruiken. Dit bronpad kan dus veranderlijke URL's naast een vaste tabel bevatten. Wij hebben het downloaden of cachen van bestanden door Inspect niet getest en niet vastgesteld wat een run heeft gebruikt.
Een evaluator kan in plaats daarvan datasetrelatieve paden ophalen op basis van dezelfde onveranderlijke revisie als de tabel. De hier geïnspecteerde gbench-implementatie geeft bij het ophalen van bijlagen expliciet de vastgepinde revisie mee. Leg de revisie vast en controleer waar mogelijk welke bestanden daadwerkelijk zijn gebruikt. De downloaddocumentatie van Hugging Face legt uit hoe je een veranderlijke revisie naar een commit vertaalt voor consistente downloads.
Het analysescript voor invoer-URL's reproduceert de aantallen met DuckDB 1.4.4. Het downloadt de eerdere taaktabel tijdelijk, verwijdert die na een normale run en bewaart in de uitvoer geen taaktekst, afzonderlijke ID's, invoerpaden of invoerinhoud. Een optionele vlag controleert de responsheaders van één pad en de huidige main-revisie; het resultaat kan veranderen als main verandert. Voor die controle verstuurt het script uitsluitend HEAD-verzoeken, ook bij omleidingen, en laat het niet-beschikbare resultaten buiten beschouwing. De controles met de standaardbibliotheek van Python vergelijken de door Inspect vastgepinde tabel en metadata en inspecteren de vastgepinde broncode van de loader zonder die uit te voeren. De controle van de tabelhash leest de volledige tabel in het geheugen, maar ontleedt of bewaart de taakinhoud niet. De scripts vragen de inhoud van invoerbestanden niet op.
Voer na de onderstaande installatie van DuckDB de controles op macOS of Linux uit met:
.gdpval-venv/bin/python input-url-revisions.py > input-url-observations.json
.gdpval-venv/bin/python inspect-dataset-check.py
.gdpval-venv/bin/python inspect-source-check.py
Hoe we telden
Voor de telling van beschikbare referenties hebben we de Parquet-tabel train bij GDPval-revisie 11e7900cdcac61bc4daf59e65feb238acda98fbf geïnspecteerd, 220 unieke taak-ID's gecontroleerd en alleen sector, beroep en de lengte van elke lijst deliverable_files gegroepeerd. Het analysescript controleert de hash van de bron en reproduceert de aantallen met DuckDB 1.4.4. Het downloadt de volledige tabel tijdelijk en verwijdert die na een normale run; de uitvoer bevat geen prompts, rubrics, afzonderlijke taak-ID's, paden naar bestanden of bestanden zelf. Er is geen model, benchmark of referentierenderer uitgevoerd.
Om dit lokaal te reproduceren met Python 3.9 of later op macOS of Linux, controleer je of python3 die versie selecteert:
python3 -m venv .gdpval-venv
.gdpval-venv/bin/python -m pip install duckdb==1.4.4
.gdpval-venv/bin/python analyze.py > observations.json
sapien1 stelt deze scripts beschikbaar om lokaal te downloaden en uit te voeren; er wordt geen aanvullende licentie vermeld om ze te wijzigen of te verspreiden. Voor de brondataset gelden aparte voorwaarden.
OpenAI beschrijft de gold-subset met 220 taken als open source beschikbaar gemaakt. De vastgepinde datasetkaart bevat een benchmarkcanary en geen licentieveld; controleer de voorwaarden die op jouw gebruik van toepassing zijn in plaats van die af te leiden uit een label op de kaart of uit dit aantal. De sector- en beroepslabels en de benchmark blijven toegeschreven aan hun bron.