Forschung
Eine Prüfung auf Referenzdateien verändert die öffentliche Aufgabenverteilung von GDPval
Sprache: Deutsch
Ein Benchmark-Ergebnis lässt sich leichter einordnen, wenn klar ist, welche Aufgaben einfließen können. In der öffentlichen Gold-Aufgabentabelle von GDPval beginnen alle 44 Berufe mit jeweils fünf Aufgaben. Ein Vergleich, der eine aufgeführte Expertenreferenzdatei voraussetzt, kann jedoch nicht jede Zeile dieser Tabelle gleichermaßen nutzen: Bei 35 von 220 Zeilen ist die Liste deliverable_files leer.
Diese Gesamtzahl ist bereits in der gbench-Implementierung von GDPval dokumentiert. Wir haben gezählt, wie sich diese leeren Listen in demselben fixierten GDPval-Snapshot auf Branchen und Berufe verteilen. Alle 44 Berufe haben weiterhin mindestens eine Zeile mit einer aufgeführten Datei. Die verbleibende Verteilung ist jedoch weniger gleichmäßig als in der Ausgangstabelle.
Bei welchen Aufgaben ist eine Referenzdatei von Fachleuten angegeben?
Diese Zählung prüft lediglich, ob die Tabelle mindestens einen Pfad zu einem Expertenergebnis aufführt. Ein aufgeführter Pfad belegt nicht, dass die Datei zugänglich oder darstellbar ist. Eine leere Liste sagt nicht aus, ob außerhalb dieser Tabelle eine Referenz existiert.
| Branche | Zeilen in der öffentlichen Gold-Tabelle | Mit aufgeführtem Ergebnis | Mit leerer Liste |
|---|---|---|---|
| Finanz- und Versicherungswesen | 25 | 17 | 8 |
| Öffentlicher Sektor | 25 | 22 | 3 |
| Gesundheits- und Sozialwesen | 25 | 22 | 3 |
| Information | 25 | 14 | 11 |
| Verarbeitendes Gewerbe | 25 | 25 | 0 |
| Freiberufliche, wissenschaftliche und technische Dienstleistungen | 25 | 24 | 1 |
| Grundstücks- und Wohnungswesen, Vermietung und Verpachtung | 25 | 20 | 5 |
| Einzelhandel | 20 | 16 | 4 |
| Großhandel | 25 | 25 | 0 |
| Gesamt | 220 | 185 | 35 |
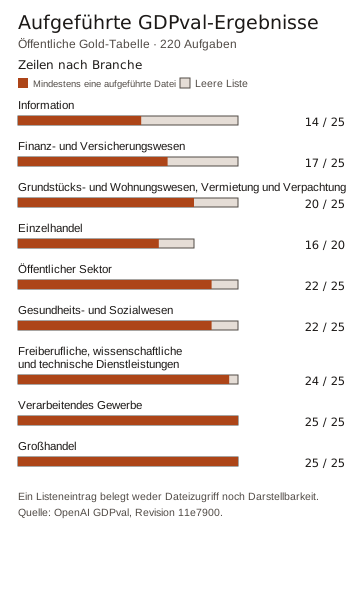
Die Balken zeigen Listeneinträge, keinen überprüften Dateizugriff und keine überprüfte Darstellbarkeit.
Die Tabelle enthält 44 Berufs-Branchen-Gruppen mit jeweils fünf Aufgaben. Davon behalten 22 bei dieser Prüfung alle fünf Zeilen und 22 zwischen zwei und vier. Jeder Beruf ist weiterhin vertreten, doch allein daraus folgt nicht mehr, dass für jeden Beruf gleich viele Aufgaben vorliegen.
Der Branchenvergleich hilft bei der Einordnung eines Gesamtergebnisses. Auf Information und das verarbeitende Gewerbe entfallen jeweils 25 der ursprünglich 220 Zeilen, also 11,4 %. In einer hypothetischen Auswertung, die genau die 185 Zeilen mit Listeneintrag umfasst und alle Aufgaben gleich gewichtet, entfielen auf Information 14/185 oder 7,6 % und auf das verarbeitende Gewerbe 25/185 oder 13,5 %. Das sind Aufgabenanteile, keine Modellwerte oder Schätzungen zum Wert verschiedener Berufe.
Kann das Bewertungssystem die Referenzdateien lesen?
Die Berechnung mit 185 Zeilen entspricht nicht dem endgültigen Nenner für die Bewertung in gbench. Die Dokumentation beschreibt vier weitere Aufgaben, deren aufgeführte Ergebnisse sich nicht als Text darstellen lassen. Damit verbleiben in diesem Snapshot 181 Aufgaben mit darstellbarer Referenz. Wir haben diese Dateien nicht unabhängig gerendert und gbench nicht ausgeführt.
Auch ohne zu wissen, zu welchen Branchen diese vier Aufgaben gehören, lassen sich die Grenzen der dokumentierten Menge mit darstellbarer Referenz sinnvoll eingrenzen. Wenn es sich um vier unterschiedliche Zeilen aus den 185 Zeilen mit Listeneintrag handelt, verbleiben mindestens 21 Zeilen des verarbeitenden Gewerbes und höchstens 14 Zeilen aus Information. Bei gleicher Gewichtung der Aufgaben liegen diese Grenzen bei 21/181 (11,6 %) beziehungsweise 14/181 (7,7 %). Bei einem tatsächlichen Durchlauf kann der Nenner der bewerteten Aufgaben anders ausfallen, da auch Fehler bei der Generierung, Fehler des Bewertungsmodells und die Anzahl der Versuche pro Aufgabe eine Rolle spielen. Diese Zahlen beschreiben nicht die ursprünglichen, von Menschen bewerteten Ergebnisse von OpenAI.
Andere Bewertungsmethoden haben andere Anforderungen. Im dokumentierten Rubrikmodus von NeMo Gym bei Commit 5d6429f bewertet ein LLM als Judge ein Kandidatenergebnis anhand der Aufgabenrubrik. Der Vorbereitungscode kopiert die Liste deliverable_files der Expertenausgaben nicht, während der Rubrikprüfer missing_rubric meldet, wenn beide Rubrikfelder leer sind. Alle aufgeführten Aufgabeneingabedateien müssen bereitgestellt werden; außerdem werden weiterhin eine Kandidatenausgabe und ein Judge benötigt. Der Vorbereitungsaufruf fixiert keine Datensatzrevision. Wir haben NeMo Gym nicht ausgeführt und seine Abdeckung nicht gemessen. Der Rubrikwert von NeMo Gym und die Gewinn-oder-Gleichstand-Rate von gbench sind unterschiedliche Maße.
Was der Judge sehen kann
Die Verfügbarkeit von Referenzen ist nur ein Teil des Vergleichs. Die gbench-Dokumentation berichtet bereits, dass 32 der 220 Rubriken das standardmäßige Rubriklimit von 8.000 Zeichen überschreiten. Der Formatierer übernimmt vollständige Kriterien in ihrer ursprünglichen Reihenfolge, bis das nächste das Limit überschreiten würde, und fügt dann eine Kürzungsmarkierung hinzu. Wenn bereits das erste Kriterium allein das Limit überschreitet, zeigt er nur einen Teil dieses Kriteriums an. Zeichenzahlen sind keine Tokenzahlen.
Wir haben diesen fixierten Formatierer auf die Aufgabentabelle angewendet. Unter den 185 Zeilen mit aufgeführtem Expertenergebnis würden beim Standardlimit 26 Rubriken gekürzt; dabei würden über diese Zeilen hinweg 247 vollständige Kriterien entfallen. Ein aufgeführtes Ergebnis ist nicht zwangsläufig darstellbar, und fehlgeschlagene oder leere Generierungen können einen Judge-Aufruf verhindern. Daher zählen diese Zahlen keine bewerteten Vergleiche. Zur Veranschaulichung: Würde nur das Limit des Formatierers auf 12.000 beziehungsweise 16.000 Zeichen geändert, würden zwei beziehungsweise keine dieser 185 Rubriken gekürzt. Wir haben diese Einstellungen nicht mit einem Evaluator oder Judge ausgeführt. Die Anzahl ausgelassener Kriterien belegt weder deren Bedeutung noch, ob sich ein Urteil ändern würde; ein höheres Limit kann in einem festen Kontextfenster weniger Platz für den übrigen Inhalt lassen. Prüfe die vom tatsächlichen Durchlauf aufgezeichneten Kürzungsinformationen zusammen mit den Referenz- und Bewertungszahlen.
Die Rubrikprüfung reproduziert diese Zahlen mit DuckDB 1.4.4. Sie lädt die vollständige fixierte Aufgabentabelle vorübergehend herunter und verarbeitet den Rubriktext im Arbeitsspeicher; ihre Ausgabe enthält aggregierte Zahlen, keine Aufgaben-IDs oder Rubriktexte. Nach einem normalen Durchlauf entfernt sie die temporäre Tabelle. Sie führt ausschließlich den geprüften, per Hash verifizierten Formatierer von gbench in einem eingeschränkten Namensraum aus, der keine Sicherheits-Sandbox ist. Das Archiv enthält die Lizenz und den Lizenzhinweis des ursprünglichen Projekts. Nach der unten beschriebenen Einrichtung von DuckDB erstellst du die Umgebung mit Python 3.11, lädst das Archiv herunter und führst die Prüfung unter macOS oder Linux aus:
unzip rubric-screen.zip -d rubric-screen
.gdpval-venv/bin/python rubric-screen/rubric-screen.py > rubric-observations.json
Den Weg von Aufgaben zu Ergebnissen dokumentieren
Halte beim Einrichten oder Vergleichen einer Evaluation die Datensatzrevision, den erforderlichen Referenztyp und jede Zulassungsregel fest. Gib die Zahlen nach Gruppe für die Ausgangstabelle, nach den Referenzprüfungen und nach der Bewertung an. Erfasse getrennte Gründe für eine fehlende aufgeführte Referenz, eine nicht lesbare Referenz, eine fehlgeschlagene Generierung und ein nicht verwendbares Judge-Urteil. Ein einzelner Gesamtwert kann sonst verbergen, welche Aufgaben nicht mehr einfließen.
Gib außerdem an, wie die verbleibenden Aufgaben und Versuche gewichtet werden. Gleiche Gewichtung pro Aufgabe, pro Beruf oder pro Versuch beantwortet bei unterschiedlichen Anzahlen jeweils andere Fragen. Keine dieser Gewichtungen gleicht fehlende Nachweise für sich genommen aus; welche Zusammenfassung geeignet ist, hängt davon ab, was die Evaluation messen soll.
Für einen Aufgabensatz, den du selbst entwirfst, zeigt der Leitfaden zur Agentenevaluation, wie du beobachtbare Prüfungen definierst und wiederholte Versuche interpretierst.
Halte die genaue Version jeder Eingabedatei fest
Eine fixierte Aufgabentabelle fixiert nicht zwangsläufig jede Datei, die ein Evaluator herunterlädt. In einer früheren öffentlichen GDPval-Tabelle bei Revision 4bf6426 führen 122 von 220 Aufgabenzeilen Eingabedateien auf. Alle 262 aufgeführten Eingabe-URLs verweisen auf den veränderlichen Branch main des Repositorys. Die Metadaten des Anbieters weisen aus, dass 62 dieser Pfade bei Revision 11e7900 andere Größen und Blob-IDs hatten; diese 62 Pfade erscheinen in 20 Zeilen der früheren Tabelle. Es handelt sich um Aufgabeneingaben, nicht um die oben gezählten Expertenreferenzausgaben in deliverable_files.
Das zeigt weder, dass eine bestimmte Evaluation eine veränderte Eingabe verwendet hat, noch, dass eine Datei beschädigt ist oder sich ein Ergebnis verändert hat. Es zeigt aber, warum über die veränderlichen URLs einer gespeicherten Tabelle zu einem späteren Zeitpunkt eine andere Version einer Eingabe ausgewählt werden kann. Wir haben die Inhalte der Eingabedateien nicht analysiert.
Bei Inspect Evals Commit 5c092d5 fixiert der GDPval-Loader seine Aufgabentabelle auf Revision a3848a2. Diese Tabelle ist byteidentisch mit der oben genannten früheren Tabelle; auch die Metadaten des Anbieters zu den Eingabedateien stimmen überein. Der Loader überführt zusammengehörige Tabellen-URLs in Dateizuordnungen für Samples; laut Inspect-Dokumentation können diese Zuordnungen URLs verwenden. Über diesen Quellpfad können somit veränderliche URLs zusammen mit einer fixierten Tabelle weitergegeben werden. Wir haben weder die Dateidownloads oder das Caching von Inspect getestet noch festgestellt, was ein Durchlauf verwendet hat.
Ein Evaluator kann stattdessen datensatzrelative Pfade anhand derselben unveränderlichen Revision wie die Tabelle auflösen. Die hier untersuchte gbench-Implementierung gibt beim Abrufen von Anhängen ihre fixierte Revision ausdrücklich an. Halte die Revision fest und überprüfe, wo praktikabel, die tatsächlich verwendeten Dateien. Die Download-Dokumentation von Hugging Face erklärt, wie du eine veränderliche Revision für konsistente Downloads zu einem Commit auflöst.
Das Analyseskript für Eingabe-URLs reproduziert die Zahlen mit DuckDB 1.4.4. Es lädt die frühere Aufgabentabelle vorübergehend herunter, entfernt sie nach einem normalen Durchlauf und gibt weder Aufgabentexte, einzelne IDs, Eingabepfade noch Eingabeinhalte aus. Ein optionaler Parameter prüft die Antwortheader eines Pfads und die aktuelle Revision von main; sein Ergebnis kann sich ändern, wenn main weiterläuft. Für diese Prüfung sendet das Skript ausschließlich HEAD-Anfragen, auch bei Weiterleitungen, und nicht verfügbare Ergebnisse bleiben unbeobachtet. Die Prüfungen mit der Python-Standardbibliothek vergleichen die von Inspect fixierte Tabelle und ihre Metadaten und untersuchen den fixierten Loader-Quellcode, ohne ihn auszuführen. Die Tabellen-Hashprüfung liest die vollständige Tabelle in den Arbeitsspeicher, analysiert oder speichert aber ihre Aufgabeninhalte nicht. Die Skripte fordern keine Inhalte von Eingabedateien an.
Führe nach der unten beschriebenen Einrichtung von DuckDB die Prüfungen unter macOS oder Linux aus mit:
.gdpval-venv/bin/python input-url-revisions.py > input-url-observations.json
.gdpval-venv/bin/python inspect-dataset-check.py
.gdpval-venv/bin/python inspect-source-check.py
So haben wir gezählt
Für die Auswertung der Referenzverfügbarkeit haben wir die Parquet-Tabelle train bei GDPval-Revision 11e7900cdcac61bc4daf59e65feb238acda98fbf untersucht, 220 eindeutige Aufgaben-IDs verifiziert und ausschließlich nach Branche, Beruf und Länge der jeweiligen deliverable_files-Liste gruppiert. Das Analyseskript prüft den Hash der Quelle und reproduziert die Zahlen mit DuckDB 1.4.4. Es lädt die vollständige Tabelle vorübergehend herunter und entfernt sie nach einem normalen Durchlauf; seine Ausgabe enthält keine Prompts, Rubriken, einzelnen Aufgaben-IDs, Ergebnispfade oder Ergebnisse. Es wurden weder ein Modell, ein Benchmark noch ein Referenzrenderer ausgeführt.
Um die Auswertung lokal mit Python 3.9 oder neuer unter macOS oder Linux zu reproduzieren, stelle sicher, dass python3 diese Version auswählt:
python3 -m venv .gdpval-venv
.gdpval-venv/bin/python -m pip install duckdb==1.4.4
.gdpval-venv/bin/python analyze.py > observations.json
sapien1 stellt diese Skripte zum Herunterladen und lokalen Ausführen bereit; eine zusätzliche Lizenz zur Änderung oder Weiterverbreitung wird nicht angegeben. Für den Quelldatensatz gelten separate Bedingungen.
OpenAI beschreibt die Gold-Teilmenge mit 220 Aufgaben als quelloffen bereitgestellt. Die fixierte Datensatzkarte enthält einen Benchmark-Canary und kein Lizenzfeld; prüfe die für deine eigene Nutzung geltenden Bedingungen, statt sie aus einer Bezeichnung auf der Karte oder aus dieser Zählung abzuleiten. Die Branchen- und Berufsbezeichnungen sowie der Benchmark bleiben ihrer Quelle zugeordnet.