Forskning
Ett filter för referensfiler ändrar den offentliga uppgiftssammansättningen i GDPval
Språk: Svenska
Ett benchmarkresultat är lättare att tolka när man vet vilka uppgifter som kan ingå. I GDPvals offentliga guldtabel har vart och ett av 44 yrken från början fem uppgifter. Men en jämförelse som kräver en listad expertreferensfil kan inte använda varje rad i tabellen på samma sätt: 35 av 220 rader har en tom deliverable_files-lista.
Det totala antalet är redan dokumenterat i gbench-implementeringen av GDPval. Vi räknade hur de tomma listorna fördelar sig mellan sektorer och yrken i samma fastställda ögonblicksbild av GDPval. Alla 44 yrken har fortfarande minst en rad med en listad fil. Men den återstående sammansättningen är inte lika jämnt fördelad som i den ursprungliga tabellen.
Vilka uppgifter har en listad referensfil från en expert?
Dessa antal visar bara om tabellen listar minst en sökväg till en expertleverabel. En listad sökväg bevisar inte att filen är åtkomlig eller kan renderas. En tom lista visar inte om en referens finns någon annanstans utanför tabellen.
| Sektor | Rader i den offentliga guldtabeln | Med en listad leverabel | Med en tom lista |
|---|---|---|---|
| Finans och försäkring | 25 | 17 | 8 |
| Offentlig förvaltning | 25 | 22 | 3 |
| Hälso- och sjukvård och socialt arbete | 25 | 22 | 3 |
| Information | 25 | 14 | 11 |
| Tillverkning | 25 | 25 | 0 |
| Juridik, ekonomi, vetenskap och teknik | 25 | 24 | 1 |
| Fastighetsverksamhet, uthyrning och leasing | 25 | 20 | 5 |
| Detaljhandel | 20 | 16 | 4 |
| Partihandel | 25 | 25 | 0 |
| Totalt | 220 | 185 | 35 |
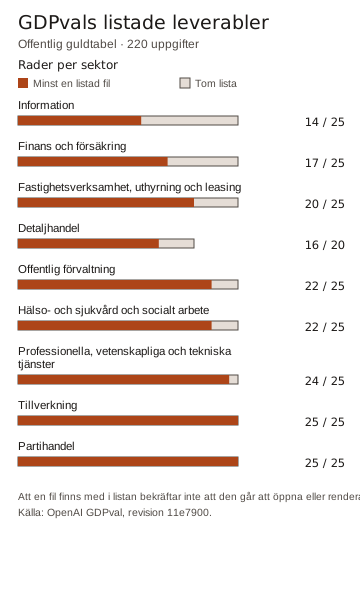
Staplarna visar förekomst i listan, inte bekräftad filåtkomst eller renderbarhet.
Tabellen innehåller 44 yrkes- och sektorsgrupper med fem uppgifter vardera. Av dessa har 22 kvar alla fem rader efter detta urvalssteg och 22 har kvar mellan två och fyra. Alla yrken finns fortfarande representerade, men det betyder inte längre att varje yrke har samma antal uppgifter.
Skillnaden mellan sektorerna är användbar när man tolkar ett sammanlagt resultat. Information och tillverkning står vardera för 25 av de ursprungliga 220 raderna, eller 11,4 %. I en hypotetisk sammanställning där exakt de 185 raderna med en listad leverans vägs lika per uppgift skulle information stå för 14/185, eller 7,6 %, och tillverkning för 25/185, eller 13,5 %. Det är andelar av uppgifterna, inte modellpoäng eller uppskattningar av värdet av olika yrken.
Kan bedömningssystemet läsa referensfilerna?
Beräkningen med 185 rader är inte gbenchs slutliga nämnare för poängsättningen. Dokumentationen beskriver ytterligare fyra uppgifter vars listade leveranser inte kan renderas till text, vilket lämnar 181 uppgifter med renderbara referenser vid den tidpunkten. Vi renderade inte själva filerna och körde inte gbench.
Även utan att veta vilka sektorer de fyra uppgifterna tillhör ger antalen användbara gränser för den dokumenterade mängden med renderbara referenser. Om det är fyra olika rader bland de 185 med en listad leverans återstår minst 21 rader inom tillverkning och högst 14 inom information. Med lika vikt per uppgift är dessa gränser 21/181 (11,6 %) respektive 14/181 (7,7 %). En faktisk körning kan ha en annan nämnare för poängsättningen eftersom även genereringsfel, bedömarfel och antalet försök per uppgift spelar roll. Dessa antal beskriver inte OpenAI:s ursprungliga resultat med mänsklig bedömning.
Andra bedömningsmetoder har andra krav. I NeMo Gyms dokumenterade bedömningsmatrisläge vid commit 5d6429f bedömer en LLM leveransen som ska utvärderas mot uppgiftens bedömningsmatris. Dess förberedelsekod kopierar inte listan deliverable_files med expertutdata, medan dess kontroll av bedömningsmatrisen rapporterar missing_rubric om båda matrisfälten är tomma. Alla listade indatafiler till uppgiften måste göras tillgängliga, och en utdata att bedöma och en bedömare behövs fortfarande. Förberedelseanropet låser inte en datasetrevision. Vi körde inte NeMo Gym och mätte inte dess täckning. Dess matrispoäng och gbenchs andel vinster eller oavgjorda resultat är olika mått.
Vad bedömaren kan se
Referenstillgång är bara en del av jämförelsen. Dokumentationen för gbench rapporterar redan att 32 av de 220 bedömningsmatriserna överskrider standardgränsen på 8 000 tecken. Formateraren behåller hela kriterier i deras ursprungliga ordning tills nästa kriterium skulle överskrida gränsen och lägger sedan till en avkortningsmarkör. Om enbart det första kriteriet överskrider gränsen visas bara en del av det. Antal tecken är inte antal token.
Vi tillämpade den revisionslåsta formateraren på uppgiftstabellen. Bland de 185 raderna med en listad expertleverans skulle 26 bedömningsmatriser kortas av vid standardgränsen, så att sammanlagt 247 hela kriterier utelämnas från dessa rader. En listad leverans går inte nödvändigtvis att rendera, och misslyckade eller tomma genereringar kan förhindra ett bedömaranrop. Därför är detta inte antal bedömda jämförelser. Som illustration skulle en ändring av enbart formaterarens gräns till 12 000 respektive 16 000 tecken göra att två respektive noll av de 185 bedömningsmatriserna kortas av. Vi körde inte dessa inställningar genom någon utvärderare eller bedömare. Antalet utelämnade kriterier visar inte hur viktiga de är eller om ett omdöme skulle ändras. En högre gräns kan ge mindre utrymme åt resten av ett kontextfönster med fast storlek. Granska informationen om avkortning som registrerats vid den faktiska körningen tillsammans med dess antal referenser och poängsatta uppgifter.
Kontrollen av bedömningsmatriser återskapar dessa antal med DuckDB 1.4.4. Den laddar tillfälligt ned hela den revisionslåsta uppgiftstabellen och bearbetar matristexten i minnet. Utdata innehåller sammanlagda antal, inte uppgifts-ID:n eller matristext. Den tar bort den tillfälliga tabellen efter en normal körning. Den kör endast den granskade och hashverifierade formateraren från gbench i en begränsad namnrymd, som inte är en säkerhetssandlåda. Arkivet innehåller upphovsprojektets licens och meddelande. Efter installationen av DuckDB nedan kan du använda Python 3.11 för att skapa miljön, ladda ned arkivet och köra på macOS eller Linux:
unzip rubric-screen.zip -d rubric-screen
.gdpval-venv/bin/python rubric-screen/rubric-screen.py > rubric-observations.json
Dokumentera vägen från uppgifter till poäng
När du sätter upp eller jämför en utvärdering, dokumentera datasetrevisionen, den referenstyp som krävs och varje behörighetsregel. Redovisa antal per grupp i starttabellen, efter referenskontroller och efter poängsättning. Håll isär orsakerna till att en listad referens saknas, en referens är oläsbar, en generering misslyckades och ett bedömaromdöme inte kan användas. Ett enda sammanlagt resultat kan annars dölja vilka uppgifter som slutade bidra.
Ange också hur de återstående uppgifterna och försöken viktas. Lika vikt per uppgift, lika vikt per yrke och lika vikt per försök besvarar olika frågor när antalen skiljer sig åt. Ingen av dem åtgärdar i sig saknat underlag. Vilken sammanställning som passar beror på vad utvärderingen ska mäta.
För en uppgiftsmängd som du själv utformar visar guiden för agentutvärdering hur du definierar observerbara kontroller och tolkar upprepade försök.
Anteckna den exakta versionen av varje indatafil
En revisionslåst uppgiftstabell låser inte nödvändigtvis varje fil som en utvärderare laddar ned. I en tidigare offentlig GDPval-tabell vid revision 4bf6426 listar 122 av 220 uppgiftsrader indatafiler. Alla 262 listade indata-URL:er pekar på förvarets föränderliga main-gren. Leverantörens metadata visar att 62 av samma sökvägar hade andra storlekar och blob-ID:n vid revision 11e7900. Dessa 62 sökvägar förekommer i 20 av raderna i den tidigare tabellen. Det här är uppgiftsindata, skilda från de expertreferensutdata i deliverable_files som räknats ovan.
Detta visar inte att en viss utvärdering använde ändrade indata, att en fil är korrupt eller att en poäng ändrades. Det visar varför en annan version av indata kan väljas om man senare följer de föränderliga URL:erna i en sparad tabell. Vi analyserade inte indatafilernas innehåll.
I kodversion 5c092d5 av Inspect Evals låser GDPval-inläsaren sin uppgiftstabell till revision a3848a2. Tabellen är byteidentisk med den tidigare tabellen ovan och leverantörens metadata för indatafilerna stämmer också överens. Inläsaren mappar parade tabell-URL:er till filmappningar för exempel. Inspects dokumentation säger att dessa mappningar kan använda URL:er. Denna källväg kan därför bära med sig föränderliga URL:er tillsammans med en fast tabell. Vi testade inte Inspects filnedladdningar eller cachning och fastställde inte vad någon körning använde.
En utvärderare kan i stället slå upp datasetrelaterade sökvägar vid samma oföränderliga revision som tabellen. Den gbench-implementation som granskats här anger uttryckligen sin låsta revision när den hämtar bilagor. Dokumentera revisionen och verifiera, där det är praktiskt möjligt, de filer som faktiskt användes. Hugging Faces nedladdningsdokumentation förklarar hur en föränderlig revision kan översättas till en commit för konsekventa nedladdningar.
Analysskriptet för indata-URL:er återskapar antalen med DuckDB 1.4.4. Det laddar tillfälligt ned den tidigare uppgiftstabellen, tar bort den efter en normal körning och sparar ingen uppgiftstext, enskilda ID:n, indatasökvägar eller indatainnehåll i sina utdata. En valfri flagga kontrollerar svarshuvudena för en sökväg och den aktuella main-revisionen. Resultatet kan ändras när main ändras. För den kontrollen skickar skriptet endast HEAD-förfrågningar, även genom omdirigeringar, och resultat som inte är tillgängliga observeras inte. Kontrollerna med Pythons standardbibliotek jämför tabellen och metadata som Inspect låst till en revision och granskar den revisionslåsta inläsarens källkod utan att köra den. Kontroll av tabellens hash läser in hela tabellen i minnet men tolkar eller sparar inte dess uppgiftsinnehåll. Skripten begär inte indatafilernas innehåll.
Efter installationen av DuckDB nedan kör du kontrollerna på macOS eller Linux med:
.gdpval-venv/bin/python input-url-revisions.py > input-url-observations.json
.gdpval-venv/bin/python inspect-dataset-check.py
.gdpval-venv/bin/python inspect-source-check.py
Så räknade vi
För kartläggningen av referenstillgång granskade vi Parquet-tabellen train vid GDPval-revision 11e7900cdcac61bc4daf59e65feb238acda98fbf, verifierade 220 unika uppgifts-ID:n och grupperade endast sektor, yrke och längden på varje deliverable_files-lista. Analysskriptet kontrollerar källans hash och återskapar antalen med DuckDB 1.4.4. Det laddar tillfälligt ned hela tabellen och tar bort den efter en normal körning. Dess utdata innehåller inga promptar, bedömningsmatriser, enskilda uppgifts-ID:n, leveranssökvägar eller leveranser. Ingen modell, inget benchmark och ingen referensrenderare kördes.
För att återskapa resultatet lokalt med Python 3.9 eller senare på macOS eller Linux, kontrollera att python3 väljer den versionen:
python3 -m venv .gdpval-venv
.gdpval-venv/bin/python -m pip install duckdb==1.4.4
.gdpval-venv/bin/python analyze.py > observations.json
sapien1 gör dessa skript tillgängliga för nedladdning och lokal körning. Ingen ytterligare licens för att ändra eller vidareförmedla dem anges. Källdatasetets villkor är separata.
OpenAI beskriver gulddelmängden med 220 uppgifter som öppen källkod. Det revisionslåsta datasetkortet innehåller en canary-markör för benchmarken och saknar licensfält. Kontrollera vilka villkor som gäller för din egen användning i stället för att dra slutsatser från en etikett på kortet eller från detta antal. Sektor- och yrkesbeteckningarna samt benchmarken tillskrivs fortsatt sin källa.