Recherche
Le filtrage par fichier de référence modifie la répartition publique des tâches de GDPval
Langue: Français
Un score de benchmark est plus facile à interpréter lorsque l’on sait quelles tâches peuvent y contribuer. Dans la table publique des tâches gold de GDPval, chacun des 44 métiers compte initialement cinq tâches. Mais une comparaison qui exige un fichier de référence expert répertorié ne peut pas utiliser toutes les lignes de cette table de la même façon : 35 des 220 lignes présentent une liste deliverable_files vide.
Ce total est déjà documenté par l’implémentation GDPval de gbench. Nous avons compté la répartition de ces listes vides par secteur et par métier dans le même instantané GDPval à révision fixe. Les 44 métiers comptent toujours au moins une ligne avec un fichier répertorié. Mais la répartition restante est moins uniforme que celle de la table initiale.
Quelles tâches mentionnent un fichier de référence produit par un expert ?
Ces décomptes indiquent uniquement si la table répertorie au moins un chemin vers un livrable expert. Un chemin répertorié ne prouve pas que le fichier est accessible ou peut être rendu. Une liste vide ne permet pas de déterminer si une référence existe ailleurs qu’au sein de cette table.
| Secteur | Lignes de la table gold publique | Avec un livrable répertorié | Avec une liste vide |
|---|---|---|---|
| Finance et assurance | 25 | 17 | 8 |
| Administration publique | 25 | 22 | 3 |
| Santé et assistance sociale | 25 | 22 | 3 |
| Information | 25 | 14 | 11 |
| Industrie manufacturière | 25 | 25 | 0 |
| Services professionnels, scientifiques et techniques | 25 | 24 | 1 |
| Immobilier, location et crédit-bail | 25 | 20 | 5 |
| Commerce de détail | 20 | 16 | 4 |
| Commerce de gros | 25 | 25 | 0 |
| Total | 220 | 185 | 35 |
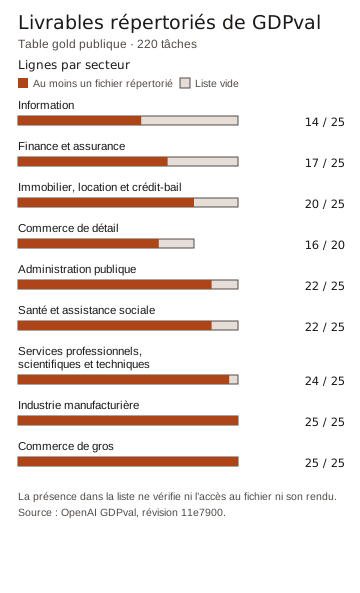
Les barres indiquent la présence dans la liste, et non une vérification de l’accès au fichier ou de son rendu.
La table contient 44 groupes métier-secteur de cinq tâches chacun. Parmi eux, 22 conservent leurs cinq lignes à cette étape et 22 en conservent entre deux et quatre. Chaque métier reste représenté, mais cette présence ne signifie plus que chacun compte le même nombre de tâches.
La comparaison entre secteurs aide à interpréter un résultat agrégé. L’information et l’industrie manufacturière représentent chacune 25 des 220 lignes initiales, soit 11,4 %. Dans une synthèse hypothétique pondérant également chacune des 185 tâches dont la liste contient un fichier, l’information représenterait 14/185, soit 7,6 %, et l’industrie manufacturière 25/185, soit 13,5 %. Il s’agit de parts de tâches, et non de scores de modèles ou d’estimations de la valeur des différents métiers.
Le système de notation peut-il lire les fichiers de référence ?
Le calcul portant sur 185 lignes ne correspond pas au dénominateur final utilisé pour le score de gbench. Sa documentation décrit quatre autres tâches dont les livrables répertoriés ne peuvent pas être rendus sous forme de texte, ce qui laisse 181 tâches dont la référence peut être rendue dans cet instantané. Nous n’avons pas effectué de rendu indépendant de ces fichiers ni exécuté gbench.
Même sans connaître les secteurs auxquels appartiennent ces quatre tâches, les décomptes permettent de borner utilement l’ensemble documenté des tâches dont la référence peut être rendue. S’il s’agit de quatre lignes distinctes parmi les 185 dont la liste contient un fichier, il reste au moins 21 lignes pour l’industrie manufacturière et au plus 14 pour l’information. Avec une pondération égale des tâches, ces limites sont respectivement de 21/181 (11,6 %) et de 14/181 (7,7 %). Le dénominateur effectivement utilisé pour le score peut différer lors d’une exécution, car les échecs de génération, les échecs du juge et le nombre de tentatives par tâche comptent également. Ces décomptes ne décrivent pas les résultats originaux de GDPval évalués par des humains pour OpenAI.
D’autres méthodes d’évaluation ont des exigences différentes. Dans le mode grille d’évaluation documenté de NeMo Gym au commit 5d6429f, un LLM juge évalue un livrable candidat à partir de la grille de la tâche. Son code de préparation ne copie pas la liste deliverable_files des sorties expertes, tandis que son vérificateur de grille renvoie missing_rubric si les deux champs de grille sont vides. Tous les fichiers d’entrée de la tâche répertoriés doivent être préparés, et une sortie candidate ainsi qu’un juge restent nécessaires ; l’appel de préparation ne fixe pas la révision du jeu de données. Nous n’avons pas exécuté NeMo Gym ni mesuré sa couverture. Son score fondé sur la grille et le taux de victoires ou d’égalités de gbench sont des mesures différentes.
Ce que le juge peut voir
La disponibilité des références n’est qu’un aspect de la comparaison. La documentation de gbench indique déjà que 32 des 220 grilles dépassent sa limite par défaut de 8 000 caractères. Son outil de mise en forme conserve les critères entiers dans leur ordre d’origine jusqu’à ce que l’ajout du suivant dépasse la limite, puis ajoute un marqueur de troncature ; si le premier critère dépasse à lui seul la limite, il n’en affiche qu’une partie. Le nombre de caractères ne correspond pas au nombre de jetons.
Nous avons appliqué cet outil de mise en forme à révision fixe à la table des tâches. Parmi les 185 lignes avec un livrable expert répertorié, 26 grilles seraient tronquées avec la limite par défaut, omettant au total 247 critères entiers. Un livrable répertorié ne peut pas nécessairement être rendu, et des générations échouées ou vides peuvent empêcher l’appel au juge : ces chiffres ne dénombrent donc pas des comparaisons évaluées. À titre d’illustration, si seule la limite de l’outil de mise en forme passait à 12 000 ou 16 000 caractères, respectivement deux ou zéro de ces 185 grilles seraient tronquées. Nous n’avons pas testé ces réglages avec un évaluateur ou un juge. Le nombre de critères omis ne permet pas d’établir leur importance ni de savoir si un verdict changerait ; une limite plus élevée peut laisser moins de place au reste d’une fenêtre de contexte de taille fixe. Examinez les informations de troncature enregistrées lors de l’exécution effective, ainsi que ses décomptes de références et de scores.
Le filtre des grilles reproduit ces décomptes avec DuckDB 1.4.4. Il télécharge temporairement la table complète des tâches à révision fixe et traite le texte des grilles en mémoire ; sa sortie ne conserve que des décomptes agrégés, sans identifiants de tâches ni texte de grille. Il supprime la table temporaire après une exécution normale. Il exécute uniquement l’outil de mise en forme de gbench qui a été inspecté et vérifié par hachage, dans un espace de noms restreint qui ne constitue pas un bac à sable de sécurité. L’archive comprend la licence et l’avis du projet d’origine. Après la configuration de DuckDB ci-dessous, utilisez Python 3.11 pour créer l’environnement, télécharger l’archive et l’exécuter sous macOS ou Linux :
unzip rubric-screen.zip -d rubric-screen
.gdpval-venv/bin/python rubric-screen/rubric-screen.py > rubric-observations.json
Consigner le parcours des tâches aux scores
Lors de la configuration ou de la comparaison d’une évaluation, consignez la révision du jeu de données, le type de référence requis et chaque règle d’admissibilité. Indiquez les décomptes par groupe dans la table initiale, après les vérifications des références et après l’attribution des scores. Distinguez les motifs suivants : référence non répertoriée, référence illisible, génération échouée et verdict du juge inutilisable. Un résultat agrégé unique peut sinon masquer les tâches qui ont cessé de contribuer au résultat.
Précisez également comment les tâches et les tentatives restantes sont pondérées. Une pondération égale par tâche, par métier ou par tentative répond à des questions différentes lorsque les décomptes varient. Aucune ne compense à elle seule les éléments manquants ; la synthèse appropriée dépend de ce que l’évaluation vise à mesurer.
Pour un ensemble de tâches que vous concevez vous-même, le guide d’évaluation des agents montre comment définir des vérifications observables et interpréter des essais répétés.
Notez la version exacte de chaque fichier d’entrée
Une table de tâches à révision fixe ne fixe pas nécessairement la version de chaque fichier téléchargé par un évaluateur. Dans une table publique antérieure de GDPval à la révision 4bf6426, 122 des 220 lignes de tâches répertorient des fichiers d’entrée. Les 262 URL de fichiers d’entrée répertoriées pointent toutes vers la branche évolutive main du dépôt. Les métadonnées du fournisseur indiquent que 62 de ces mêmes chemins avaient des tailles et des identifiants de blob différents à la révision 11e7900 ; ces 62 chemins figurent dans 20 lignes de la table antérieure. Il s’agit de fichiers d’entrée des tâches, distincts des sorties expertes de référence dans deliverable_files comptabilisées ci-dessus.
Cela ne démontre pas qu’une évaluation particulière a utilisé un fichier d’entrée modifié, qu’un fichier est corrompu ou qu’un score a changé. Cela montre pourquoi l’utilisation ultérieure des URL évolutives d’une table enregistrée peut sélectionner une autre version d’un fichier d’entrée. Nous n’avons pas analysé le contenu des fichiers d’entrée.
Au commit 5c092d5 d’Inspect Evals, le chargeur GDPval fixe sa table de tâches à la révision a3848a2. Cette table est identique octet pour octet à la table antérieure ci-dessus, et les métadonnées des fichiers d’entrée du fournisseur correspondent également. Le chargeur associe les URL appariées de la table à des correspondances de fichiers pour les échantillons ; la documentation d’Inspect indique que ces correspondances peuvent utiliser des URL. Ce cheminement peut donc véhiculer des URL évolutives avec une table fixe. Nous n’avons pas testé les téléchargements de fichiers ni la mise en cache d’Inspect, et nous n’avons pas établi ce qu’une exécution a utilisé.
Un évaluateur peut aussi résoudre les chemins relatifs au jeu de données à la même révision immuable que sa table. L’implémentation de gbench examinée ici fournit explicitement sa révision fixe lors de la récupération des pièces jointes. Consignez la révision et, lorsque cela est possible, vérifiez les fichiers effectivement utilisés. La documentation de téléchargement de Hugging Face explique comment résoudre une révision évolutive en un commit pour obtenir des téléchargements cohérents.
Le script d’analyse des URL d’entrée reproduit les décomptes avec DuckDB 1.4.4. Il télécharge temporairement la table de tâches antérieure, la supprime après une exécution normale et ne conserve dans sa sortie aucun texte de tâche, identifiant individuel, chemin d’entrée ou contenu de fichier d’entrée. Une option facultative vérifie les en-têtes de réponse d’un chemin et la révision actuelle de main ; son résultat peut changer lorsque main évolue. Pour cette vérification, le script envoie uniquement des requêtes HEAD, y compris lors des redirections, et ne permet pas d’observer les résultats indisponibles. Les vérifications utilisant la bibliothèque standard de Python comparent la table et les métadonnées fixées par Inspect et examinent le code source du chargeur à révision fixe sans l’exécuter. La vérification du hachage lit la table complète en mémoire, mais n’analyse ni ne conserve le contenu de ses tâches. Les scripts ne demandent pas le corps des fichiers d’entrée.
Après la configuration de DuckDB ci-dessous, exécutez les vérifications sous macOS ou Linux avec :
.gdpval-venv/bin/python input-url-revisions.py > input-url-observations.json
.gdpval-venv/bin/python inspect-dataset-check.py
.gdpval-venv/bin/python inspect-source-check.py
Notre méthode de comptage
Pour le recensement de la disponibilité des références, nous avons examiné la table Parquet train à la révision GDPval 11e7900cdcac61bc4daf59e65feb238acda98fbf, vérifié la présence de 220 identifiants de tâches distincts et effectué des regroupements uniquement par secteur, métier et longueur de chaque liste deliverable_files. Le script d’analyse vérifie le hachage de la source et reproduit les décomptes avec DuckDB 1.4.4. Il télécharge temporairement la table complète et la supprime après une exécution normale ; sa sortie ne conserve aucun prompt, grille, identifiant individuel de tâche, chemin de livrable ou livrable. Aucun modèle, benchmark ou outil de rendu des références n’a été exécuté.
Pour reproduire ces résultats localement avec Python 3.9 ou une version ultérieure sous macOS ou Linux, assurez-vous que python3 sélectionne cette version :
python3 -m venv .gdpval-venv
.gdpval-venv/bin/python -m pip install duckdb==1.4.4
.gdpval-venv/bin/python analyze.py > observations.json
sapien1 met ces scripts à disposition pour téléchargement et exécution en local ; aucune licence supplémentaire autorisant leur modification ou leur redistribution n’est indiquée. Les conditions applicables au jeu de données source sont distinctes.
OpenAI décrit le sous-ensemble gold de 220 tâches comme open source. La fiche du jeu de données à révision fixe contient un marqueur canari de benchmark et aucun champ de licence ; vérifiez les conditions applicables à votre propre usage sans les déduire d’une mention sur la fiche ou de ce décompte. Les libellés des secteurs et des métiers ainsi que le benchmark restent attribués à leur source.