Recherche
Un jeu d’épisodes LeRobot réservé à l’évaluation peut utiliser des statistiques de normalisation plus larges
Langue: Français
Une équipe peut réserver des épisodes robotiques à l’évaluation tout en utilisant des statistiques de prétraitement couvrant plus que les épisodes d’entraînement. Nous avons examiné un parcours d’entraînement LeRobot et vérifié un instantané public de métadonnées. Dans une partition hypothétique de 40 épisodes d’entraînement et 10 épisodes d’évaluation, les plages enregistrées de l’état et de l’action dépassent chacune celles des épisodes d’entraînement dans trois dimensions sur six. Il s’agit d’une comparaison de métadonnées enregistrées, et non d’une exécution d’entraînement observée ni d’un résultat de performance du modèle. Cet exemple montre pourquoi l’examen d’un jeu réservé à l’évaluation doit porter aussi bien sur les statistiques fournies au processeur que sur la liste des épisodes.
La partition et les statistiques relèvent de décisions distinctes
Au commit LeRobot 7910c20, lorsqu’un eval_split est défini, les épisodes sélectionnés sont regroupés selon leur première tâche répertoriée, puis les ceil(group size × eval_split) derniers épisodes de chaque groupe sont affectés à l’évaluation. La configuration par défaut ne prévoit pas de partition d’évaluation ; l’exemple ci-dessous en définit volontairement une. Le code construit des objets de jeu de données distincts pour l’entraînement et l’évaluation à partir de listes d’épisodes, de la même racine de jeu de données et de la même révision.
Le chargeur de métadonnées du jeu de données charge séparément meta/stats.json. Dans le parcours d’entraînement examiné, une nouvelle politique Diffusion, non reprise et sans chemin vers un processeur préentraîné, reçoit les statistiques des métadonnées du jeu de données lors de la construction de ses processeurs. La configuration Diffusion par défaut utilise une normalisation min-max pour l’état et l’action. L’analyse du code source concerne cette configuration et cette version ; d’autres politiques, paramètres remplacés, processeurs préentraînés ou repris, formats et versions peuvent se comporter différemment.
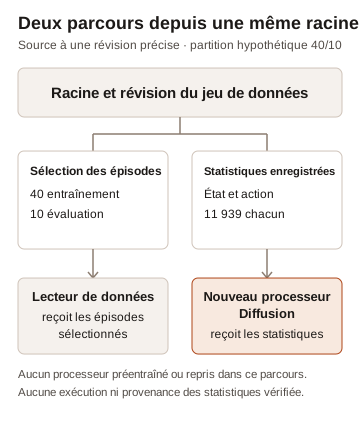
Nous n’avons exécuté ni le chargeur de données ni une politique. Le schéma décrit le parcours du code source examiné dans les conditions indiquées ; il ne rend pas compte d’une exécution réelle.
Un exemple de métadonnées
L’instantané public lerobot/svla_so101_pickplace à la révision f641879 décrit 50 épisodes et 11 939 images. Les 50 enregistrements d’épisodes partagent la même clé de regroupement de première tâche. Si aucun épisode n’est présélectionné ou exclu et si eval_split=0.2, la règle examinée affecterait 40 épisodes à l’entraînement et 10 à l’évaluation. Leurs résumés d’épisodes déclarent respectivement 9 180 et 2 759 images.
Les statistiques enregistrées pour observation.state et action indiquent chacune un décompte de 11 939. Leurs tableaux min/max correspondent à l’agrégat des résumés des 50 épisodes dans une tolérance absolue et relative de 1e-6. Comparées directement aux extrema agrégés des 40 épisodes d’entraînement hypothétiques, les plages enregistrées sont plus étendues dans trois dimensions sur six pour chaque variable. Ce nombre reste inchangé lorsqu’on exige une différence supérieure à la tolérance de math.isclose, avec des tolérances relative et absolue de 1e-6.
| Variable | Dimensions où la plage enregistrée dépasse celle des épisodes d’entraînement | Plage la plus étroite des épisodes d’entraînement en proportion de la plage enregistrée |
|---|---|---|
observation.state | 3 sur 6 | 84,3 % |
action | 3 sur 6 | 84,2 % |
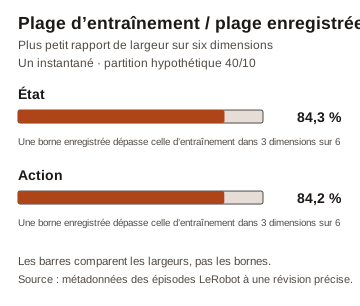
Chaque pourcentage représente le plus petit rapport de largeur de plage parmi les six dimensions de la variable ; les deux lignes ne décrivent pas nécessairement la même dimension. Les barres comparent les largeurs, et non le début ou la fin des plages. Le calcul sur 40 épisodes inclut toutes les images déclarées pour ces épisodes. Un échantillonneur réel peut écarter des images de fin, échantillonner des fenêtres ou appliquer d’autres règles de sélection ; ce calcul ne mesure donc pas les positions utilisées par un optimiseur réel.
Les résumés des épisodes réservés à l’évaluation étendent aussi l’agrégat de tous les épisodes au-delà de celui des 40 épisodes d’entraînement dans trois dimensions pour chaque variable. Les statistiques enregistrées correspondent à l’agrégat de tous les épisodes dans la tolérance indiquée, mais nous n’avons pas établi indépendamment comment le fichier enregistré a été produit ni vérifié les fichiers d’images sous-jacents. Si ces plages enregistrées sont fournies au nouveau processeur min-max décrit plus haut, les bornes plus larges peuvent en modifier l’échelle. L’exemple ne montre pas ce qu’une tâche antérieure a chargé, si un jeu de données convient à une politique ou si un score a changé.
Vérifier le périmètre d’un recalcul
La recommandation habituelle consiste à ajuster le prétraitement dépendant des données sur le jeu d’entraînement, puis à appliquer de façon cohérente la transformation obtenue aux données d’évaluation. La présentation des fuites de données par scikit-learn explique ce principe général. Un signalement LeRobot antérieur soulevait également des inquiétudes concernant les statistiques globales et la validation ; notre vérification ne confirme pas le comportement du robot rapporté dans ce signalement et n’en diagnostique pas la cause. Une autre fiche de jeu de données SO-101 distingue déjà les statistiques calculées uniquement sur l’entraînement des métadonnées du jeu de données complet pour une évaluation contrôlée. Nous n’avons pas vérifié les décomptes ni les fichiers propres à ce jeu de données.
Examinez le parcours de recalcul aussi attentivement que la partition. Dans la version à la révision précise, la fonction utilitaire recompute_stats utilise par défaut un parcours de données numériques qui parcourt les fichiers Parquet sous la racine du jeu de données et leurs indices d’épisodes sans filtre direct sur dataset.episodes. Si ces fichiers contiennent encore les deux partitions, le seul passage d’un objet avec une sélection d’épisodes ne garantit pas que les statistiques numériques portent uniquement sur l’entraînement. La fonction écrit les statistiques à cette racine et conserve les statistiques existantes des variables qu’elle ne recalcule pas ; par défaut, elle ignore les variables d’image et de vidéo. Nous n’avons pas exécuté la fonction ni modifié de jeu de données. Sa docstring indique déjà qu’elle parcourt tous les épisodes, et le guide des outils de jeu de données décrit l’opération de recalcul.
Avant de considérer comme indépendant un résultat obtenu sur un jeu réservé à l’évaluation, consignez les identifiants des épisodes sélectionnés, la révision du jeu de données, l’origine et les variables couvertes par chaque statistique, ainsi que la configuration du processeur effectivement utilisée. Vérifiez qu’un calcul proposé sur les seules données d’entraînement lit les lignes prévues, puis réutilisez la transformation appropriée issue de l’entraînement pour l’évaluation. Vérifiez séparément les variables d’image, de vidéo et d’action relative, qui peuvent suivre des parcours différents. Un processeur préentraîné ou repris peut disposer de ses propres statistiques enregistrées ; examinez donc le point de contrôle et les paramètres remplacés effectivement utilisés avant de supposer que son comportement correspond à cet exemple.
Notre méthode de vérification
Nous avons lu le code source à la révision précise sans importer ni exécuter LeRobot. Notre script d’analyse vérifie les empreintes du code source, télécharge temporairement la petite table de métadonnées et calcule la partition hypothétique ainsi que les comparaisons min/max avec DuckDB 1.4.4. Il supprime la table temporaire après une exécution normale. Les résultats agrégés ne conservent aucun libellé de tâche, identifiant d’épisode individuel ni statistique par épisode. Le paquet de vérification du code source contient un script qui vérifie certaines structures du code source à la révision précise sans exécuter le code d’origine, ainsi que la licence et l’attribution correspondantes. Le générateur de figures reproduit les deux schémas à partir des données agrégées. Aucun enregistrement, image brute, modèle, ni aucune tâche d’entraînement ou de benchmark n’ont été utilisés.
Pour reproduire ces résultats sur macOS ou Linux avec Python 3.11 et DuckDB 1.4.4 :
python3.11 -m venv .lerobot-stats-venv
.lerobot-stats-venv/bin/python -m pip install duckdb==1.4.4
.lerobot-stats-venv/bin/python analyze.py > observations-reproduced.json
unzip source-check.zip -d lerobot-source-check
.lerobot-stats-venv/bin/python lerobot-source-check/source-check.py
La fiche du jeu de données à la révision précise le présente sous licence Apache-2.0 ; cette indication ne détermine pas les droits applicables à chaque ressource sous-jacente. Le vérificateur du code source fait référence à de courtes expressions tirées de LeRobot ; sa licence à la révision précise et l’attribution des droits d’auteur figurent dans le paquet du vérificateur. sapien1 met ses contributions originales au script à disposition pour téléchargement et exécution locale ; aucune licence supplémentaire de modification ou de redistribution de ces contributions n’est indiquée. Les conditions du jeu de données source et celles du code d’origine sont distinctes.