Forskning
Dette bør du forberede før du lisensierer bedriftens data
Språk: Norsk bokmål
En nyttig første henvendelse forklarer hvem som har kontroll over dataene, hva de inneholder og hvordan de kan vurderes. En gjennomgang av ti offentlige programmer for dataleverandører viste ulike første steg: et interesseskjema, en konto, en forespørsel om oppføring, en møteforespørsel eller et estimat. Åtte programmer hadde lesbar informasjon om forberedelser. De publiserte prosessene viser hvorfor opplysningene som trengs for å starte en samtale, kan være andre enn dem som trengs for vurdering eller oppføring.
For en bedrift som vurderer sitt første datapartnerskap, er resultatet et kort forberedelsesnotat. Beskriv bedriften og beslutningstakerne, datasettet og historikken, samt tillatelser og begrensninger som må avklares. Legg til detaljer etter hvert som leverandørens vurdering går videre.
Det første skjemaet viser hvor samtalen begynner
Det første offentlige steget kan se enkelt ut, selv om leverandøren beskriver en grundigere vurdering senere.
Neudatas oppføringsside beskriver en første forespørsel med bedrifts- og kontaktopplysninger. En analytiker må godkjenne forespørselen før oppføringen utarbeides. I den publiserte prosessen kommer et spørreskjema for aktsomhetsvurdering eller en risikosjekk etter godkjenningen. Den som bare forbereder seg til det første skjemaet, vil ikke få med seg produktbeskrivelsen og aktsomhetsvurderingen som følger. Neudatas oppføringsprosess
Defined.ais offentlige prosess starter med å opprette en Jira-konto. Senere faser omfatter kommersielle muligheter, datakvalitet, volum, organisering, metadata, lisensrettigheter og etterlevelse. Kontosteget sier derfor i seg selv lite om materialet en datapart bør være klar til å diskutere. Defined.ais partnerskapsprogram
Andre programmer stiller spørsmål om datasettet i det offentlige skjemaet. OpenAI spør om datatype, anslått størrelse med enhet, format, rettigheter til å dele og hvilken hjelp som trengs for å klargjøre dataene. Shutterstock spør om hva slags innhold søkeren har kontroll over, og hvor stort biblioteket er. OpenAIs interesseskjema, Shutterstocks Data Partner Network
Forskjellen har betydning for forberedelsene. Bruk det første skjemaet til å finne neste steg, og les deretter leverandørens beskrivelse av vurdering og oppstart. En kontaktforespørsel, en godkjent oppføring og en avtalt lisens er ulike utfall.
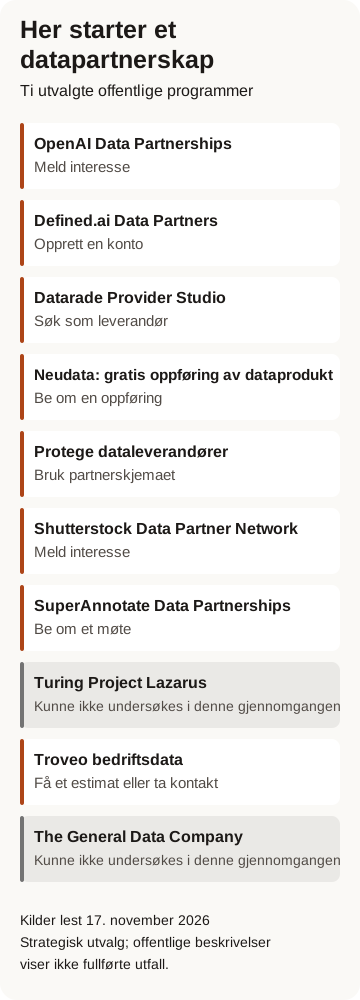
Offentlige innganger lest 17. november 2026. Kasustabellen knytter hver observasjon til kilden.
Beskriv datasettet med enheter som forklarer innholdet
«Vi har flere terabyte» etterlater viktige spørsmål ubesvart. En beskrivelse bør gjøre det mulig for mottakeren å forstå hva disse bytene representerer, og om postene har nyttig kontekst.
OpenAI-skjemaet vi undersøkte, ber uttrykkelig om enheter for anslått størrelse og bruker ord og timer som eksempler. Shutterstocks felt for bibliotekstørrelse passer for en innholdssamling. Dette er ulike måter å beskrive omfang på, så ett enkelt tall for lagringsstørrelse vil neppe dekke alle henvendelser. OpenAIs skjema, Shutterstocks skjema
Driftsdata trenger en annen type beskrivelse. Troveos side om bedriftsdata omtaler systemer, teamstørrelse og driftshistorikk, og beskriver sammenhenger i samtaler, dokumentmetadata og prosjekthistorikk. SuperAnnotates eksempler omfatter kommunikasjon, prosessdokumenter, beslutninger, fagspesifikke data og dokumentert arbeid. Begge sidene gjør arbeidet som postene representerer, til en del av beskrivelsen. Troveos side om bedriftsdata, SuperAnnotates datapartnerskap
Noter innholdstype, omtrentlig mengde, tidsrom og kildesystemer i et første notat. Ta med konteksten som gjør postene forståelige: om meldinger fortsatt er knyttet til trådene sine, om dokumenter har versjonshistorikk, eller om et datasett inneholder en feltbeskrivelse. Neudatas offentlige veiledning anbefaler spesielt støttemateriell som dataordbøker for å forklare et dataprodukt. Neudatas leverandørveiledning
Her er et fiktivt eksempel på en nyttig beskrivelse:
Et arkiv med vedlikeholdsdata for utstyr over tre år, med omtrent 80 000 arbeidsordrer. Hver post knytter sammen en rapportert feil, inspeksjonsnotater, utført reparasjon og sluttstatus. Arkivet kan eksporteres som strukturerte tabeller med en feltbeskrivelse. Vedlegg og identifiserende felt er ennå ikke vurdert for inkludering.
Skill mellom kontroll over filene og tillatelse til å lisensiere dem
Forbered en tydelig redegjørelse for hvor dataene kommer fra, og hvem som kan godkjenne den foreslåtte bruken. Hold uavklarte tillatelser synlige, slik at de kan tas opp i samtalen.
OpenAIs interesseskjema spør om søkeren har rett til å dele dataene. Datarades leverandørside beskriver kommersialiseringsrettigheter og begrensninger knyttet til personopplysninger som forhold som vurderes for å avgjøre om en leverandør kvalifiserer. Defined.ai beskriver kontroll av lisensrettigheter og etterlevelse som en del av vurderingen. Dette er offentlige krav eller spørsmål fra disse programmene; å svare på et skjema fastslår ikke at et datasett er juridisk klarert. OpenAIs skjema, Datarades leverandørkrav, Defined.ais vurderingsprosess
Forberedelsesnotatet kan identifisere den foreslåtte lisensgiveren, hvordan dataene ble opprettet eller innhentet, relevante avtaler og begrensninger teamet allerede kjenner til. Det kan også angi hvem som må avklare gjenstående spørsmål. Hold beskrivelsen atskilt fra en påstand om at alle rettigheter er kontrollert.
Omfanget har også betydning. Den tiltenkte datapakken kan omfatte én tidsperiode, ett system eller én samling, snarere enn alt organisasjonen har. En beskrivelse av de foreslåtte grensene gjør neste samtale mer konkret. Den bidrar også til å skille et representativt utvalg fra en fullstendig overføring.
Bruk et kort notat, og legg deretter til dokumentasjonen som etterspørres
Arbeidsarket grupperer spørsmålene vi observerte, i tre praktiske deler. Denne inndelingen er vår sammenfatning av pilotstudien.
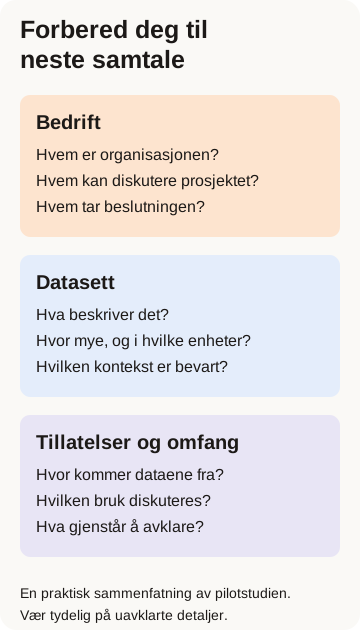
| Del | Dette bør du forberede |
|---|---|
| Bedrift og beslutningstakere | Organisasjon, fagområde, relevant driftshistorikk, kontaktperson og ansvarlig for det foreslåtte partnerskapet |
| Datasett og klargjøring | Innholdstyper, omtrentlige mengder med enheter, tidsrom, systemer, formater, tilgjengelige metadata og arbeid som trengs for vurdering |
| Tillatelser og omfang | Datasettet sin kilde, foreslått lisensgiver, kjente begrensninger, tillatt bruk som skal diskuteres, og uavklarte spørsmål om godkjenning |
Bruk «ukjent» der en opplysning er uavklart. Et estimat bør inneholde enhet og forklare hvordan det ble beregnet. En uttalelse om rettigheter bør angi grunnlaget for den, fremfor å betrakte besittelse av filene som bevis.
For eksempel er «omtrent 4 000 timer, anslått ut fra mediebibliotekets indeks» mer nyttig enn «stort videoarkiv». «Teamet vårt må gjennomgå bidragsyteravtalene for denne bruken» er mer nyttig enn en udokumentert erklæring om at hele arkivet er klarert.
Neste steg avhenger av programmet. SuperAnnotate beskriver en samtale for å avklare omfang, etterfulgt av vurdering av et utvalg. Datarade beskriver vurdering av søknaden før profilopprettelse og publisering av produkter. Spør hva som trengs til neste vurdering, og bruk den avtalte prosessen for alt materiale du leverer. SuperAnnotates beskrevne prosess, Datarades søknadsprosess
Last ned arbeidsarket for forberedelser. Med observasjonene og analyseskriptet kan leserne undersøke koblingen til kildene og reprodusere opptellingene i pilotstudien.
Slik gjennomførte vi pilotstudien
Vi valgte ut ti programmer for å dekke ulike typer offentlige innganger: OpenAI, Defined.ai, Datarade, Neudata, Protege, Shutterstock, SuperAnnotate, Turing Lazarus, Troveo og The General Data Company. Dette var et bevisst utvalg av ulike tilfeller, ikke et tilfeldig eller fullstendig utvalg av datakjøpere.
Den 17. november 2026 leste vi offisielle engelskspråklige programsider og relevante offentlige forklaringer gjennom nettsideuttrekk. Åtte ga innholdsrik informasjon om forberedelser eller innledende faser. Selve programinnholdet til Turing Lazarus og partnerskapsinngangen til The General Data Company kunne ikke leses med denne metoden. De står fortsatt som ukjente i datasettet. Proteges innebygde skjema og Neudatas lenkede skjema kunne heller ikke leses, selv om de offentlige sidene beskrev inngangene.
Vi skrev ikke inn personopplysninger, opprettet ikke kontoer, sendte ikke inn søknader, lastet ikke opp data og testet ikke feltvalidering. Offentlige uttalelser beskriver hva leverandørene sier; de dokumenterer ikke fullførte vurderinger, godkjenning, transaksjonspriser eller resultater for kunder. Søkeresultater kan bygge på indekserte kopier, og sider kan endre seg. Den fullstendige metodebeskrivelsen og kasustabellen viser hva som ble undersøkt, og hver begrensning i tilgangen.
For hjelp til å avgrense et mulig dataprosjekt, se levering av data til sapien1.