Cercetare
Setările de resurse pentru 66 de sarcini din Terminal-Bench
Limbă: Română
Terminal-Bench v4.1.0 declară setări de resurse diferite pentru cele 66 de sarcini. În analiza fișierelor de configurare, 31 de sarcini specifică peste 4.096 MB de memorie, iar 22 specifică mai mult de două procesoare. Am alcătuit o configurație de comparație din cele mai frecvente valori explicite pentru procesoare, memorie, stocare și GPU-uri. În 38 de sarcini, cel puțin o valoare declarată depășește valoarea corespunzătoare din această configurație. Diferențele arată ce setări merită păstrate sau documentate când o echipă pregătește medii izolate pentru evaluare. Ele nu prezic consumul de resurse sau eșecul unei sarcini.
Ce condiții se păstrează când rulezi același benchmark într-un mediu nou? Răspunsul depinde de versiunile sarcinii și ale programului de rulare, de opțiunile care înlocuiesc valorile și de regulile mediului de execuție.
Versiunea cuprinde sarcini cu valori de resurse diferite
Am examinat toate sarcinile din manifestul oficial Terminal-Bench v4.1.0, publicat pe 3 noiembrie 2026. Analiza acoperă toate cele 66 de sarcini ale versiunii, fiecare cu un fișier task.toml într-o revizie fixă a sursei. Depozitul conține și sarcini mai vechi și fișiere auxiliare de testare care nu intră în analiză. Versiunea și manifestul oficial
Valorile declarate pentru mediul principal variază de la 2 la 16 procesoare și de la 4.096 la 32.768 MB de memorie. Valoarea cea mai frecventă este de două procesoare, în 44 de sarcini. Pentru memorie, cea mai frecventă valoare este 4.096 MB, în 35 de sarcini. Restul sarcinilor au valori mai mari.
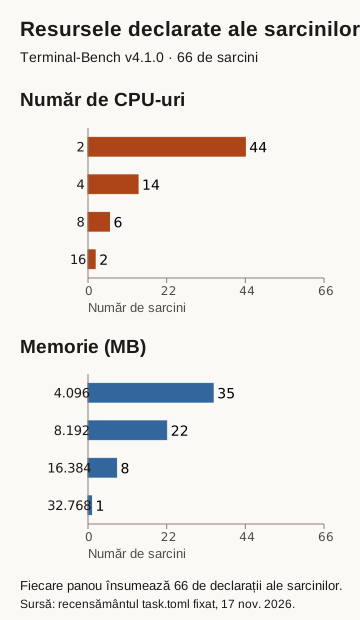
Ambele panouri acoperă aceleași 66 de medii ale sarcinilor. Valorile provin din fișierele de configurare ale versiunii. Datele complete includ pentru fiecare sarcină o adresă care fixează revizia și amprenta criptografică a fișierului sursă.
Diferențele contează atunci când o echipă își standardizează infrastructura. Un mediu uniform poate simplifica planificarea, dar modifică unele condiții declarate dacă programul de rulare nu aplică setările specifice fiecărei sarcini. Mai multe resurse fizice nu păstrează automat o limită declarată mai mică. Comparația depinde de limitele pe care programul și mediul de execuție le aplică efectiv.
O configurație din valori frecvente modifică multe declarații
Pentru comparație am combinat cea mai frecventă valoare explicită din fiecare dintre cele patru câmpuri.
| Câmp | Valoare în configurația de comparație |
|---|---|
| Procesoare | 2 |
| Memorie | 4.096 MB |
| Stocare | 10.240 MB |
| GPU-uri | 0 |
Am alcătuit această combinație pentru analiză. Ea nu reprezintă o setare implicită din Harbor, o recomandare de furnizor sau o implementare observată. Valorile sunt frecvente individual. Frecvența combinației complete poate fi diferită.
Pentru fiecare sarcină am verificat dacă cel puțin o valoare explicită depășește valoarea de comparație din același câmp. Acest lucru se întâmplă la 38 din 66 de sarcini. Pe câmpuri, sunt 22 pentru procesoare, 31 pentru memorie, 17 pentru stocare și trei pentru numărul de GPU-uri. Grupurile se suprapun, așa că adunarea lor ar număra unele sarcini de mai multe ori. Rezultatele comparației includ identificatorii exacți pentru reuniunea grupurilor și pentru fiecare câmp.
Pentru celelalte 28 de sarcini, valorile înregistrate nu depășesc niciuna dintre cele patru valori de referință. Aceasta nu le confirmă compatibilitatea cu configurația. Opt sarcini omit numărul de GPU-uri, iar analiza păstrează câmpul ca omis. Fișierele, containerele auxiliare, imaginile și serviciile pot adăuga cerințe dincolo de cele patru câmpuri.
Pentru rulări fără GPU, întreținătorii oferă în Terminal-Bench 4.1.0 un set separat de 63 de sarcini care folosesc numai CPU. Rulează-l cu harbor run -d terminal-bench/terminal-bench-cpu-only@4.1.0 și indică rezultatele lui separat de scorurile versiunii complete de 66 de sarcini. Includerea în set nu dovedește că sarcina respectă o anumită limită de procesoare, memorie sau stocare.
Înainte să rulezi benchmarkul, verifică în lista de excepții ce setări ar modifica un mediu standardizat.
Programul de rulare și mediul de execuție interpretează declarația
Fișierul sarcinii descrie doar o parte din configurația de evaluare. Ca să înțelegem cum sunt folosite declarațiile, am analizat o revizie fixă din Harbor în care metadatele pachetului indică versiunea 0.26.0.
În codul examinat, opțiunile unei încercări pot înlocui valorile resurselor din sarcină. Regulile pentru procesoare și memorie pot stabili și dacă valorile sunt aplicate sau ignorate. Analizorul lasă nesetate valorile omise pentru procesoare, memorie și stocare. Mediul de bază tratează numărul omis de GPU-uri drept zero efectiv. Analiza păstrează omisiunile inițiale pentru a distinge ce scrie în sarcină de interpretarea programului de rulare. Logica mediilor din revizia analizată a Harbor
Mediul de execuție influențează și el rezultatul. Adaptorul Docker examinat transformă regulile automate pentru procesoare și memorie în limite. Ignoră explicit alegerea tipului de GPU, iar codul care scrie resursele pentru Compose nu stabilește o limită de stocare. Trei sarcini declară explicit un H100. Câmpul nu dovedește singur că Docker alocă un astfel de GPU. În mod similar, valoarea storage_mb singură nu stabilește o limită de disc în Docker. Configurația Compose poate adăuga constrângeri, iar alte medii pot trata valorile diferit. Adaptorul Docker · Codul care scrie resursele Compose
Ca evaluarea să poată fi repetată, păstrează declarația și notează cum a aplicat-o mediul ales. Setarea cerută și alocarea efectivă răspund la întrebări diferite.
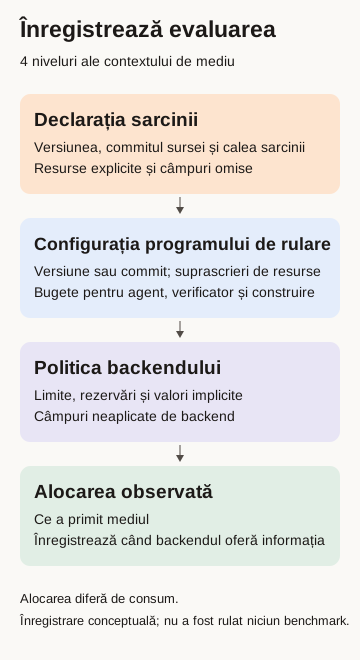
Notează setările cerute și alocările observate în câmpuri separate.
Înregistrează separat limitele de timp ale agentului și setările de verificare
Toate cele 66 de fișiere stabilesc explicit limita de timp a agentului la 28.800 de secunde, adică opt ore. Aceasta este o limită configurată. Limitele declarate pentru verificare sunt între 60 și 18.000 de secunde, iar cele pentru pregătirea mediului, între 300 și 18.000 de secunde. Estimează durata unei sarcini ținând cont de fiecare etapă separat.
Programul de rulare examinat poate înlocui limitele de timp și poate aplica valori maxime și multiplicatori. În funcția analizată, valoarea maximă se aplică înaintea multiplicatorului. Analiza nu adună limitele etapelor pentru a prezice timpul total scurs. Stabilirea limitelor în revizia analizată · Calculul bugetului de timp pe etape
Am calculat limitele de timp pentru verificarea tuturor celor 66 de sarcini din Terminal-Bench v4.1.0, folosind regulile din versiunea Harbor pe care am analizat-o. Am încercat separat o valoare maximă de 600 de secunde și înlocuirea limitei cu 600 de secunde. În ambele cazuri, multiplicatorul a fost 1. Cea mai mare limită calculată a fost de 600 de secunde pentru ambele setări. Valoarea maximă a păstrat cele 28 de limite mai scurte. Înlocuirea le-a mărit pe toate cele 28 la 600 de secunde. Ca să păstrezi limitele mai scurte în această configurație, folosește valoarea maximă și înregistrează setarea folosită. Cum alege Harbor limita de timp inițială · Cum aplică Harbor valoarea maximă și multiplicatorul
Limita de timp a jobului poate opri un agent care rulează local înainte ca agentul să-și atingă propria limită. De exemplu, dacă agentul are opt ore la dispoziție pentru o sarcină, nu le poate folosi pe toate într-un job găzduit de GitHub cu o limită de șase ore. Pregătirea din același job consumă și ea din timpul disponibil. Înregistrează separat limita de timp a jobului și pe cea a agentului.
Toate sarcinile aleg explicit verificarea separată. Șase furnizează un bloc pentru mediul verificatorului. Funcția analizată din Harbor selectează un bloc explicit în întregime, fără să îi combine câmpurile cu ale mediului sarcinii. În lipsa blocului, copiază mediul sarcinii. Opțiunile fiecărei încercări pot modifica în continuare configurația efectivă a verificatorului. Alegerea mediului verificatorului
Înregistrează separat setările agentului și ale verificatorului, chiar dacă se potrivesc. Verificarea separată nu precizează singură alocarea efectivă și nici dacă ambele medii folosesc resurse în același timp.
Am comparat declarații privind procesoarele, memoria, stocarea, GPU-urile, limitele de timp și modul de verificare între Terminal-Bench 4.0 și 4.1 pentru cele 66 de sarcini cu aceleași nume și căi. Comparația a identificat două sarcini cu modificări în aceste câmpuri. Pentru distributed-dedup, limita de timp a verificatorului a crescut de la 1.800 la 3.900 de secunde. Pentru payments-pipeline-fix, valorile explicite ale verificatorului au crescut de la 6 procesoare și 12.288 MB la 8 procesoare și 16.384 MB. Acestea sunt valori declarate. Notele versiunii 4.1 spun că toate cele 66 de sarcini au fost modificate. Comparația limitată nu stabilește dacă instrucțiunile, imaginile sau verificatoarele sunt echivalente.
Descarcă compare-versions.py și census.json în același dosar. Cu Python 3.11 sau mai nou și acces la internet, rulează python3 compare-versions.py > comparison.json din acel dosar. Scriptul preia registrul fix al versiunii 4.0 și metadatele sarcinilor fără a executa sarcinile. Raportul local păstrează atribuirea și solicitarea proiectului de a exclude datele benchmarkului din seturile de antrenare.
Ce să păstrezi când schimbi configurația evaluării
Analiza oferă un punct de plecare pentru un registru scurt al configurației.
- Fixează setul de sarcini. Păstrează împreună manifestul versiunii, revizia sursei și căile sarcinilor. Numărul fișierelor din întregul depozit poate include materiale din afara versiunii.
- Păstrează declarațiile originale. Notează valorile explicite și omisiunile, inclusiv setările separate ale verificatorului și limitele de timp pe etape.
- Înregistrează programul de rulare și opțiunile. Păstrează versiunea sau revizia exactă și opțiunile care înlocuiesc ori multiplică valorile sarcinilor.
- Verifică regulile mediului de execuție. Identifică ce câmpuri devin limite, rezervări, valori implicite sau cereri fără suport.
- Notează alocarea efectivă când este observabilă. Păstreaz-o separat de configurația cerută și de consumul măsurat în timpul rulării.
Dacă schimbi intenționat o limită ori o alocare, documentează modificarea lângă rezultat. Un cititor va putea înțelege condițiile de evaluare și va putea ține cont de diferențele dintre medii.
Comparația configurațiilor și codul analizei permit verificarea excepțiilor. sapien1 analizează sarcinile și mediile astfel atunci când definește un proiect de evaluare a agenților.
Pentru a compara alte limite, descarcă filtrul de resurse și datele analizei în același dosar. De exemplu, python3 filter-census.py --cpus 4 --memory-mb 8192 --status within afișează sarcinile ale căror declarații se încadrează în aceste limite, atât pentru sarcină, cât și pentru verificator. Rezultatul păstrează omisiunile și nu stabilește singur dacă o sarcină va rula. Terminal-Bench cere ca datele benchmarkului să fie ținute în afara seturilor de antrenare.
Compară sarcinile selectate pentru fiecare set de limite
Fiecare dintre cele două seturi de limite de resurse din exemplu selectează 44 dintre cele 66 de sarcini din Terminal-Bench v4.1.0. Listele au 36 de sarcini în comun și câte 8 sarcini care apar doar în lista respectivă. Pentru fiecare set de limite, filtrul verifică valorile declarate pentru procesoare, memorie și stocare separat în mediul sarcinii și în mediul de verificare.
| Procesoare | Memorie (MB) | Stocare (MB) | Sarcini care respectă toate cele trei limite |
|---|---|---|---|
| 4 | 8.192 | 10.240 | 44 |
| 2 | 16.384 | 20.480 | 44 |
Rulează ambele comenzi din dosarul care conține filtrul și fișierul de inventar. În fiecare raport, câmpurile task din records indică ID-urile sarcinilor selectate.
python3 filter-census.py --cpus 4 --memory-mb 8192 \
  --storage-mb 10240 --phases both --status within > ceiling-4cpu.json

python3 filter-census.py --cpus 2 --memory-mb 16384 \
  --storage-mb 20480 --phases both --status within > ceiling-2cpu.json
Când raportezi un scor, salvează ID-urile exacte ale sarcinilor împreună cu versiunea benchmarkului și setările de resurse. Dacă compari două rulări pe baza sarcinilor comune, calculează ambele scoruri folosind aceeași listă.
Metodă și domeniu
Pe 17 noiembrie 2026 am încheiat analiza tuturor declarațiilor de configurare dintr-o singură versiune. Analiza descrie declarațiile și nu măsoară performanța. Revizia sursă a setului Terminal-Bench este 4070d6c. Revizia Harbor examinată este ec6aeab, identificată ca versiunea 0.26.0 în metadatele proiectului. Metodologia conține amprentele criptografice complete, linkurile către surse, regulile de extragere și comenzile pentru repetarea analizei.
Scriptul de colectare citește manifestul oficial și 66 de fișiere TOML, însumând 85.966 de octeți la sursă. Păstrează separat câmpurile de versiune și caută denumiri alternative mai vechi pentru resurse, pași și blocuri suplimentare de mediu. În această versiune nu a găsit pași sau denumiri alternative vechi. Fișierele publice descărcabile conțin informații de configurare selectate și amprentele surselor. Nu includ instrucțiuni, soluții ori medii complete ale sarcinilor.
Am verificat independent componența manifestului, calculele și exemple din surse pentru o valoare atipică, un câmp GPU omis și un bloc explicit de verificare. Nu am executat modele, containere sau sarcini ale benchmarkului.